在 Verilog实现16进制到10进制(BCD)转换(1)加减计数法 文章中,介绍了如果使用一个基本的算法实现16进制数据到bcd 码的转换。通过实验,我们发现这个算法比较简单,但是计算时间很长。 尤其是当输入的数据比较大的情况下, 计算需要很多个时钟周期。 本文针对上述的算法的不足, 做了一些改进,可以在比较短的时间内,快速实现16进制到bcd码的转换。
代码实体:
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 122 123 124 125 126 127 128 129 130 131 132 133 134 135 136 137 138 139 140 141 142 143 144 145 146 147 148 149 150 151 152 153 154 155 156 157 158 159 160 161 162 163 164 165 166 167 168 169 170 171 172 173 174 175 |
module hex2bcd ( input rst, input clk, input cal_req, input [ 19: 0 ] indata, output reg[ 3: 0 ] out0_BCD, output reg[ 3: 0 ] out1_BCD, output reg[ 3: 0 ] out2_BCD, output reg[ 3: 0 ] out3_BCD, output reg[ 3: 0 ] out4_BCD, output reg[ 3: 0 ] out5_BCD, output reg cal_done ); reg [ 19: 0 ] tmpa; reg [ 19: 0 ] tmpa_r; reg cal_req_r; reg cal_got; reg cal_update; reg [ 3: 0 ] tmp0_BCD; reg [ 3: 0 ] tmp1_BCD; reg [ 3: 0 ] tmp2_BCD; reg [ 3: 0 ] tmp3_BCD; reg [ 3: 0 ] tmp4_BCD; reg [ 3: 0 ] tmp5_BCD; reg [ 1: 0 ] cal_st; // data capture, assume indata and cal_req are synchronized with clk, // otherwise synchronization should be done first always@( posedge clk or posedge rst ) if ( rst ) begin tmpa <= 0; cal_req_r <= 1'b0; end else begin if ( cal_req ) begin tmpa <= indata; cal_req_r <= 1'b1; end else if ( cal_got ) cal_req_r <= 0; end //==================== always@( posedge clk or posedge rst ) if ( rst ) begin tmp0_BCD <= 0; tmp1_BCD <= 0; tmp2_BCD <= 0; tmp3_BCD <= 0; tmp4_BCD <= 0; tmp5_BCD <= 0; tmpa_r <= 0; cal_got <= 0; cal_update <= 0; cal_st <= 0; end else begin case ( cal_st ) 0: begin tmp0_BCD <= 0; tmp1_BCD <= 0; tmp2_BCD <= 0; tmp3_BCD <= 0; tmp4_BCD <= 0; tmp5_BCD <= 0; cal_got <= 0; cal_update <= 0; tmpa_r <= 0; if ( cal_req_r ) cal_st <= 1; end 1: begin cal_got <= 1'b1; tmpa_r <= tmpa; cal_st <= 2; end 2: begin cal_got <= 0; if ( tmpa_r == 0 ) cal_st <= 3; else begin if(tmpa_r >= 10_0000) begin tmpa_r <= tmpa_r - 10_0000; tmp5_BCD <= tmp5_BCD + 1; end else if(tmpa_r >= 1_0000) begin tmpa_r <= tmpa_r - 1_0000; tmp4_BCD <= tmp4_BCD + 1; end else if(tmpa_r >= 1000) begin tmpa_r <= tmpa_r - 1000; tmp3_BCD <= tmp3_BCD + 1; end else if(tmpa_r >= 100) begin tmpa_r <= tmpa_r - 100; tmp2_BCD <= tmp2_BCD + 1; end else if(tmpa_r >= 10) begin tmpa_r <= tmpa_r - 10; tmp1_BCD <= tmp1_BCD + 1; end else if(tmpa_r >= 1) begin tmpa_r <= tmpa_r - 1; tmp0_BCD <= tmp0_BCD + 1; end end end 3: begin cal_update <= 1'b1; cal_st <= 0; end default: cal_st <= 3; endcase end //=====================update always@( posedge clk or posedge rst ) if ( rst ) begin out0_BCD <= 0; out1_BCD <= 0; out2_BCD <= 0; out3_BCD <= 0; out4_BCD <= 0; out5_BCD <= 0; cal_done <= 1'b0; end else begin cal_done <= 1'b0; if ( cal_update ) begin out0_BCD <= tmp0_BCD; out1_BCD <= tmp1_BCD; out2_BCD <= tmp2_BCD; out3_BCD <= tmp3_BCD; out4_BCD <= tmp4_BCD; out5_BCD <= tmp5_BCD; cal_done <= 1'b1; end end endmodule |
通过对输入的数据的大小,比较输入数据是否 > 10_0000, 1_0000, 1000, 100, 10 , 1 等, 根据数据的大小,可以直接减去 10_0000, 1_0000, 1000, 100, 10, 1 而不必每次减一,这样就加快了算法的速度。
仿真文件如下:
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 |
`timescale 1ns / 1ps module test_sim( ); reg rst = 1; reg clk = 0; always #5 clk = ~clk; reg cal_req = 0; reg [ 19: 0 ] indata = 0; wire [ 3: 0 ] out0_BCD; wire [ 3: 0 ] out1_BCD; wire [ 3: 0 ] out2_BCD; wire [ 3: 0 ] out3_BCD; wire [ 3: 0 ] out4_BCD; wire [ 3: 0 ] out5_BCD; wire cal_done; initial begin rst = 1; #10; rst = 0; #20; @(posedge clk); indata = 0; cal_req = 1; @(posedge clk); cal_req = 0; while (!cal_done) @(posedge clk); indata = 23; cal_req = 1; @(posedge clk); cal_req = 0; while (!cal_done) @(posedge clk); indata = 999; cal_req = 1; @(posedge clk); cal_req = 0; while (!cal_done) @(posedge clk); indata = 2323; cal_req = 1; @(posedge clk); cal_req = 0; while (!cal_done) @(posedge clk); indata = 54689; cal_req = 1; @(posedge clk); cal_req = 0; while (!cal_done) @(posedge clk); indata = 999999; cal_req = 1; @(posedge clk); cal_req = 0; while (!cal_done) @(posedge clk); #200; $stop; end hex2bcd hex2bcd_inst ( .rst (rst), .clk (clk), .cal_req (cal_req), .indata (indata), .out0_BCD (out0_BCD), .out1_BCD (out1_BCD), .out2_BCD (out2_BCD), .out3_BCD (out3_BCD), .out4_BCD (out4_BCD), .out5_BCD (out5_BCD), .cal_done (cal_done) ); endmodule |
仿真波形如下:
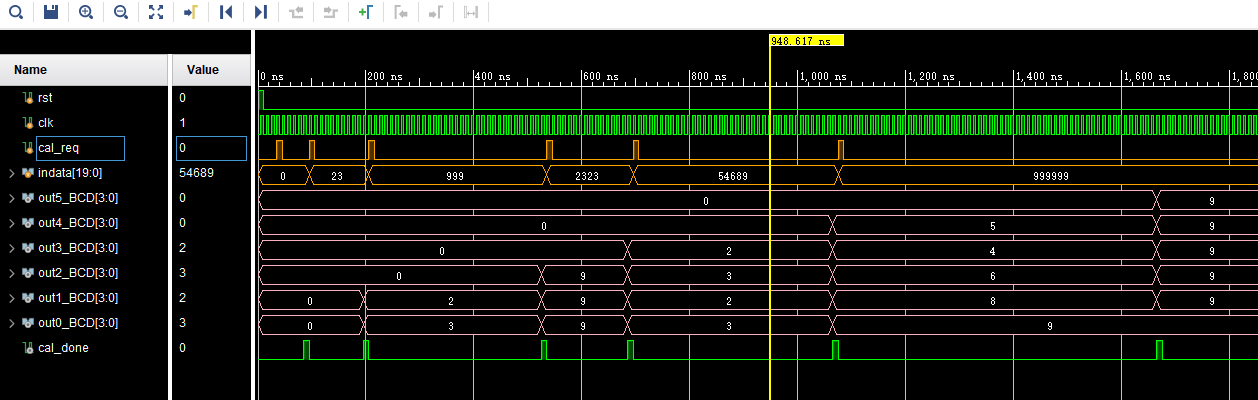
这个算法必之前的算法提高了很多,但是还是有些问题值得注意, 比如 999 的计算实践 大于 2323的计算时间 等。 所以,我们还有改进的空间。