提高数字系统设计性能–数字设计算法与Verilog设计技巧一
我们知道在CPU芯片和数字系统设计中,都是在时序控制下完成的,时序电路的基本结构如下图所示:
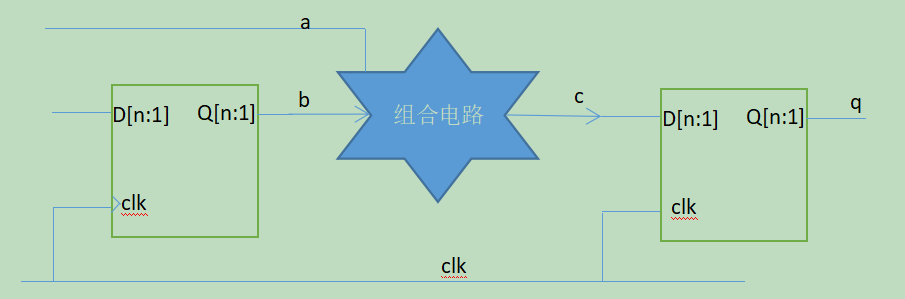
图1 组合时序电路
如果该电路能稳定输出正确结果,首先要保证时序上满足要求。该电路分析如下,a,b作为组合电路的输入端,b为寄存器输出,其更新时间间隔为1个clk的时钟周期,a是来自别的电路输出。假设clk的频率为100Mhz, 一个clk的时钟周期为10ns。如果q要得到稳定输出,就要满足b稳定后,c能否在一个clk周期内稳定,而且还能给出一定的时间余量(c到寄存器需要满足setup time和hold time)。我们知道组合电路都是由门电路级联而成,级联的级数越多,组合电路从给定输入到稳定输出时间越长,由此时钟周期就需要加长,时钟的频率需要降低才能满足要求。我们以4位全加器为例分析影响主频的因素和原理,并提出解决办法。
一位全加器:
真值表
| 输入 | 输出 | |||
| a | b | ci | y | co |
| 0 | 0 | 0 | 0 | 0 |
| 0 | 0 | 1 | 1 | 0 |
| 0 | 1 | 0 | 1 | 0 |
| 0 | 1 | 1 | 0 | 1 |
| 1 | 0 | 0 | 1 | 0 |
| 1 | 0 | 1 | 0 | 1 |
| 1 | 1 | 0 | 0 | 1 |
| 1 | 1 | 1 | 1 | 1 |
经过化简逻辑表达式如下:
|
1 2 |
y = ci & (~(a ^ b) ) | ( ~ci & (a ^ b) ); (1) = ci ^ a ^ b; |
公式(1)中 符号~表示取反,^表示异或
|
1 |
co = ( a & b ) | ( ci & (a ^ b) ); (2) |
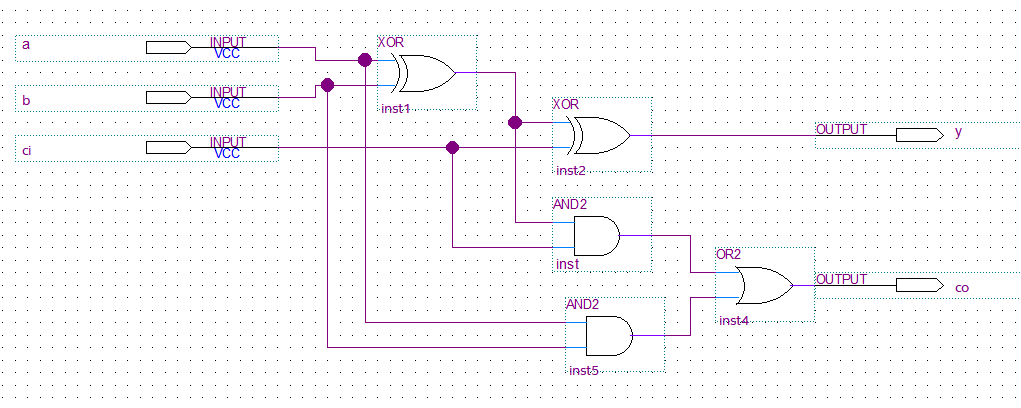
图2 一位全加器

图3 四位全加器
从图2可以看出从ci 到co,一位全加器经过3级门延时,,从图3 可以看出4位全加器的门电路延时总计可以达到12级。如果是8位全加器,则总延时可以达到24级。如果每级门电路按0.5ns延时计算,最终可达12ns,这显然不能满足100Mhz时钟的要求。因此想提高整体电路的性能,还要从算法上入手减少电路级联的数目。
从电路上看,无论是1位全加器还是4位全加器,主要器件都是异或门和与门构成,可不可以考虑用代换的方式去掉多级级联呢?数学上已经成功解决了此类问题。
假设令
x = a ⊕ b ;
p = a ⋅ b ;
则
yi = ai ⊕ bi ⊕ ci = xi ⊕ c i ; (3)
coi = aibi + coi-1(ai ⊕ bi) = pi + coi-1xi ; (4)
根据式(3),(4)可以推导如下:
y0 = a0 ⊕ b0 ⊕ cin = x0 ⊕ cin ;
c0 = a0b0 + cin(a0⊕ b0) = p0 + cinx0 ;
y1 = a1 ⊕ b1 ⊕ c0 = x1 ⊕ c0 ;
c1 = a1b1 + c0(a1 ⊕ b1) = a1b1 + (a0b0 + cin(a0 ⊕ b0) )(a1 ⊕ b1) = p1 + p0x1 + cinx0x1 ;
y2 = a2 ⊕ b2 ⊕ c1 = x2 ⊕ c1 ;
c2 = a2b2 + c1(a2 ⊕ b2) = a2b2 + (p1 + p0x1 + cinx0x1)(a2 ⊕ b2) = p2 + p1x2 + cinx0x1x2 ;
y3 = a3 ⊕ b3 ⊕ c2 = x3 ⊕ c2 ;
c3 = a3b3 + c2(a3 ⊕ b3) = a3b3 + (p2 + p1x2 + cinx0x1x2)(a3 ⊕ b3) = p3 + p2x3 + p1x2x3 + cinx0x1x2x3 ; (5)
从上面推导可以看出,对于级联型的电路,特别是加法器,乘法器,除法器,CRC等含有级联的电路都可以用类似的方法推导消除级联。从式(5)可以看出,用替代法成功的将原来的12级变成3级级联。对于16位全加器,几乎可以把延迟缩短一个数量级。可见算法对于提高电路性能还是非常重要的。我们把这种全加器称为4位超前进位全加器,其中c3的电路如下图:
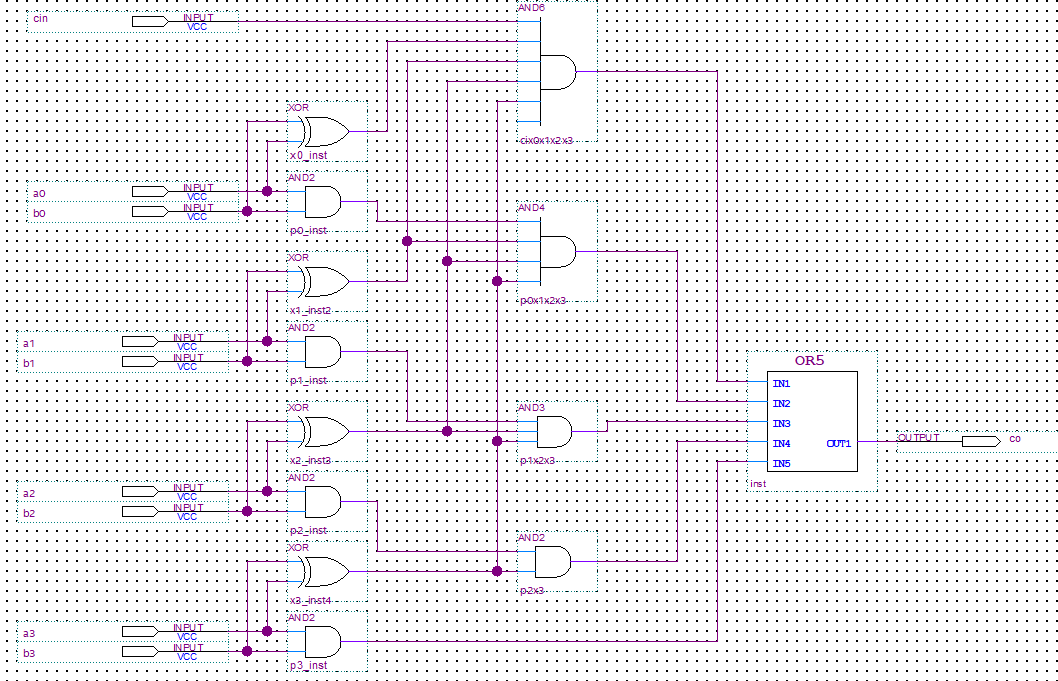
图4 四位超前进位全加器电路图
从图4中可以清晰的看出,co的级联阶数只有3级。
Verilog 描述如下:
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 |
module fadd4 ( input ci, input [3:0] a, input [3:0] b, output [3:0] y, output co ); wire [3:0] x; wire [3:0] c; wire [3:0] p; assign x = a ^ b; assign p = a & b; assign y[0] = x[0] ^ ci; assign c[0] = p[0] | (ci & x[0]); assign y[1] = x[1] ^ c[0]; assign c[1] = p[1] | (p[0] & x[1]) | (ci & x[0] & x[1]); assign y[2] = x[2] ^ c[1]; assign c[2] = p[2] | (p[1] & x[2]) | (p[0] & x[1] & x[2]) | (ci & x[0] & x[1] & x[2]); assign y[3] = x[3] ^ c[2]; assign c[3] = p[3] | (p[2] & x[3]) | (p[1] & x[2] & x[3]) | (p[0] & x[1] & x[2] & x[3]) | (ci & x[0] & x[1] & x[2] & x[3]); /* assign y[1] = x[1] ^ c[0]; assign c[1] = p[1] | (c[0] & x[1]); assign y[2] = x[2] ^ c[1]; assign c[2] = p[2] | (c[1] & x[2]); assign y[3] = x[3] ^ c[2]; assign c[3] = p[3] | (c[2] & x[3]); */ assign co = c[3]; endmodule |
仿真工程:
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 |
`timescale 1ns / 1ps module tb ( ); reg clk = 0; always #5 clk = ~clk; reg [4:0] a = 0; reg [4:0] b = 0; wire [3:0] y; wire co; initial begin for (a = 0; a < 16; a = a + 1) begin for (b = 0; b < 16; b = b + 1) begin #10; end end #200; $stop; end fadd4 fadd4_inst ( .ci (1'b0), .a (a[3:0]), .b (b[3:0]), .y (y), .co (co) ); endmodule |
仿真波形:
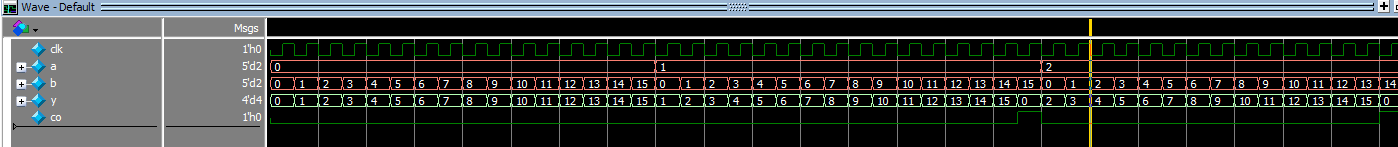
图5
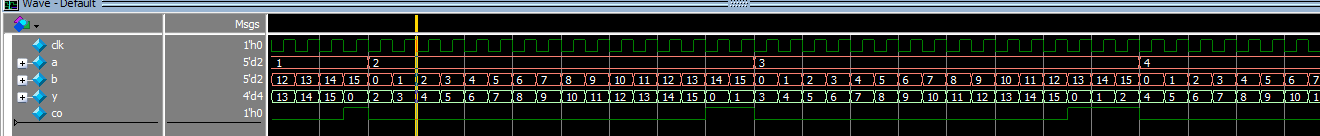
图6
综合原理图:
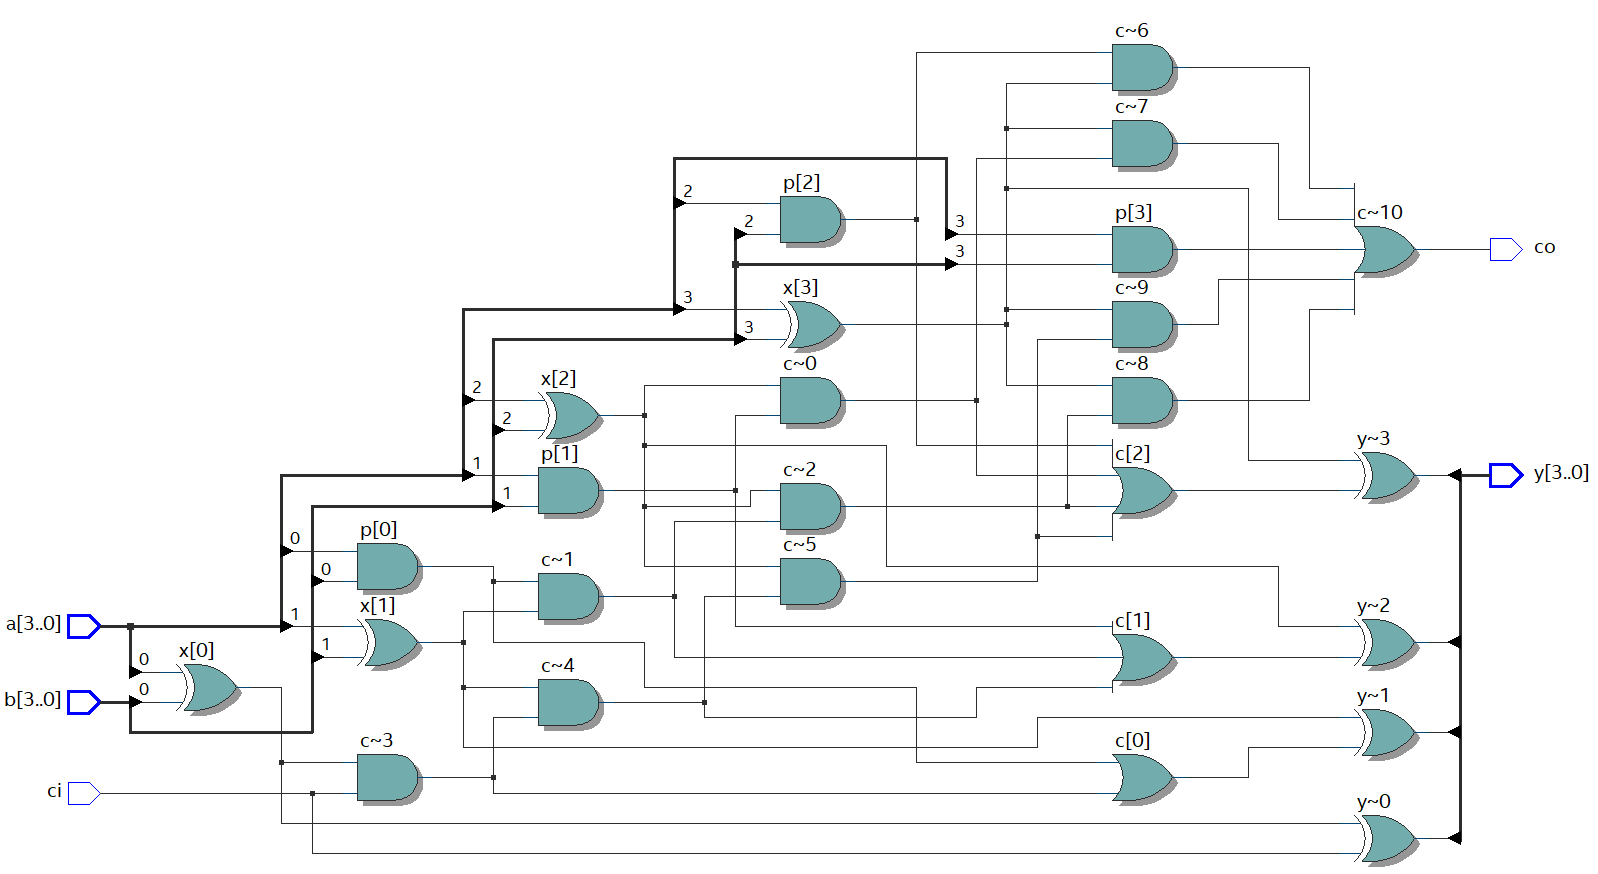
图7
quartus 布局图:
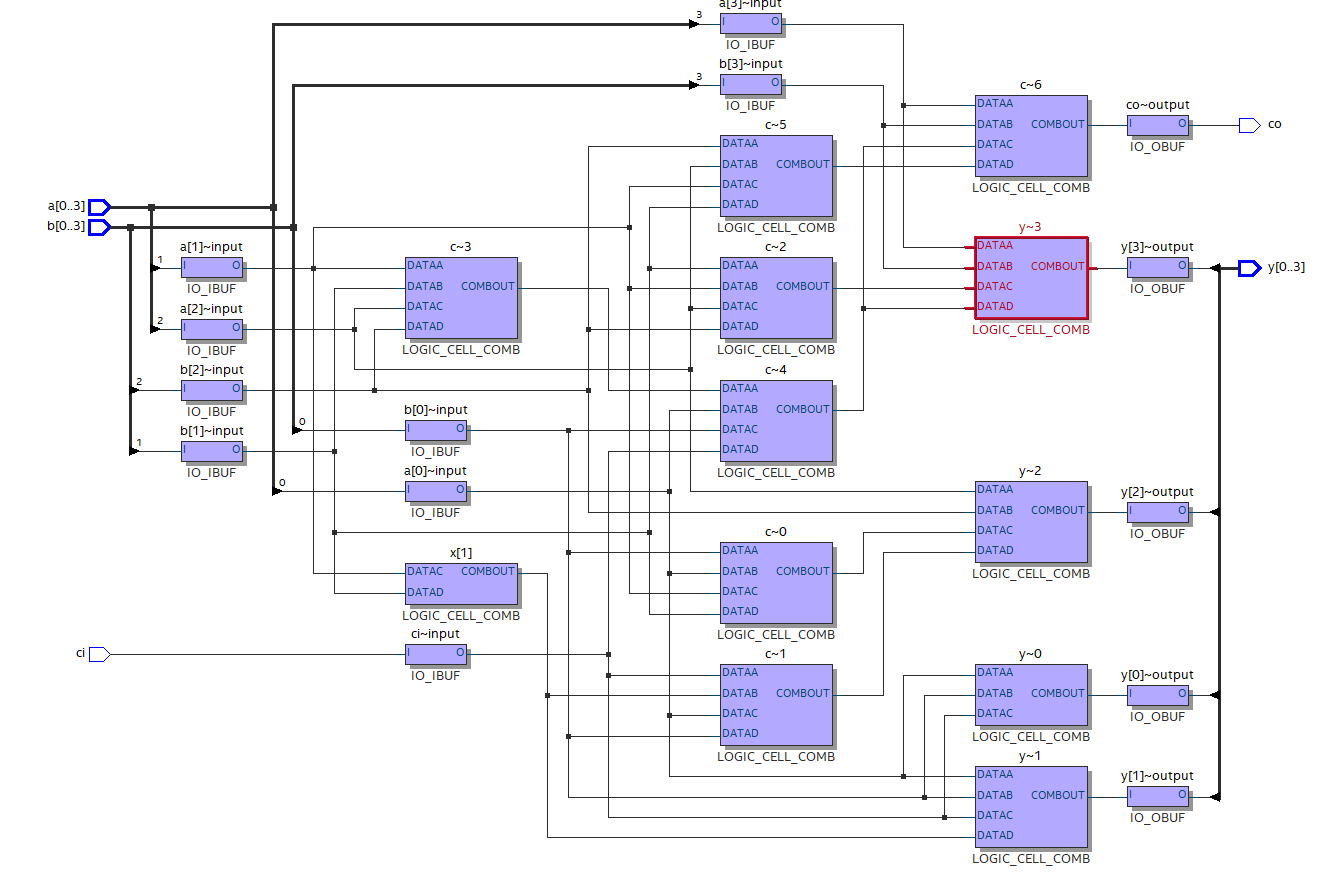
图8
总结: (1)找出逻辑中的延迟关键路径如从ci到co。
- 用替代的方法消除电路中的递归,将逻辑合并。
提高逻辑电路性能还有其它方法,在后续的文章中介绍。
quartus 工程文件:
[content_control]
[/content_control]
对应视频: