DPU企业:Xsight Labs——以800G E1 DPU进军AI与云数据中心
Xsight Labs是一家专注于数据中心网络芯片、DPU(Data Processing Unit,数据处理器)和可编程以太网交换芯片的无晶圆厂半导体公司,成立于2017年。
公司早期主要因X系列数据中心交换芯片受到关注,但随着AI数据中心对高速网络、RDMA、存储和基础设施卸载需求迅速增长,Xsight Labs又推出E系列DPU,并在2025年正式将800Gbps E1 DPU推向市场。
截至2026年,公司已经形成“X系列交换芯片 + E系列DPU”的双产品体系,目标是为AI数据中心、Hyperscaler、云计算、电信运营商和边缘计算平台提供开放、低功耗和高度可编程的网络基础设施。
因此,Xsight Labs今天已经可以明确归入DPU企业,而不再只是传统意义上的交换芯片公司。
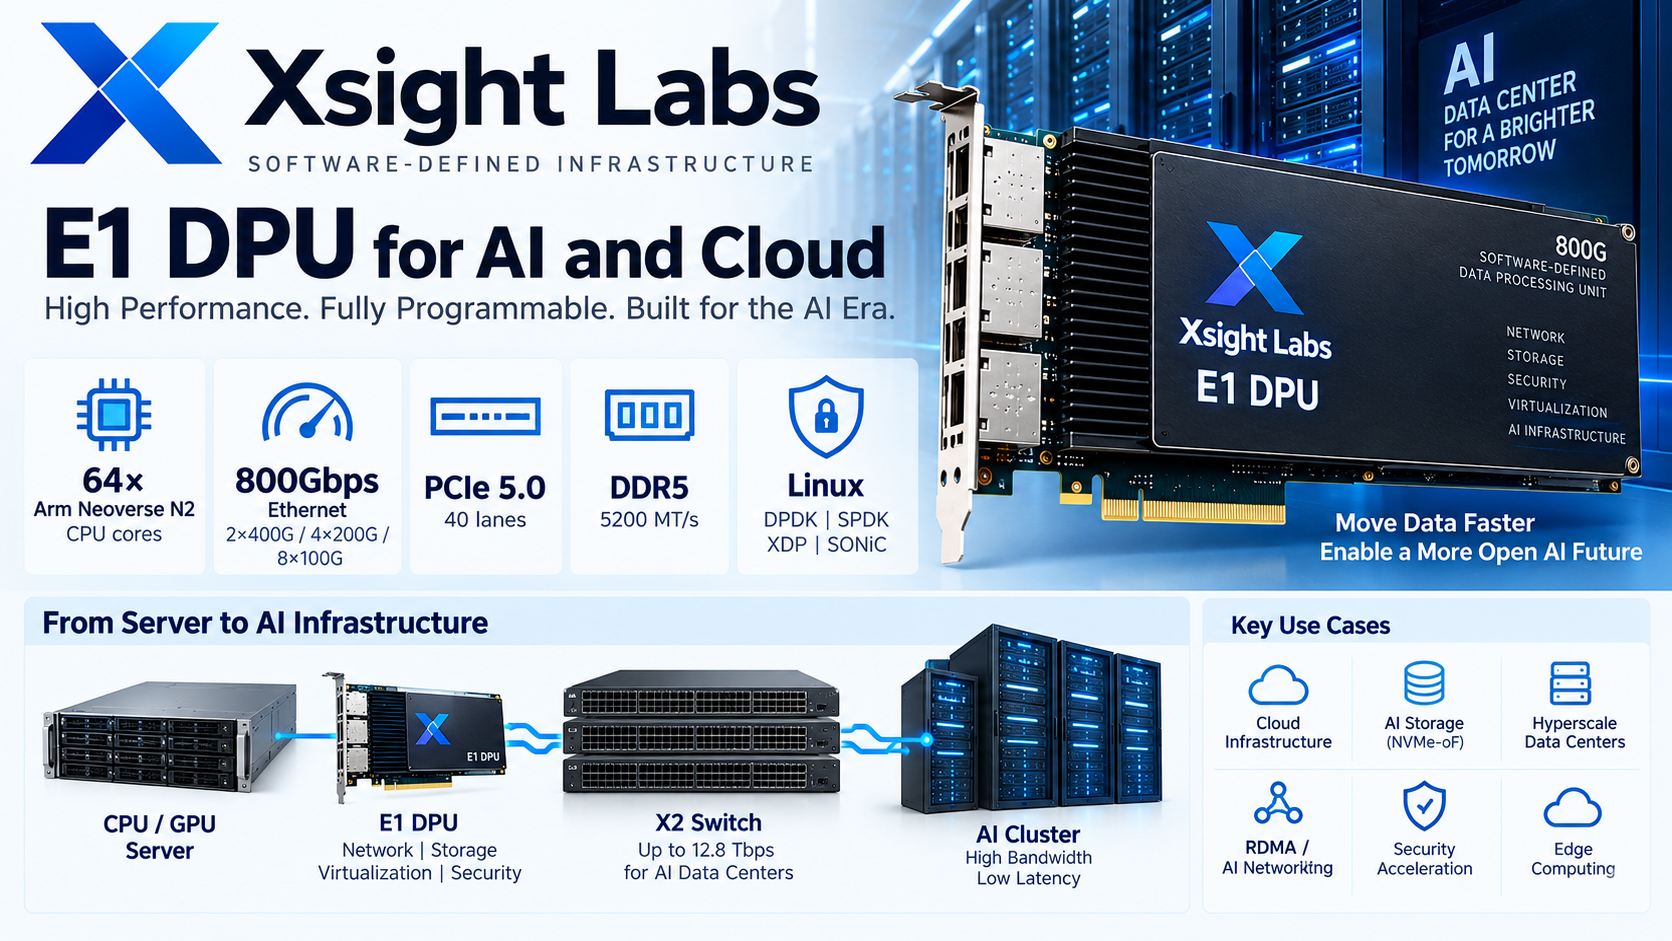
其最有代表性的DPU产品是E1。
这是一颗采用TSMC 5nm工艺制造、集成64个Arm Neoverse N2 CPU核心、拥有800Gbps网络吞吐能力的高性能DPU。
Xsight Labs最大的技术特点,是没有像许多传统DPU那样主要依靠固定功能硬件Fast Path,再把复杂数据包交给少量CPU核心处理。
而是直接把64个Arm核心放进数据路径,让这些通用处理器能够参与所有网络数据包处理。公司把这种设计称为完全软件定义的DPU架构。
Xsight Labs是什么公司?
Xsight Labs成立于2017年,是一家Fabless无晶圆厂半导体公司,主要开发面向AI和超大规模数据中心的网络连接芯片。
公司目前拥有超过250名员工,并已经累计融资超过7.5亿美元。
其投资者包括Fidelity Management & Research、AMD Ventures、Intel Capital、Battery Ventures、T. Rowe Price以及多家半导体和投资机构。
Xsight Labs最初的发展重点其实不是DPU,而是数据中心交换芯片。
公司早期推出X1交换芯片,随后发展到第二代X2。
X2采用TSMC 5nm工艺,最高提供12.8Tbps交换能力,并支持100G PAM4 SerDes,可以组成32×400GbE或者16×800G端口配置。
Xsight Labs希望利用高度可编程的X-Switch架构,与传统固定流水线Ethernet Switch ASIC形成区别。
随着AI集群越来越依赖高速网络,Xsight Labs开始把交换芯片经验向服务器侧扩展,并形成E系列DPU。
这样一来,公司就能够同时处理数据中心网络的两个关键位置:
X系列负责服务器之间的数据交换。
E系列DPU负责服务器内部以及服务器与网络之间的数据处理。
这种“Switch + DPU”的产品组合,使Xsight Labs与只开发SmartNIC或者单一DPU的初创公司有所不同。
E1:Xsight Labs的核心DPU
E1是Xsight Labs目前最核心的DPU产品。
E1拥有800Gbps网络吞吐能力,可以配置为2×400GbE、4×200GbE或者8×100GbE等不同网络组合,并集成64个Arm Neoverse N2核心。
芯片采用Armv9.0-A架构,同时拥有32MB三级缓存和4通道DDR5-5200内存接口。
E1还集成PCIe 5.0接口,总计拥有40条PCIe Gen5通道,并支持SR-IOV和Scalable IOV,可以用于连接服务器CPU、GPU、SSD以及其他PCIe设备。
对于DPU来说,这一点非常重要。
DPU并不只是“连接网络”。它实际上位于:CPU,GPU,SSD,高速网络 这些不同设备之间。
因此,一颗真正高性能的DPU不仅需要高速Ethernet SerDes,还需要非常强的PCIe数据移动能力。
800Gbps意味着什么?
800Gbps是E1最引人注意的参数之一。
普通企业服务器现在仍然大量使用25G、50G或者100G网络,而高端AI服务器已经快速进入400G和800G时代。
大型语言模型训练时,可能需要数千甚至数万块GPU不断交换梯度、参数和中间数据。
GPU越来越快以后,网络反而越来越容易成为瓶颈。
E1提供总计800Gbps网络带宽,可以直接配置成两条400GbE链路。
这意味着它的目标市场已经不是传统企业网卡,而是AI集群、Hyperscaler、HPC以及下一代高性能云数据中心。
64个Arm Neoverse N2核心
E1另外一个非常突出的设计,是集成64个Arm Neoverse N2核心。
很多DPU也包含Arm CPU,但是这些CPU往往主要运行控制软件或者负责复杂数据包的Slow Path。
高速数据包仍然由固定功能ASIC完成。
Xsight Labs采取了一条不同路线。
E1直接把64个Arm核心放进数据路径。
也就是说,这些CPU不是DPU旁边的辅助控制器,而是真正参与数据包处理。
Xsight Labs把这种设计描述为:There is no slow path。
也就是说,没有传统意义上需要把复杂数据包从高速硬件路径“甩给”慢速CPU处理的架构。
所有数据流都可以进入Arm核心组成的可编程数据处理系统。
为什么“没有Slow Path”很重要?
传统网络ASIC通常使用固定流水线。
常见数据包可以非常快速地完成处理。
但是如果出现硬件没有提前定义的协议、复杂网络功能或者新的安全规则,就可能需要把数据包交给CPU。
问题在于:
网络已经达到400G甚至800G。
少量CPU很难处理这种规模的数据流。
如果大量数据进入Slow Path,DPU性能就可能突然下降。
E1试图通过64个高性能Arm核心解决这个问题。
所有CPU都处于On-Path,也就是数据路径内部,因此复杂网络功能可以直接使用软件编程,而不一定必须重新设计ASIC。
这也是Xsight Labs把E1称为“Fully Software-Defined DPU”的核心原因。
标准Linux而不是专有SDK
E1另外一个非常有吸引力的特点,是使用标准Linux开发环境。
很多DPU需要厂商自己的SDK。
例如不同芯片可能需要专门的P4编译器、网络API或者专用开发环境。
Xsight Labs则希望开发者直接使用熟悉的软件工具。
E1支持:
XDP。
DPDK。
SPDK。
SONiC。
开发者可以使用现有Linux软件和开源网络框架开发DPU应用,而不必完全依赖某个专有SDK。
这也是E1与许多传统DPU非常不同的地方。
Xsight Labs真正想卖的不只是高速硬件。
它希望把DPU变成一台高度集成的Arm服务器。
E1实际上很像一台“小型服务器”
如果仔细看E1的规格,会发现它已经越来越不像传统网卡。
DDR5内存。
800Gbps Ethernet。
PCIe Gen5。
硬件加密。
NVMe和存储处理。
RDMA。
这些组件放到一起以后,E1实际上已经是一台完整的小型Arm服务器。
区别只是它被设计成直接位于数据路径中。
因此E1既可以作为服务器内部的DPU,也可以直接作为独立Edge Server使用。Xsight Labs提供E1-Server 1RU系统,就是基于这种设计思路。
三种E1产品形态
Xsight Labs目前把E1提供为三种主要产品形态。
第一种是E1-SoC。
这是直接提供给设备厂商的DPU芯片,可以用于定制服务器、SmartNIC、存储设备或者网络设备。
第二种是E1-AIC。
AIC就是PCIe Add-In Card,也就是可以直接插入标准服务器的PCIe DPU卡。
第三种是E1-Server。
这是完整的1RU服务器系统,把E1的Arm计算能力和800G网络整合到独立设备中。
这种产品设计让E1可以覆盖非常广的市场。
它既可以是一颗芯片,也可以是一张DPU卡,还可以成为Edge Server。
E1-AIC:800G PCIe DPU卡
E1-AIC是Xsight Labs非常重要的一款产品。
2025年,Xsight Labs与Edgecore Networks合作推出基于E1的800G PCIe DPU Add-In Card。
这张DPU卡支持2×400G、4×200G或者8×100G网络配置,同时搭载64个Arm N2核心。
E1-AIC还支持多Host架构,并提供PCIe Gen5连接能力以及板载DDR5内存。
因此,它可以直接插入现有x86或者Arm服务器。
服务器厂商不必重新设计整台机器,就能够增加一颗800G DPU。
网络卸载
网络处理当然是E1最基本的工作。
现代云服务器需要处理虚拟交换、路由、NAT、防火墙、负载均衡、Overlay网络以及大量网络安全功能。
如果这些任务全部由服务器CPU完成,就会消耗大量CPU核心。
E1可以使用64个Arm核心和高速网络硬件,在DPU内部执行这些任务。
其目标应用包括Virtual Switching、SmartNIC、Distributed Load Balancer以及Network Packet Broker等。
虚拟化卸载
E1支持完整Hypervisor Offload和Bare Metal Provisioning。
这意味着云服务商可以把虚拟网络和部分基础设施服务从Host CPU迁移到DPU。
用户CPU因此可以更加专注于真正的业务应用。
这与AWS Nitro、NVIDIA BlueField、AMD Pensando以及其他大型DPU架构的基本方向一致。
对于Hyperscaler来说,这种卸载非常有经济价值。
一台服务器如果能够释放几个CPU核心并不算很多。
但是部署几十万台服务器以后,节省的CPU资源和电力成本可能非常可观。
RDMA与AI集群
E1支持RoCEv2以及面向Ultra Ethernet生态的新型传输技术。
RDMA对于AI数据中心尤其重要。
在传统TCP网络中,CPU需要参与大量数据复制和协议处理。
RDMA可以让不同服务器之间更加直接地交换内存数据。
如果服务器中存在GPU,RDMA还可以与GPU Direct等技术结合,让数据更加直接地在GPU和网络之间移动。
随着AI集群达到数千甚至数万块GPU,DPU越来越重要的任务之一,就是减少CPU在GPU通信中的参与。
存储卸载
E1不仅仅做网络。
它还支持NVMe over Fabrics和NVMe/TCP存储协议卸载,可以作为存储Initiator或者Target。
这意味着DPU可以直接参与远程NVMe存储访问。
现代AI数据中心需要读取极其庞大的训练数据。
如果GPU每次等待数据都需要经过传统x86存储服务器、CPU和多个软件层,效率会明显下降。
因此,越来越多AI基础设施开始尝试减少存储路径中的CPU和软件层。
这正是E1进入AI存储市场的重要机会。
Hammerspace选择E1用于AI存储
2025年,AI数据平台企业Hammerspace选择Xsight Labs E1用于Open Flash Platform架构。
这个方案试图减少传统存储服务器,让GPU通过高速Ethernet网络更加直接地访问Flash存储。
Hammerspace与Xsight Labs公布的方案使用E1的800Gbps网络能力连接AI存储基础设施,目标是缩短GPU与存储之间的数据路径。
这类应用很值得关注。
因为未来DPU可能不只是安装在Compute Server中。
它还可能进入:
SSD存储节点。
AI存储系统。
网络设备。
边缘服务器。
甚至交换机。
安全加速
安全也是E1的重要功能。
芯片支持AES-GCM,可以用于IPsec等网络加密,同时支持AES-XTS用于存储和内存数据保护。Xsight Labs表示这些加密操作可以在线速条件下进行,而不需要明显降低网络吞吐量。
E1还可以用于TLS、DTLS、防火墙以及安全网关等应用。
DPU特别适合做安全处理。
因为它位于服务器和外部网络之间。
数据甚至可以在进入Host CPU之前,就先由DPU完成检查和加密。
SR-IOV与64K虚拟设备
E1支持SR-IOV,并能够提供高达64K PF/VF虚拟设备。
SR-IOV是云计算中非常重要的I/O虚拟化技术。
它可以让一块物理网卡向不同虚拟机提供大量独立虚拟网卡。
DPU再结合网络、安全和虚拟化功能后,就可以为云服务商构建更加独立的基础设施处理层。
这也是DPU与普通NIC的重要区别之一。
SONiC-DASH验证
Xsight Labs非常强调E1的SONiC-DASH性能。
在完整DASH Hero 800G验证测试中,E1实现超过1400万次每秒的新连接处理,并同时保持约1.2亿条后台TCP和UDP连接,没有出现丢包。
DASH是面向分布式云网络和SmartNIC/DPU的数据面标准体系。
因此,这项验证对于E1进入Hyperscaler和云计算市场具有实际意义。
它说明E1不仅仅拥有800G物理网络接口,而且可以在复杂、有状态的云网络环境中维持高速连接处理。
为什么Xsight Labs同时做交换芯片和DPU?
这其实是Xsight Labs非常重要的战略优势。
AI网络可以大致分成两个部分。
服务器内部:
服务器之间:
Ethernet Switch。
Xsight Labs在服务器端拥有E1 DPU。
在网络端则拥有X2交换芯片。
因此,它可以同时优化:
Server → DPU → Switch → DPU → Server
整个数据路径。
这与NVIDIA的思路有一定相似之处。
NVIDIA拥有GPU、BlueField DPU、ConnectX网卡以及Spectrum Ethernet/InfiniBand交换设备。
Xsight Labs目前当然远没有NVIDIA那样完整的生态规模,但“Switch + DPU”的产品组合使其拥有比单一DPU初创企业更完整的数据中心网络布局。
X2交换芯片
X2是Xsight Labs第二代高性能以太网交换芯片。
它可以提供3.2Tbps到12.8Tbps不同配置,最高支持16×800GbE或者32×400GbE端口,采用TSMC 5nm制造。
X2最大的特点同样是可编程。
Xsight Labs开发了XISA指令集,使客户能够直接编程交换芯片中的处理引擎,而不是完全依赖固定硬件Pipeline。
X2支持SONiC、SAI和P4等开放网络技术。
因此,Xsight Labs整体产品策略非常清楚:
交换机使用X2。
服务器使用E1。
两者都强调软件定义和开放架构。
X2已经进入Starlink
Xsight Labs的交换芯片已经获得一个非常有代表性的客户。
SpaceX在2025年宣布采用Xsight Labs X2,用于下一代Starlink卫星的Terabit级路由需求。
Xsight Labs表示,X2将用于Starlink V3以及未来下一代通信系统。
虽然这并不是E1 DPU订单,但它能够说明Xsight Labs高速网络芯片已经获得大型实际部署机会。
对于一家数据中心芯片初创企业而言,这是非常重要的商业验证。
功耗只有约70W
E1还有一个非常值得注意的参数:
典型芯片功耗约70W。
对于AI数据中心而言,功耗已经成为最重要的问题之一。
一台GPU服务器本身可能消耗数千瓦功率。
如果每个网络设备再消耗大量电力,整个AI数据中心电力需求会非常惊人。
因此,DPU和交换芯片的Performance per Watt正在变得越来越重要。
Xsight Labs把低功耗作为整个公司产品体系的重要竞争点。
TSMC 5nm
E1和X2都采用TSMC 5nm工艺。
先进工艺可以帮助芯片在较低功耗下集成更多CPU核心、SerDes、PCIe和网络处理逻辑。
对于800G DPU而言,这一点非常关键。
高速SerDes本身就是非常大的功耗来源。
如果再加入64个CPU核心和大量DDR5、PCIe以及加密功能,芯片功耗很容易迅速增加。
E1希望利用先进工艺和软件定义架构,在性能和功耗之间取得平衡。
Xsight Labs与NVIDIA BlueField
NVIDIA BlueField是目前全球最有代表性的DPU系列之一。
BlueField通过Arm CPU、ConnectX网络技术、硬件加速和DOCA软件平台完成网络、存储和安全卸载。
Xsight Labs E1与BlueField最大的不同之一,是编程模型。
BlueField拥有非常丰富的专用硬件引擎和NVIDIA DOCA生态。
E1则更加突出:
64个Arm核心全部进入数据路径。
标准Linux。
DPDK。
XDP。
SPDK。
减少专有SDK依赖。
因此,两者代表了两种不同DPU设计思路。
BlueField更加突出专用硬件卸载和完整生态。
E1更加突出软件可编程和通用Arm计算。
Xsight Labs与AMD Pensando
AMD Pensando也是重要DPU厂商。
Pensando拥有高度可编程Packet Processor,并且已经进入HPE、Microsoft Azure和其他企业数据中心环境。
Xsight Labs面对Pensando的竞争优势同样主要集中在开放编程和800G网络。
特别是64个Arm N2核心全部位于Data Path中的设计,使E1更像高性能网络计算平台,而不仅仅是带CPU的SmartNIC。
另一方面,AMD拥有CPU、GPU以及Pensando DPU,可以进行完整服务器级协同,这是Xsight Labs暂时不具备的优势。
Xsight Labs与Broadcom和Marvell
Broadcom和Marvell在数据中心网络芯片领域拥有非常强大的市场地位。
Broadcom尤其长期主导高性能Ethernet Switch ASIC市场。
Xsight Labs实际上同时在两个方向挑战这些传统企业。
X2挑战传统交换ASIC。
E1挑战传统DPU、SmartNIC和基础设施处理器。
Xsight Labs的主要武器不是规模,而是:
开放架构。
高度可编程。
高性能功耗比。
标准Linux生态。
这也是初创半导体企业比较典型的竞争方式。
E1已经开始商业化
截至2026年,E1已经不再只是实验室样片。
Xsight Labs表示,E1已经开始出货,并被多个全球网络运营商选择,同时与Edgecore、Hammerspace等企业建立实际产品合作。
E1-AIC已经形成标准PCIe产品,E1-Server则提供独立1RU系统。
因此,Xsight Labs已经从“DPU芯片研发阶段”进入实际商业化阶段。
2026年融资超过3亿美元
Xsight Labs在2026年7月宣布完成超过3亿美元的新一轮融资。
本轮融资使公司的Post-Money估值达到28亿美元,由Fidelity Management & Research Company领投,并有其他新老投资者参与。
公司表示,新资金将用于扩大其AI和云网络产品,并加快E1 DPU和X2交换芯片的市场部署。
截至此次融资后,Xsight Labs官方网站披露其累计融资已经超过7.5亿美元。
对于一家DPU和交换芯片初创公司来说,这是相当可观的资金规模。
原因也很明显:
为什么投资者看重AI网络?
但是当GPU集群越来越大以后,一个新的问题开始出现:
GPU已经非常快,网络却不一定跟得上。
几十块GPU互联相对容易。
几千块GPU互联非常困难。
几万甚至十万块AI加速器组成的集群,则需要完全重新设计网络体系。
这就创造了巨大的新市场:
800G Ethernet。
1.6T Ethernet。
DPU。
SuperNIC。
AI Switch。
Optical Interconnect。
RDMA。
Ultra Ethernet。
Xsight Labs实际上正处于这一产业链的中心位置。
DPU与AI Storage可能是重要机会
传统DPU市场主要围绕云计算虚拟化。
但是AI正在带来另一个巨大市场:
AI Storage。
大型模型训练需要处理PB甚至EB级数据。
GPU价格非常高,如果GPU因为等待数据而闲置,数据中心会损失大量计算资源。
因此,未来AI基础设施的关键问题之一就是:
怎样让存储持续高速向GPU提供数据。
E1拥有800G网络、PCIe Gen5、Arm CPU和存储协议处理能力,非常适合位于Flash存储和GPU集群之间。
Hammerspace选择E1,就是这种趋势的一个典型案例。
Edge也是E1的重要市场
Xsight Labs并没有把E1只定位于Hyperscale Data Center。
E1还可以作为Edge Server。
原因很简单。
一颗E1已经拥有:
64个Arm核心。
DDR5。
800G网络。
PCIe Gen5。
安全和存储加速。
因此,它可以独立运行大量边缘计算程序。
例如:
CDN。
防火墙。
VPN Gateway。
网络安全。
电信网络。
Smart City。
Edge AI。
这些场景通常同时需要计算和高速网络,正好符合E1的技术特点。
Xsight Labs的优势
Xsight Labs第一个重要优势,是E1拥有非常高的800Gbps网络带宽。
第二个优势,是64个Arm Neoverse N2核心直接进入数据路径。
第三个优势,是标准Linux编程模式,可以使用XDP、DPDK和SPDK,降低开发者学习成本。
第四个优势,是同时拥有DPU和Ethernet Switch芯片,可以覆盖服务器端和数据中心网络两个方向。
第五个优势,是已经获得包括Edgecore、Hammerspace和Starlink等合作或客户验证,其中Starlink主要采用X2交换芯片。
第六个优势,是资本实力较强。2026年融资后估值达到28亿美元,累计融资超过7.5亿美元。
Xsight Labs面临的挑战
Xsight Labs面对的竞争对手几乎都是全球最强大的数据中心芯片公司。
DPU市场有:
AMD Pensando。
Marvell。
交换芯片市场又有Broadcom、NVIDIA和Marvell等大型企业。
这些公司拥有多年客户关系、软件生态和巨大的研发预算。
因此,Xsight Labs仅仅拥有漂亮的芯片参数还不够。
它必须证明E1能够长期稳定运行在真实云计算和AI数据中心中。
第二个挑战是软件生态。
“标准Linux”可以降低开发难度,但大型客户仍然需要成熟的驱动、SDK、虚拟化、安全、存储和运维工具。
第三个挑战是AI网络更新速度非常快。
800G正在快速发展,但下一代数据中心已经开始向1.6Tbps网络演进。
Xsight Labs必须继续保持产品迭代速度。
Xsight Labs在DPU产业中的定位
如果把DPU企业分成几类,Xsight Labs属于非常典型的:
独立高性能DPU与数据中心网络芯片厂商。
它不像AWS、阿里云、腾讯或者百度那样主要为了自己的云平台开发DPU。
它需要把芯片、DPU卡和系统销售给全球Hyperscaler、设备厂商、运营商、存储企业和数据中心客户。
与此同时,Xsight Labs又不仅仅是一家DPU公司。
其X系列交换芯片同样是公司的核心产品。
所以更加准确的定位是:
DPU是其中非常重要的一部分。
从X2到E1:Xsight Labs想做什么?
Xsight Labs的最终目标其实非常容易理解。
在AI数据中心里,最大的问题之一已经从“没有足够计算能力”,逐渐变成:
怎样把数据快速送到计算芯片。
CPU负责通用计算。
SSD负责保存数据。
DPU负责服务器内部的数据移动和基础设施处理。
交换芯片负责连接数千台服务器。
Xsight Labs希望同时控制DPU和Switch这两个关键位置。
服务器内部使用E1。
服务器之间使用X2。
这样就形成:
GPU / CPU / Storage → E1 DPU → X2 Switch → Network Fabric → E1 DPU → GPU / CPU / Storage
这就是Xsight Labs目前最重要的技术战略。
总结
Xsight Labs是一家成立于2017年的无晶圆厂半导体公司,早期主要开发高性能数据中心交换芯片,现在已经形成X系列Ethernet Switch和E系列DPU两大产品线。
公司当前最重要的DPU是E1。
E1采用TSMC 5nm工艺,提供800Gbps Ethernet吞吐能力,集成64个Arm Neoverse N2核心、DDR5内存控制器、PCIe Gen5接口、RDMA、网络与存储加速以及线速加密能力,典型芯片功耗约70W。
与很多传统DPU不同,E1把所有64个Arm核心直接放在Data Path中,因此不依赖传统“Fast Path + Slow Path”架构。
开发者可以使用标准Linux、XDP、DPDK和SPDK,而不需要完全依赖专有SDK。
E1已经发展出SoC、PCIe Add-In Card和1RU Edge Server三种产品形式,并开始进入云计算、AI网络、网络安全、AI Storage、Edge Computing以及高性能计算等市场。
2026年7月,Xsight Labs又完成超过3亿美元融资,公司估值达到28亿美元。
公司表示E1 800G DPU和X2交换芯片已经获得多个全球网络运营商选择,说明Xsight Labs正在从芯片研发公司逐渐进入实际规模化商业部署阶段。
在整个DPU产业中,Xsight Labs最值得关注的并不仅仅是“800G”。
真正特别的是它选择了一条非常明确的路线:
用大量通用Arm核心直接处理高速数据流,让DPU尽可能软件定义。
如果NVIDIA BlueField代表“专用硬件加速器 + DPU软件生态”,那么Xsight Labs E1更加接近:
一台直接插入数据路径的高性能Arm服务器。
而随着AI数据中心继续向800G、1.6T网络以及十万卡级AI集群发展,这种DPU与高性能交换芯片相结合的架构,很可能成为未来数据中心最值得关注的技术方向之一。