在上节课Vivado真双端口(TDP)RAM IP核的生成与配置详解中学习了在Vivado下如何配置一个真双端口RAM IP核。本文将使用之前生成的RAM IP核,设计一个乒乓Buffer(更多信息关于乒乓Buffer见文章数据缓冲与乒乓Buffer)。
1.乒乓Buffer简介
在工程中,乒乓Buffer(或Double Buffer)是通信工程中经常使用的一种手段,主要在以下场景使用:
- 异步过程
- 异时钟域下数据的转换
- 不同位宽数据的转换
- 数据需要缓存
乒乓Buffer的优点是可以提高数据的处理效率,并可以分离时钟域,分离两层不同的操作逻辑。乒乓Buffer的应用非常广泛,本文在这里先给大家介绍最基本的原理,以及简单的代码实现,为将来在真正工程中的使用打下基础。
乒乓Buffer 的原理是使用两个内存块Buffer 0,Buffer 1,当有数据进来的时候,就先填充两个内存块中没有被占用,可以写的端口,比如先将数据填充进Buffer 0端的内存,当Buffer 0端被填满后,如果还有数据继续进来的话,就换成填充Buffer 1端的内存,同时处理Buffer 0端的数据。等到Buffer 1端也充满后,转而填充已经处理完数据的Buffer 0端。当数据填充Buffer 0端时,Buffer 1端口正在处理数据。以此类推,Buffer 0,Buffer 1端交替填充数据和处理数据。因为这两个操作是并行的,所以乒乓Buffer的处理速度会提升一倍,这也是FPGA使用面积换取效率的一个典型应用。
乒乓Buffer也有其局限性,在接收严重不等长的数据包(数据颠簸)时,可能会因为两个Buffer处理数据的速度不一样,而不能确保数据输入的连续性或是顺序性。比如1个大数据包后接着1个小数据包写入乒乓Buffer,因为小数据包的处理速度远快于大数据包,所以在写完1个大数据包和1个小数据包后(写完小数据包,大数据包的读操作还在进行),准备写入第3个数据包时,因为大数据包的数据处理速度不够快,数据写操作会被迫中止,如图1所示。数据颠簸的解决办法是在乒乓Buffer后加上有弹性的调节FIFO,具体实例的使用在之后的工程中介绍。
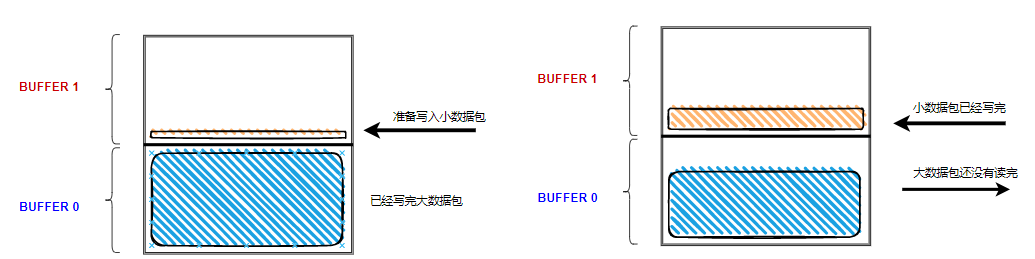
图1 乒乓Buffer数据颠簸
实际上,乒乓Buffer还可以扩充成4个端口,8个端口等,原理与两个端口的情况一致,速度上可以提高更多倍数。乒乓Buffer 的应用,可以参见文章以太网工程中双端口的使用。本文中使用的乒乓Buffer(生成的RAM IP核参见文章Vivado真双端口(TDP)RAM IP核的生成与配置详解)的示意图如下所示:
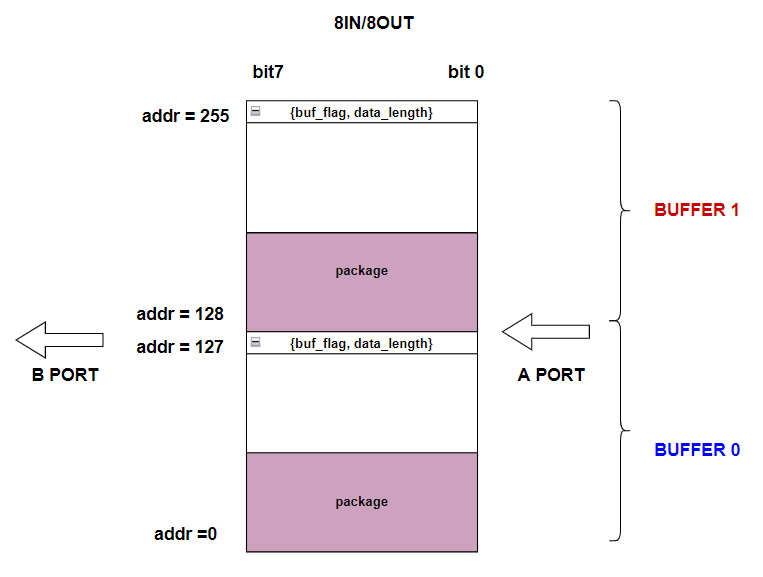
图2 本工程里使用的乒乓Buffer示意图
前面生成的真双端口RAM的大小是256 X 8,所以这里将整个RAM分成了两个128 X 8的Buffer,分别为Buffer 0和Buffer 1。注意对于真双端口RAM来说,Port A和Port B都是可以进行读写操作的,所以使得乒乓Buffer更加灵活。本工程实现了一个简单的乒乓Buffer,使Port A和Port B的口线宽度相同,并且使用的是同步同频的时钟。
在Buffer 0的127处和Buffer 1的255处,存储的不是数据,而是一个单bit的控制信号buf_flag和7-bit的数据长度data_length。Buf_flag的作用是标志当前的Buffer里的数据是否有效。在本节课的实例中,数据有效时,buf_flag的值为1;数据无效时,buf_flag的值为0。在读或写的操作完成后,将buf_flag + 1,即可切换读写模式。
2.工程代码
乒乓Buffer读写的代码如下:
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 122 123 124 125 126 127 128 129 130 131 132 133 134 135 136 137 138 139 140 141 142 143 144 145 146 147 148 149 150 151 152 153 154 155 156 157 158 159 160 161 162 163 164 165 166 167 168 169 170 171 172 173 174 175 176 177 178 179 180 181 182 183 184 185 186 187 188 189 190 191 |
`timescale 1ns / 1ps module top ( input OSC_CLK, output [7:0] LED ); wire clk_50m; wire locked; SYS_MMCM SYS_MMCM_inst ( // Clock in ports .clk_in1 (OSC_CLK), // input clk_in1 // Clock out ports .clk_out1 (clk_50m), // output clk_out1 // Status and control signals .reset (1'b0), // input reset .locked (locked) // output locked ); wire clk = clk_50m; wire reset = ~locked; //============================================================= localparam BUF_SIZE = 7; localparam BUF_ID = 1; reg wea; reg [BUF_ID - 1: 0] addra_id; //switch between Buffer 0 and Buffer 1 reg [BUF_SIZE - 1: 0] addra_sub; wire [BUF_SIZE + BUF_ID - 1 :0] addra = {addra_id, addra_sub}; reg [7:0] dina; wire [7:0] douta; reg web; reg [BUF_ID - 1: 0] addrb_id; //switch between Buffer 0 and Buffer 1 reg [BUF_SIZE - 1: 0] addrb_sub; wire [BUF_SIZE + BUF_ID - 1 :0] addrb = {addrb_id, addrb_sub}; reg [7:0] dinb = 0; wire [7:0] doutb; // ---------------- Ping Pong Buffer ----------- tdp_ram ping_pong_inst ( .clka (clk), // input wire clka .wea (wea), // input wire [0 : 0] wea .addra (addra), // input wire [7 : 0] addra .dina (dina), // input wire [7 : 0] dina .douta (douta), // output wire [7 : 0] douta .clkb (clk), // input wire clkb .web (web), // input wire [0 : 0] web .addrb (addrb), // input wire [7 : 0] addrb .dinb (dinb), // input wire [7 : 0] dinb .doutb (doutb) // output wire [7 : 0] doutb ); //================== write operation ========================= reg [2:0] porta_st = 0; always @ (posedge clk or posedge reset) if(reset) begin addra_id <= 0; porta_st <= 0; end else begin case (porta_st) 0: begin dina <= {addra_id, 7'h0}; //data 0 wea <= 0; addra_sub <= {BUF_SIZE{1'b1}}; //addr = 127 porta_st <= 1; end 1: begin porta_st <= 2; //hold for end 2: begin if( douta[7] == 0 ) porta_st <= 3; end 3: begin if(addra_sub == 63) begin wea <= 0; porta_st <= 4; end else begin addra_sub <= addra_sub + 1; dina <= dina + 1; wea <= 1; end end 4: begin addra_sub <= {BUF_SIZE{1'b1}}; dina <= {1'b1, 7'b100_0000}; wea <= 1; porta_st <= 5; end 5: begin wea <= 0; addra_id <= addra_id + 1; porta_st <= 0; end default: porta_st <= 0; endcase end //==================== read operation ======================== reg [2:0] portb_st = 0; reg [6:0] len = 0; reg [6:0] cnt = 0; reg [7:0] led_r = 0; always @ (posedge clk or posedge reset) if(reset) begin addrb_id <= 0; portb_st <= 0; end else begin case (portb_st) 0: begin web <= 0; cnt <= 0; addrb_sub <= {BUF_SIZE{1'b1}}; portb_st <= 1; end 1: begin portb_st <= 2; end 2: begin if( doutb[7] == 1 ) begin addrb_sub <= 0; portb_st <= 3; end end 3: begin len <= doutb[6:0]; addrb_sub <= 1; portb_st <= 4; end 4: begin if(cnt == len) begin portb_st <= 5; end else begin cnt <= cnt + 1; led_r <= doutb; addrb_sub <= addrb_sub + 1; end end 5: begin addrb_sub <= {BUF_SIZE{1'b1}}; web <= 1; portb_st <= 6; end 6: begin web <= 0; addrb_id <= addrb_id + 1; portb_st <= 0; end default: portb_st <= 0; endcase end assign LED = led_r; endmodule |
注意这里的变量声明都是参数化。比如BUF_SIZE,这个表示当前每个Buffer的大小是2^BUF_SIZE。比如当BUF_SIZE 等于7时,每个Buffer的大小是128,因为双端口RAM的总大小是256,所以通过BUF_SIZE可以知道当前的双端口里分为两个Buffer。如果想要使用单个Buffer,那么只需要修改BUF_SIZE为8,Buffer的大小变为256;或者如果想要使用4个Buffer,可以将BUF_SIZE设置为6,每个Buffer的大小为64。同时注意将BUF_ID调整为2-bit,可以识别4个不同的Buffer。
以A端口举例,以下代码:
|
1 2 3 4 |
reg [BUF_ID - 1: 0] addra_id; reg [BUF_SIZE - 1: 0] addra_sub; wire [BUF_SIZE + BUF_ID - 1 :0] addra = {addra_id, addra_sub}; |
表示将双端口RAM的地址分为两个部分,addra_sub是基地址。最高位可以在Buffer之间切换,比如对于addra_sub = 7’b111_1111时,如果addra_id = 0,表示当前地址是{0, 111_1111} = 127,即Buffer 0的最高位,里面存储的是Buffer 0的buf_flag(指示当前Buffer是否可以读/写)以及Buffer中的数据长度;当addra_id = 1,表示当前地址是{1, 111_1111} = 255,即Buffer 1的最高位,里面存储的是Buffer 1的buf_flag和Buffer中的数据长度。由此看出,将地址分成addra_id和addra_sub使得在两个Buffer中可以灵活切换。
3.状态机分析
第一个状态机(porta_st)这里在A端口自Buffer 0开始对两个Buffer分别进行了写操作。将0-63, 共64个数据写入Buffer。其状态转移如下图所示:
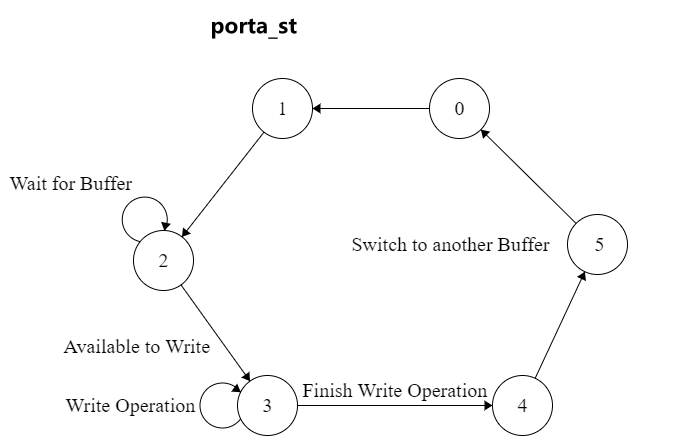
图3
状态0:将基地址addra_sub调整到最高位,准备读出buf_flag,来指示写操作什么时候开始。复位后默认的addra_id是0,即先准备对Buffer 0进行操作。
状态1:跳到了状态2,没有做任何其它的事,这是因为双端口RAM读数据需要一个时钟之后才能完成,所以这里插入了一个空状态。
状态2:判断当前Buffer的buf_flag,如果指示可以进行写操作,跳到状态3,否则继续等待。
状态3:向当前Buffer写入数据,并记录数据长度。写了64个数据后,跳到状态4.
状态4:将基地址addra_sub调整到最高位,调整buf_flag,表明当前的Buffer的写操作已经完成,可以进行读操作,并跳到状态5。
状态5:切换Buffer,准备下一次写操作,跳到状态0。
第二个状态机(portb_st)在B端口自Buffer 0开始对两个Buffer分别进行了读操作。其状态转移如下图所示:
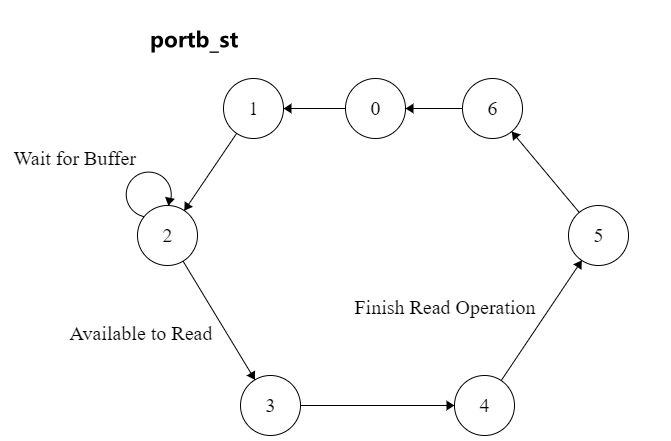
图4
状态0:将基地址addrb_sub调整到最高位,准备读出buf_flag,来指示是否可以进行读操作。复位后默认的addrb_id是0,即先准备对Buffer 0进行操作。
状态1:跳到了状态2,没有做任何其它的事,这是因为双端口RAM读数据需要一个时钟之后才能完成,所以这里插入了一个空状态。
状态2:判断当前Buffer的buf_flag,如果指示可以进行读操作,读出最高位中的数据长度len,设置读数据的初始位置为0,跳到状态3,否则继续等待在状态2。
状态3:读数据地址设置为1,跳到状态4。添加这个状态也是因为双端口RAM读数据需要一个时钟之后才能完成。
状态4:记录已经读出的数据长度cnt,如果等于len,则表明双端口RAM中的数据已经读完,转到状态5。否则每读出一个数据,将cnt + 1,并将读数据的地址addrb_sub + 1,并将读出的数据显示在LED上。
状态5:将基地址addrb_sub调整到最高位,调整buf_flag,表明当前的Buffer的读操作已经完成,可以再次进行写操作,并跳到状态6。
状态6:切换Buffer,准备下一次读操作,跳到状态0。
注意这里将从双端口RAM读出的数据输出到了LED上。
4.仿真
因为在porta_st状态机中直接写入了数据,所以在仿真时,不需要再次给激励,只需要例化顶层文件,直接观察波形即可。
仿真testbench代码如下:
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 |
`timescale 1ns / 1ps module tb( ); reg clk = 0; always #10 clk = ~clk; wire [7:0] LED; top top_inst ( .OSC_CLK (clk), .LED (LED) ); endmodule |
仿真图如下所示:

图5
从图5中可以看出在复位信号被拉低后,给出A端口写使能wea,数据dina和地址addra,将数据写入双端口RAM的Buffer 0。

图6
在写完Buffer 0数据后,地址转到Buffer 1,继续写如数据。
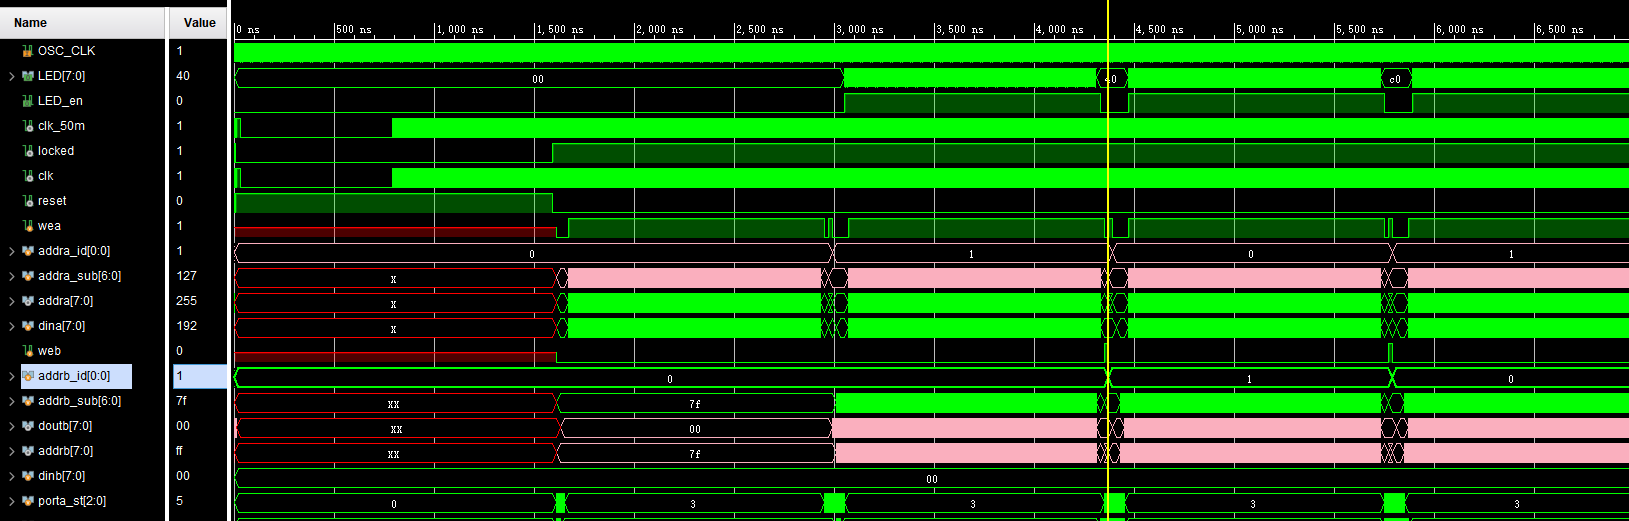
图7
从图7可以看出是先进行写操作,写完后buf_flag被置位,B端口才能进行读操作。

图8
图8中显示的是读操作。
从以上的仿真图中可以看出使用双端口RAM IP制作的乒乓Buffer可以正确的使用。
5.扩展作业
- 将两个端口的乒乓Buffer分为4个端口,设计相应的仿真程序,并验证。
- 设计一个异步时钟域的双端口RAM,并使用不同的口线宽度来实现乒乓Buffer。