由于双口RAM在实际应用中会经常出现a,b端口不等宽的需求,如a端对应图像采集系统,输入为R、G、B三色24个bits,b 端为网络接口按照byte的方式输出并打包在网络上发送。还有如在高速串行通信中,接收端一般为byte的结构写入双口RAM,而在数据的使用端往往为了降低时钟频率,或适应固定接口(如CPU访问FPGA的双口RAM)可能为32位或16位接口等。在DSP的计算中经常出现18位与36位或18位与72位的变换等。
本节内容对双口RAM进行深度测试与仿真,测试主要内容如下:在异步时钟域下,a,b端口不等宽的读、写测试。其中a端口32位写入,b端口16位读出,将生成的双口RAM例化如下:
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 |
module dpram ( //==================================a side input inclka, input [7:0] address_a, input [31:0] data_a, input wren_a, input rden_a, output [31:0] q_a, //==================================b side input inclkb, input [8:0] address_b, input [15:0] data_b, input wren_b, input rden_b, output [15:0] q_b ); d_p_ram d_p_ram_inst ( .clock_a (inclka), .address_a (address_a), .data_a (data_a), //data --write to memory .rden_a (rden_a), .wren_a (wren_a), .q_a (q_a), //read, data out from memory .clock_b (inclkb), .address_b (address_b), .data_b (data_b), .rden_b (rden_b), .wren_b (wren_b), .q_b (q_b) ); endmodule |
新生成的工程中双口RAM的示意图如图1
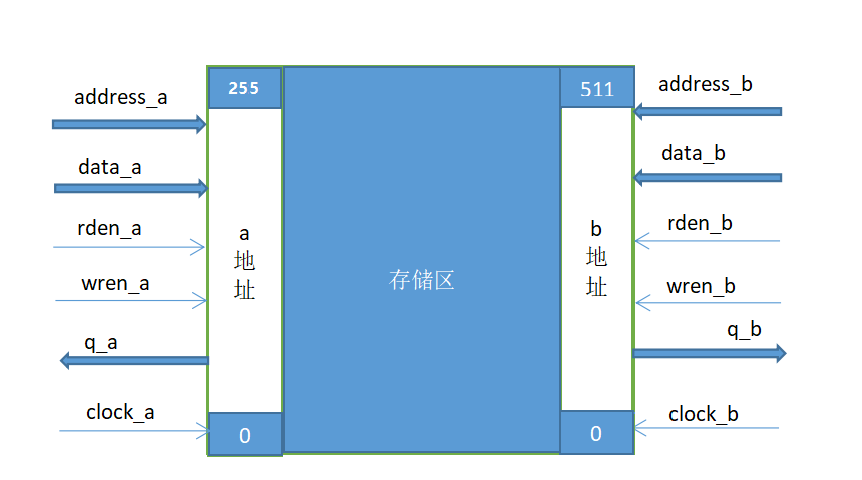
图1
1.双端口RAM测试内容
本测试设置写入a端口的数据为32-bit宽,读出b端口的数据为16-bit宽。为了观察a,b端口数据的输入与输出以及数据的综合应用,设计a,b端口对数据包的操作,设计如下:
- 异步时钟下,输出端口寄存输出的情况下,观察a端口写入,a端口读出延时。a端口写入,b端口读出的延时。注:读出时选择读出新数据(new data),如图2,
- 在状态1(st==1)时,在地址为8’b000_0000的单元写入32’h55aa_aa55;
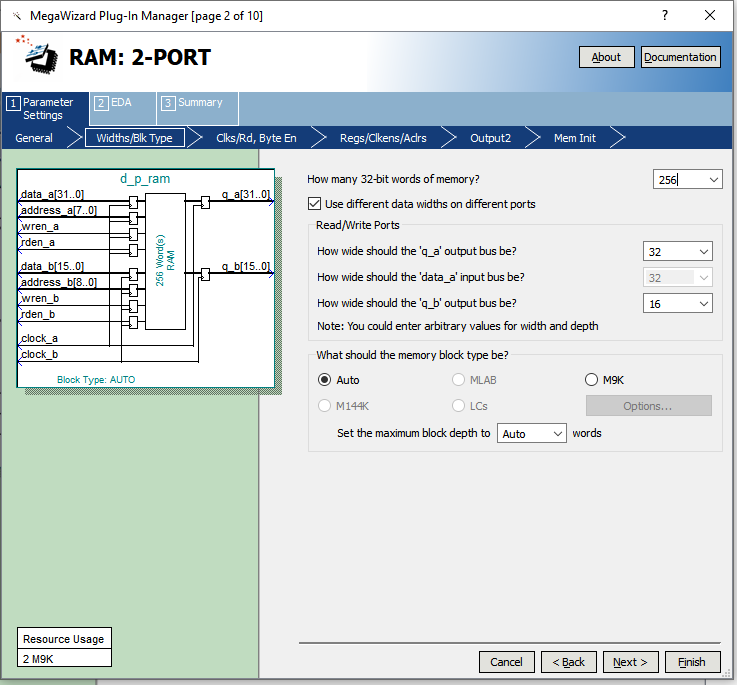
图2
测试程序如下:
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 122 123 124 125 126 127 128 129 130 131 132 133 134 135 136 137 138 139 140 141 142 143 144 145 146 147 148 149 150 151 152 153 154 155 156 157 158 159 160 161 162 163 164 165 166 167 168 169 170 171 172 173 174 175 176 177 178 179 180 181 182 183 184 185 186 187 188 189 190 191 192 193 194 195 196 197 198 199 200 201 |
`timescale 1ns /1ps module addab ( ); parameter PERIOD = 10; reg inclka; reg inclkb; reg rst; reg [7:0] address_a; reg [31:0] data_a; wire [31:0] q_a; reg rden_a; reg wren_a; reg wr_rdy; reg wr_rdy_rb0; // first registered wr_rdy reg wr_rdy_rb1; // second registered wr_rdy reg [8:0] address_b; reg [15:0] data_b; wire [15:0] q_b; reg [15:0] q_b_r; reg rden_b; reg wren_b; reg [2:0] st_a, st_b; //assign inclkb = inclka; initial begin rst = 1'b1; inclka = 0; inclkb = 0; #50 rst = 0; #500; $stop; end always #(PERIOD/2) inclka = ~inclka; always #(PERIOD/3) inclkb = ~inclkb; always@(posedge inclka or posedge rst) if(rst) begin st_a <= 0; address_a <= 0; rden_a <= 1'b0; wren_a <= 1'b0; data_a <= 0; wr_rdy <= 0; end else begin case(st_a) 0: begin address_a <= 0; rden_a <= 1'b1; wren_a <= 1'b0; data_a <= 0; wr_rdy <= 0; st_a <= 1; end 1: begin address_a <= 0; wren_a <= 1'b1; data_a <= 32'h55aa_aa55; st_a <= 2; end 2: begin address_a <= address_a + 1; data_a[31:16] <= data_a[31:16] + 1; data_a[15:0] <= data_a[15:0] + 1; if(address_a == 7) st_a <= 3; end 3: begin wren_a <= 1'b0; wr_rdy <= 1'b1; st_a <= 4; end 4: begin wren_a <= 1'b0; st_a <= 5; end 5: begin wren_a <= 1'b0; st_a <= 6; end 6: begin wren_a <= 1'b0; st_a <= 6; end default: st_a <= 0; endcase end always@(posedge inclkb) begin wr_rdy_rb0 <= wr_rdy; wr_rdy_rb1 <= wr_rdy_rb0; end always@(posedge inclkb or posedge rst) if(rst) begin q_b_r <= 0; address_b <= 0; rden_b <= 1'b0; wren_b <= 1'b0; data_b <= 0; st_b <= 0; end else begin case(st_b) 0: begin address_b <= 0; rden_b <= 1'b1; q_b_r <= q_b; if(wr_rdy_rb1) begin address_b <= address_b + 1; st_b <= 1; end end 1: begin address_b <= address_b + 1; q_b_r <= q_b; if(address_b == 15) st_b <= 2; end 2: begin address_b <= address_b + 1; q_b_r <= q_b; st_b <= 3; end 3: begin address_b <= address_b + 1; q_b_r <= q_b; st_b <= 4; end 4: begin address_b <= address_b + 1; q_b_r <= q_b; st_b <= 5; end 5: begin address_b <= address_b + 1; q_b_r <= q_b; st_b <= 6; end 6: begin q_b_r <= q_b; st_b <= 6; end default: st_b <= 0; endcase end dpram dpram_inst ( .inclka (inclka), .address_a (address_a), .data_a (data_a), //data --write to memory .rden_a (rden_a), .wren_a (wren_a), .q_a (q_a), //read, data out from memory .inclkb (inclkb), .address_b (address_b), .data_b (data_b), .rden_b (rden_b), .wren_b (wren_b), .q_b (q_b) ); endmodule |
仿真波形如图3:
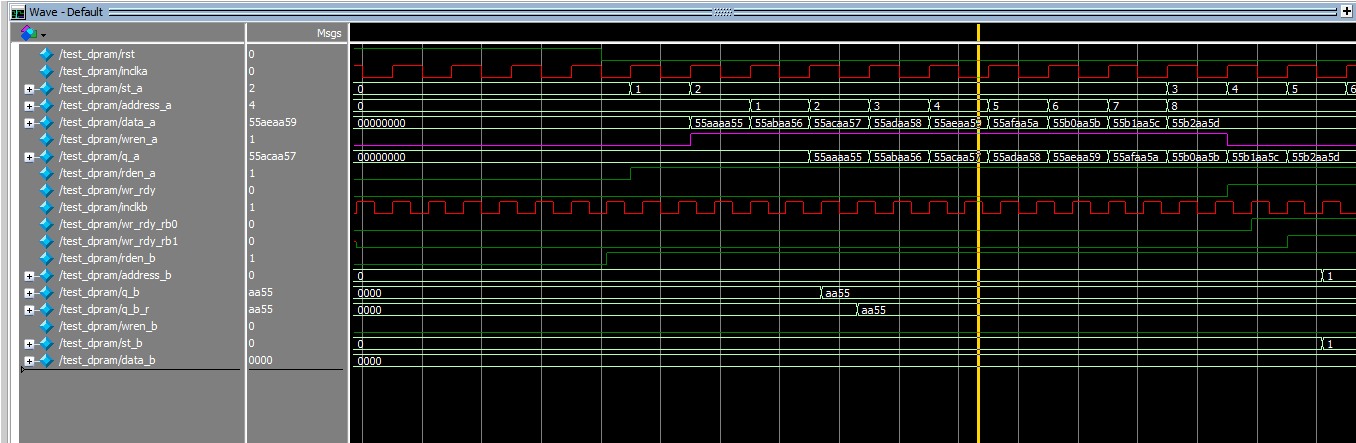
图3
- 波形分析:从图3可以看出,在状态机st为1时对a端口进行赋值,在状态机st=2时,地址address_a=0,数据data_a=32’h55aaaa55,写使能wren_a=1’b1都得到相应的数据,但双口RAM内部对地址address_a,数据data_a,写使能wren_a都进行了锁存,因此写入到RAM中将会再延迟一个时钟,所以真正将数据写入到RAM中是在状态2中地址为1(address_a=1)的,但是由于在生成双口RAM时选择了数据输出寄存器锁存方式,因此在address_a=1并没有及时读出,而实际读出数据是在address_a=2。如果选择读出为旧数据,将会再延迟一个时钟,这和前面两节测试结果一致。a端口在之后的地址变化也是每个数据比对应的写数据延迟2个时钟输出,所以总体效果是第一个数据延迟两个时钟,后续的数据读取完全以流水(pipeline)的方式一个紧接着一个输出,整体数据只有两个时钟延迟的效果。
- b端口由于时钟沿超前a端口,因此可以看到在状态2的address_a=2位置对应inclkb的上升沿有输出,而且输出的是aa55是32位数据的低16位,q_b已经输出在端口位置了,需要提醒的是,由于a,b 端口采用的是异步时钟,因此数据的数据可能不稳定(仿真有时不能完全解释内部过程)。后面我们会针对这种情况提出专门的解决方案。
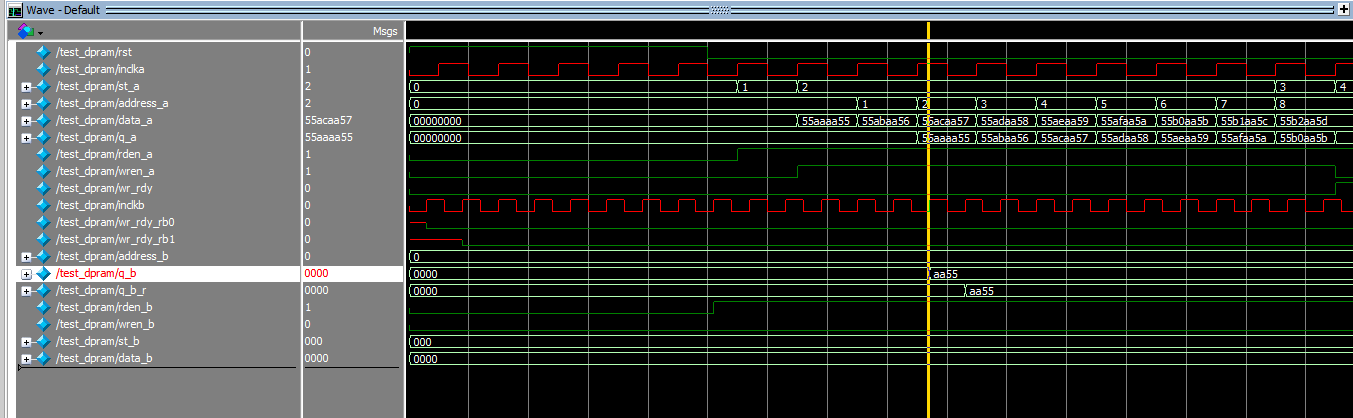
图4
图4为门级仿真的结果,可以看出和RTL仿真结果没有区别。
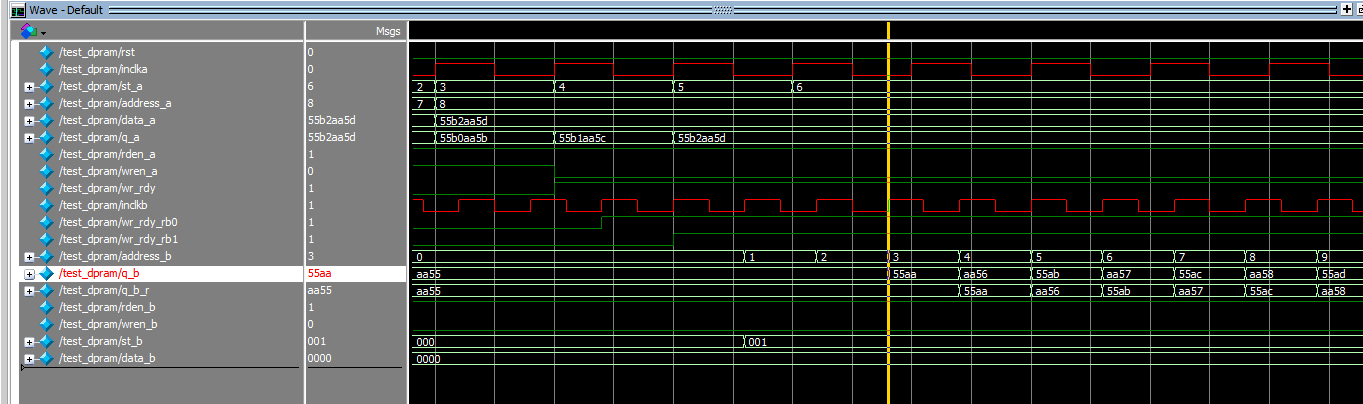
图5
图5显示在inclkb的驱动下,随着地址的递增,交替着将32位数据分低、高读出依次读出。
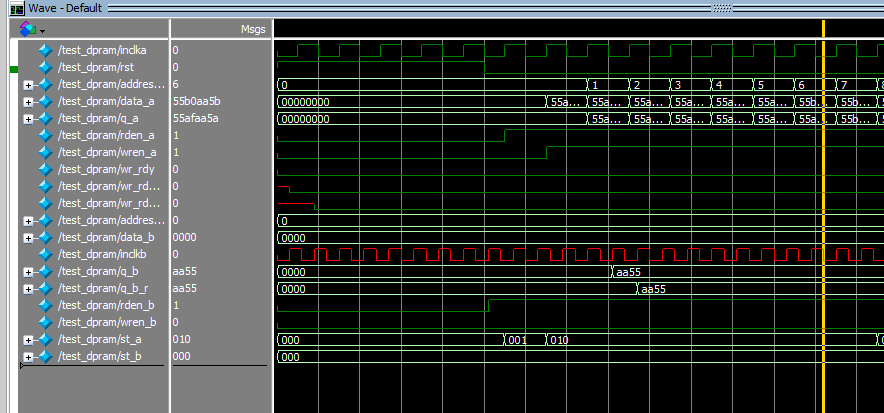
图6
图6是在q_a,q_b非输出锁存时的仿真结果,看起来与功能仿真一样,其实如果将波形不断展开(zoom in), 会发现q_b的输出如图7所示,并没有与inclkb同步,但q_b_r的确与 inclkb同步的
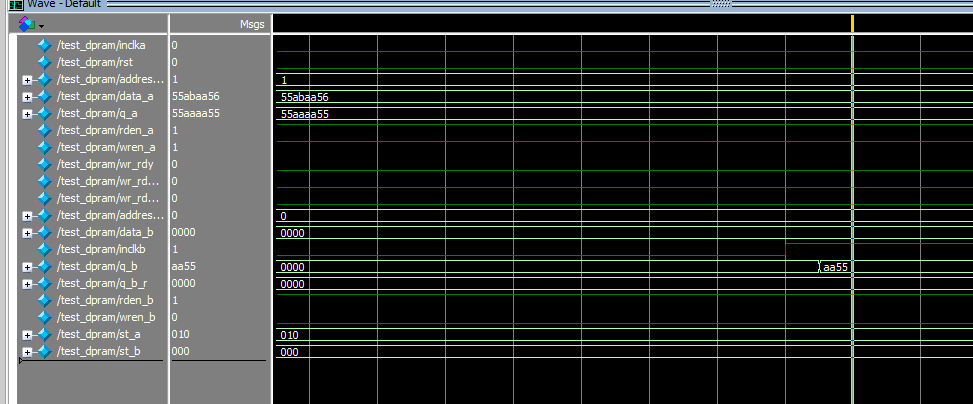
图7
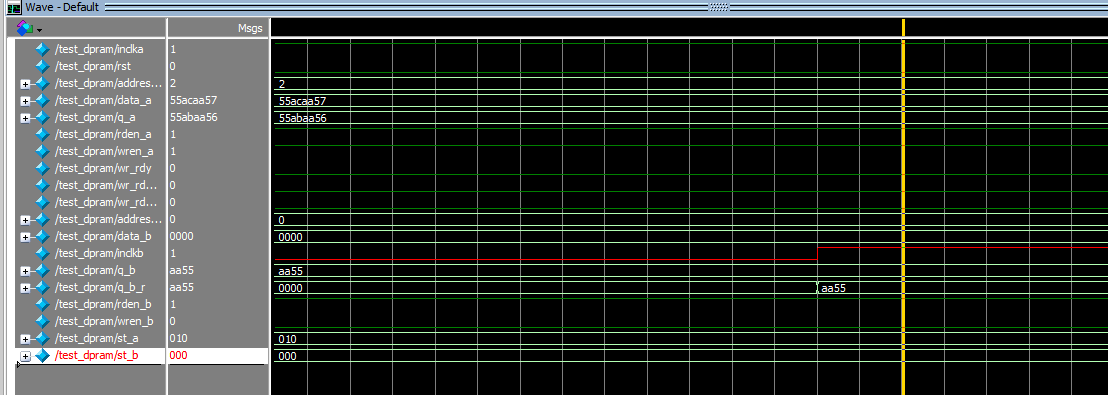
图8
从图6,7,8可以分析得到结果如下,端口a在某一时刻写入,延迟一段时间后在b端口输出,由于a,b端口是异步时钟,因此a端口写入后,b端口经过几个时钟输出是不能完全确定的,随着b端口的时钟频率、相位不同而不同,而且很可能出现亚稳态。
将仿真时钟按照如下修改:
parameter PERIOD =20;
always #(PERIOD/2) inclka=~inclka;
always #(PERIOD/5) inclkb=~inclkb;
将得到图9的仿真结果,
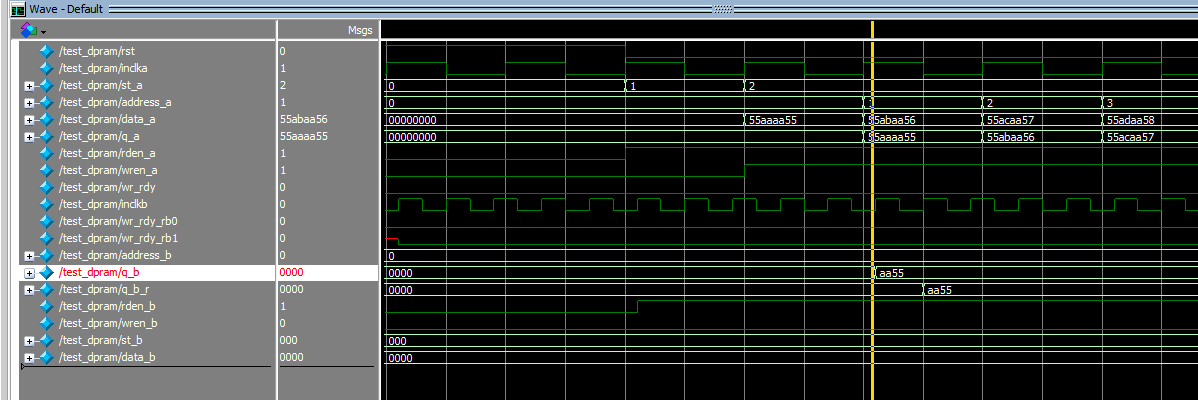
图9
比较图6,9可以看出q_b的输出在图9中明显比图6相对于写入的时刻超前了。因此可以看出由于RAM阵列是是组合逻辑,在a端口写入时,经过一个很短的延迟将在b端口的输出。注意和图7一样,b端输出结果q_b比inclkb要稍晚一点。
注:6,7,8,9是门级仿真的结果。
2. 结论
通过本次实验过程,可以总结出以下几点:
- 无论a端口还是b端口,第一个数据的读取会延迟2-3时钟,后续随着地址的变化可以以流水的方式(pipe line)输出。
- 异步时钟下写入数据到数据读出,与时钟的频率、相位有关。
- 建议异步时钟时,端口q_a, q_b选择寄存器的方式输出,这样有利于亚稳态的消除。
- 不等宽的端口写入和读出,遵循先读低部分后读高部分。
对应视频: