上节内容内容讲解了利用乒乓Buffer实现异步过程数据缓冲的原理,本节内容利用Intel-Altera 的FPGA为例介绍如何使用BRAM实现异步过程的的数据缓冲。异步过程可能发生在应用层或数据链路层,首先研究如何在数据链路层插入乒乓Buffer实现异步过程的隔离,打破上层(应用层)和下层数据的胶合逻辑(glue logic),将应用层和数据链路层解放出来可以完成更多的任务。
1.乒乓Buffer的例化
利用向导生成双口RAM Quartus右面IP Catalog窗口: Installed IP –>Library–>Basic Function–>On Chip Memory–>RAM:2-PORT,双击 打开如图1所示界面,命名为tx_pingpong_buffer。
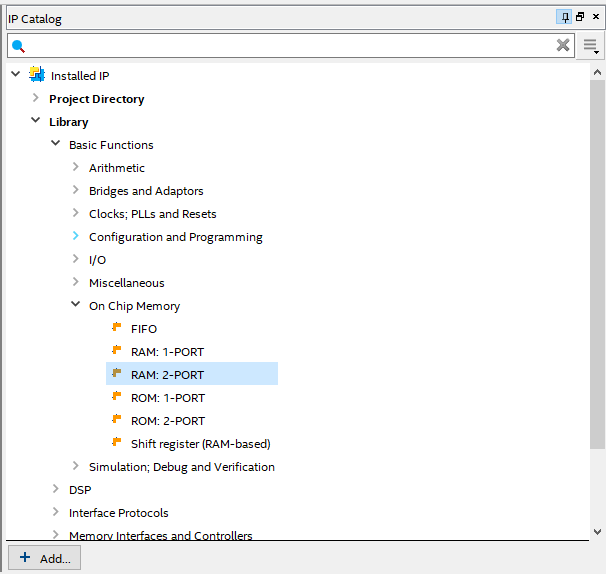
图1
(1)选择“with two read/write ports”,使读、写端口分开控制;
(2)选择:“As a number of words”,存储器尺寸按words标定。如图2所示,点击Next.
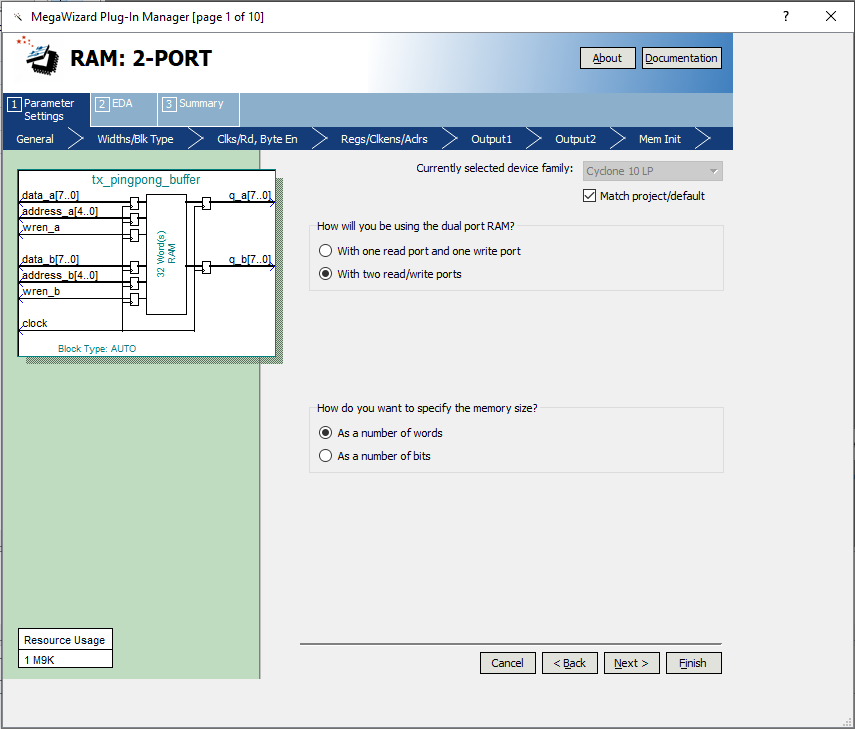
图2
(3)将口线宽度为16,深度为2048,主要考虑将来与CPU的传统总线做接口(异步总线接口),所以这里没有采用18位接口。添加rden_a,rden_b。
至于rden_a,rden_b在例化后,如果不使这两个信号用也可以直接输入高电平。如图3,
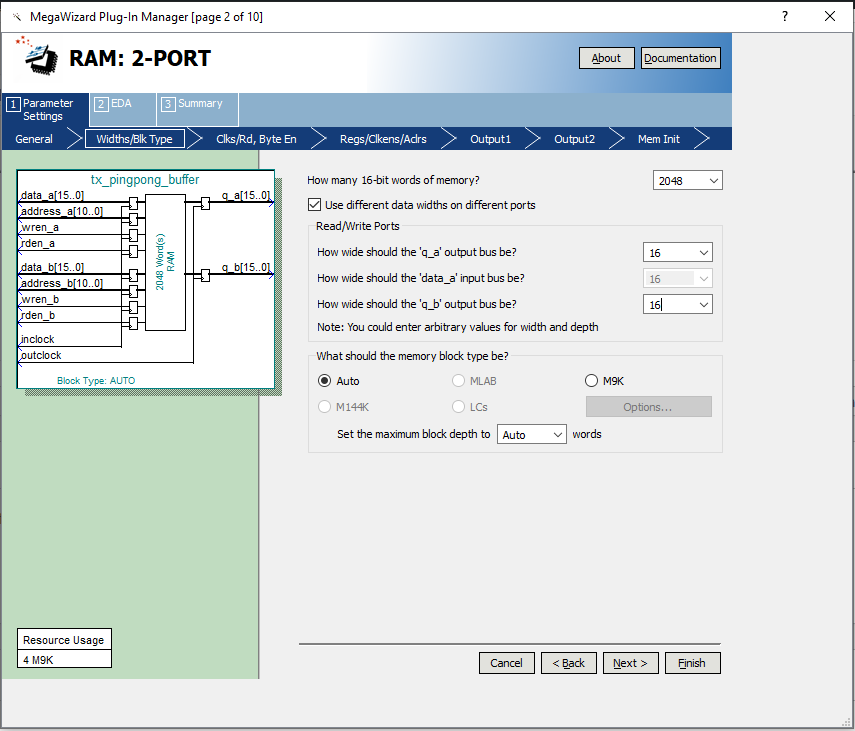
图3
(4)BRAM采用不同的时钟,这样两边将来在发布IP核的时候适应性更强。便于操作,将clock分别设定A端口和B端口,而不是与将clock与输入输出对应。这样对于同一个端口的读/写都是同步的。当然不同的应用可能配置不同,当在DSP或图像算法处理(如深度学习等)时,需要同时利用双端口更新数据,又需要同时在双端口上使用数据时,可以配置成两个时钟分别与读/写端口相关联。
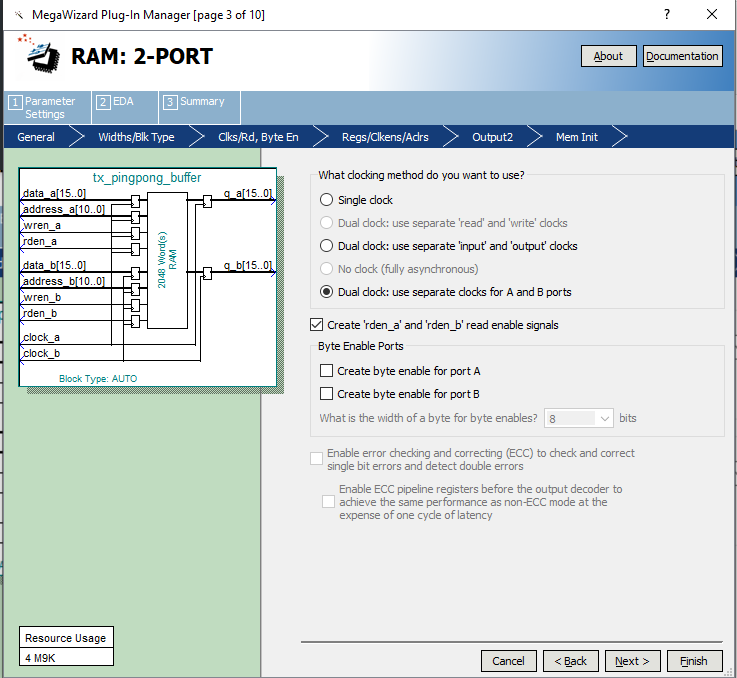
图4
(5)选择数据,地址的锁存方式,图5显示在BRAM的端口有一级锁存,可以提高时序,但从给定读地址到真正数据输出会增加以及延迟。因此在使用数据时一定要注意。
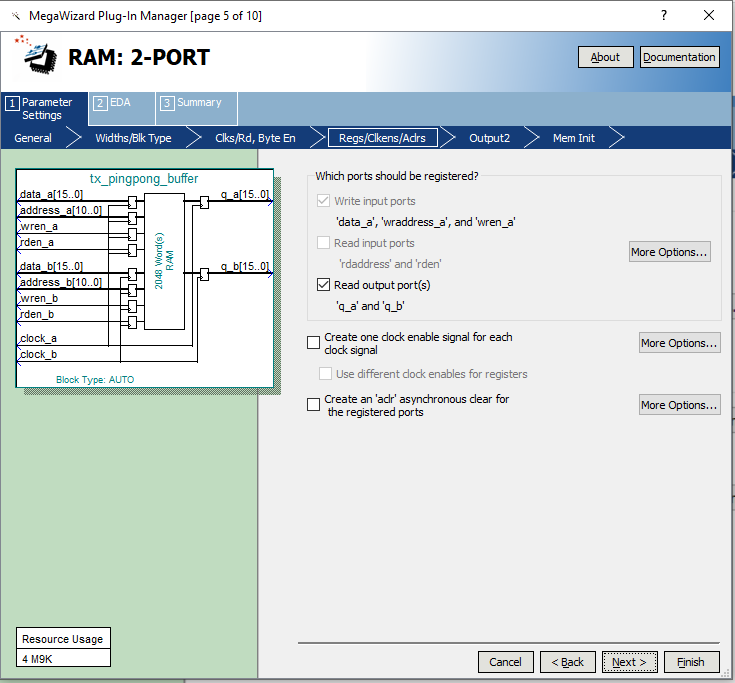
图5
图6数据输出没有增加时钟锁存,数据输出端口与存储单元直接相连,少一级延迟,但时序收敛的结果会变差,本程序中由于时钟为100M,对于时序的要求不高,因此选择图6的配置方式。
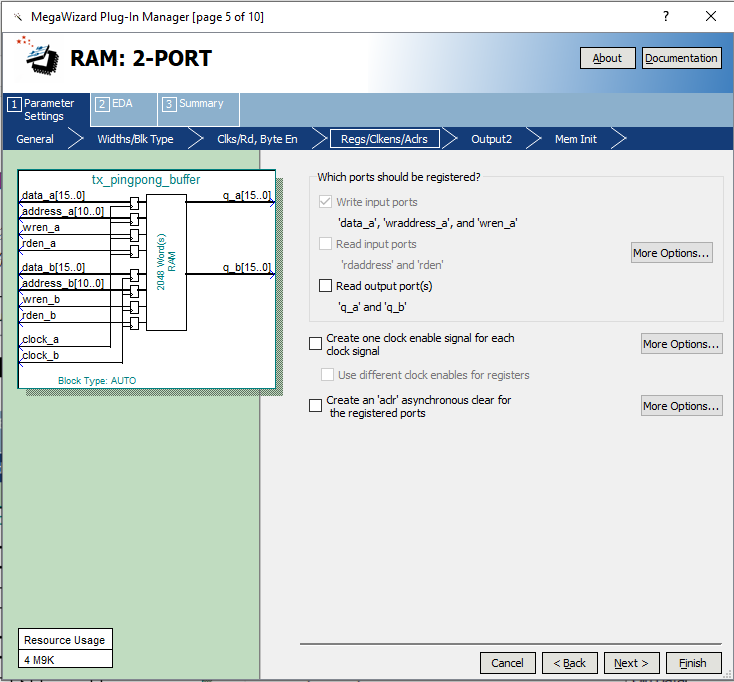
图6
(6)当同一个端口读写同一个单元时(主要在控制字读写时发生),选择读取旧数据,确保读取的安全性。当在同步时钟下,也可以设成读新数据,可以提前读出新数据,在多个流水线写/读数据交换的情况下,可以简化流水线的匹配,但一定要保证同时读写的安全性,这部分的话题将来在RISC-V CPU设计部分进行探讨。
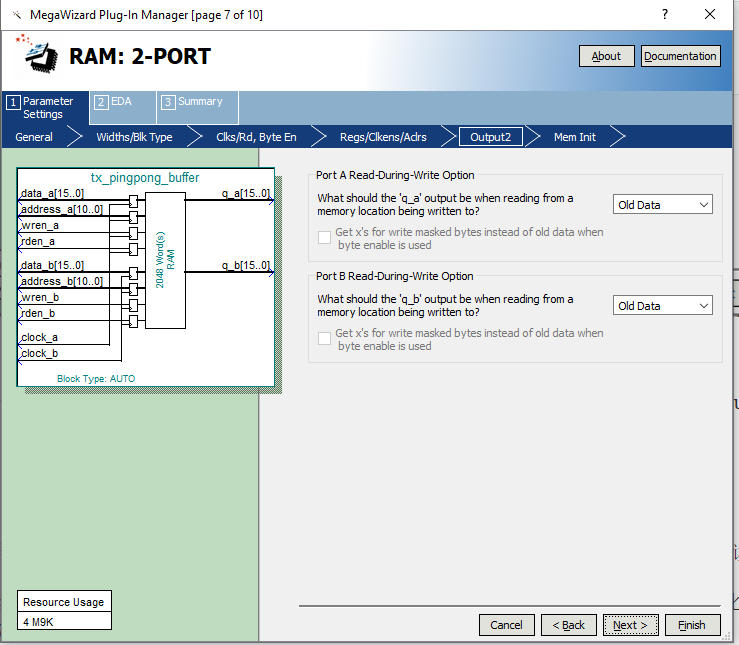
图7
(8)生成DPRAM IP核并例化。(在视频中解释一下,在Quartus,Vivado 系统中模板(templet, Vizard,IP 核,例化的概念)。由于在本设计中是用于数据链路层与应用层的数据缓冲,因此将例化放在数据链路层。例化接口如下:
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 |
tx_pingpong_buffer tx_pingpong_buffer_inst ( .clock_a ( clk_100M ), .address_a ( tx_addr_a ), .rden_a ( 1'b1), .wren_a ( tx_wren_a ), .data_a ( tx_data_a ), .q_a ( tx_q_a ), .clock_b ( clk_100M ), .address_b ( tx_addr_b ), .rden_b ( 1'b1), .wren_b ( tx_wren_b ), .data_b ( tx_data_b), .q_b ( tx_q_b) ); |
上面例化接口将BRAM将a,b端口清晰的分成两个部分。虽然例化时采用了a,b端口异步时钟的方式,但本程序中为了简化设计将clock_a与clock_b都连接到clk_100M上,实际效果是同步时钟的行为(如果能确定a,b端口是同步时钟,也可以修改IP,采用单时钟生成IP)。rden_a, rden_b由于与读地址同步,由地址即可确定读出单元,因此这里都直接给高电平(1’b1)。按照图8的方式,将a端口与应用层相连,将b端口与本层(数据链路层)的程序关联。
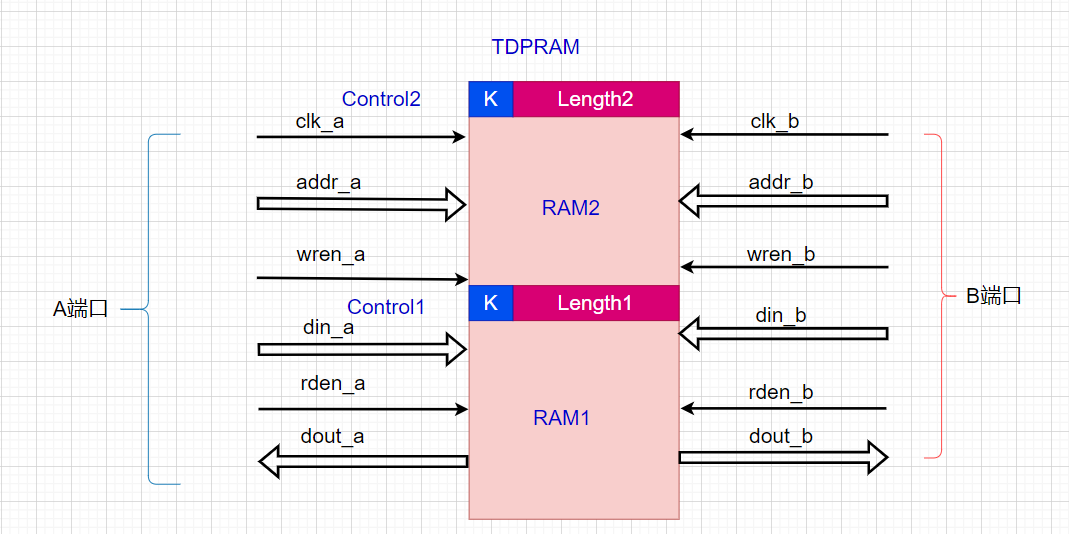
图8
修改数据链路层的程序与接口,分别与应用层和物理层连接。保持与物理层的接口协议不变,修改与应用层的接口。维持接收端的所有接口与协议不变,便于验证发送端的接口和代码修改。
2.工程代码修改
(1)发送端数据链路层修改后的代码如下:
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 122 123 124 125 126 127 128 129 130 131 132 133 134 135 136 137 138 139 140 141 142 143 144 145 146 147 148 149 150 151 152 153 154 155 156 157 158 159 160 161 162 163 164 165 166 167 168 169 170 171 172 173 174 175 176 177 178 179 180 181 182 183 184 185 186 187 188 189 190 191 192 193 194 195 196 197 198 199 200 201 202 203 204 205 206 207 208 209 210 211 |
module trans_data_link #( parameter IDLE = 10'b1010_1010_10 ) ( input rst, input clk_100M, input [ 10: 0 ] tx_addr_a, input [ 15: 0 ] tx_data_a, input tx_en_a, output[ 15: 0 ] tx_q_a, output tx_out ); localparam PAC_INTERVAL = 93; //packect interval,modify Pac_Interval value from 96 to 93. wire tx_phy_rdy; reg tx_phy_rdy_r; reg tx_phy_rdy_ack; always@( posedge clk_100M or posedge rst ) if ( rst ) begin tx_phy_rdy_r <= 0; end else begin if ( tx_phy_rdy ) tx_phy_rdy_r <= 1'b1; else if ( tx_phy_rdy_ack ) tx_phy_rdy_r <= 1'b0; end reg [ 7: 0 ] tx_phy_data; reg tx_phy_en; reg tx_phy_vld; reg [ 9: 0 ] tx_addr_b_r; reg tx_pinpong; wire [ 10: 0 ] tx_addr_b = { tx_pinpong, tx_addr_b_r }; wire [ 15: 0 ] tx_q_b; reg [ 10: 0 ] tx_num_b; reg tx_wren_b; reg [ 7: 0 ] pac_interval; reg [ 2: 0 ] link_st; always@( posedge clk_100M or posedge rst ) if ( rst ) begin pac_interval <= 0; tx_phy_data <= 0; tx_phy_vld <= 0; tx_phy_en <= 0; tx_phy_rdy_ack <= 0; tx_addr_b_r <= 1023; tx_pinpong <= 0; tx_num_b <= 0; tx_wren_b <= 0; link_st <= 0; end else case ( link_st ) 0: begin tx_phy_data <= 0; tx_phy_vld <= 0; tx_phy_en <= 0; tx_addr_b_r <= 1023; tx_num_b <= 0; tx_wren_b <= 0; if ( pac_interval == PAC_INTERVAL ) link_st <= 1; else pac_interval <= pac_interval + 1'b1; end 1: begin pac_interval <= 0; if ( tx_q_b[ 15 ] ) begin tx_addr_b_r <= 0; tx_phy_vld <= 1'b1; link_st <= 2; end end 2: begin tx_num_b <= tx_q_b[ 10: 0 ]; //valid bytes number link_st <= 3; end 3: begin if ( tx_phy_rdy_r ) begin tx_phy_en <= 1'b1; tx_phy_data <= tx_q_b[ 7: 0 ]; tx_num_b <= tx_num_b - 1'b1; tx_phy_rdy_ack <= 1'b1; link_st <= 4; end end 4: begin tx_phy_en <= 1'b0; tx_phy_rdy_ack <= 1'b0; if ( tx_num_b == 0 ) begin tx_wren_b <= 1; tx_addr_b_r <= 1023; link_st <= 7; end else link_st <= 5; end 5: begin if ( tx_phy_rdy_r ) begin tx_phy_en <= 1'b1; tx_phy_data <= tx_q_b[ 15: 8 ]; tx_num_b <= tx_num_b - 1'b1; tx_phy_rdy_ack <= 1'b1; link_st <= 6; end end 6: begin tx_phy_en <= 1'b0; tx_phy_rdy_ack <= 1'b0; if ( tx_num_b == 0 ) begin tx_wren_b <= 1; tx_addr_b_r <= 1023; link_st <= 7; end else begin tx_addr_b_r <= tx_addr_b_r + 1'b1; link_st <= 3; end end 7: begin tx_wren_b <= 0; tx_phy_vld <= 1'b0; tx_pinpong <= tx_pinpong + 1'b1; link_st <= 0; end default: link_st <= 0; endcase tx_pingpong_buffer tx_pingpong_buffer_inst ( //====================================a port, being connected app layer .clock_a ( clk_100M ), .address_a ( tx_addr_a ), .rden_a ( 1'b1 ), .wren_a ( tx_en_a ), .data_a ( tx_data_a ), .q_a ( tx_q_a ), //====================================b port, .clock_b ( clk_100M ), .address_b ( tx_addr_b ), .rden_b ( 1'b1 ), .wren_b ( tx_wren_b ), .data_b ( 16'b0 ), .q_b ( tx_q_b ) ); tx_data_phy #( .IDLE( IDLE ) ) tx_data_phy_inst ( .rst ( rst ), .clk_100M ( clk_100M ), .tx_phy_rdy ( tx_phy_rdy ), .tx_phy_vld ( tx_phy_vld ), .tx_phy_en ( tx_phy_en ), .tx_phy_data( tx_phy_data ), .tx_out ( tx_out ) ); endmodule |
上述代码中link_st状态机转移图如下所示:
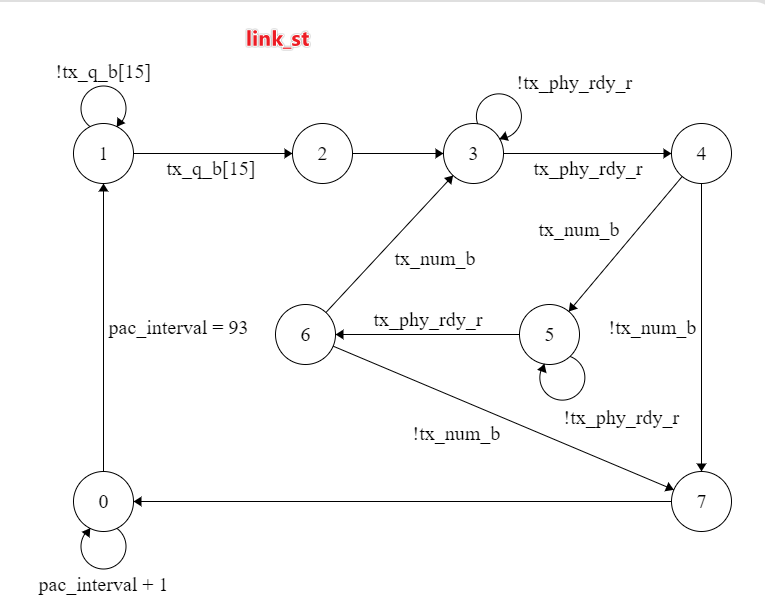
图9 link_st状态转移图
(2)顶层文件接口修改
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 |
module hs_txrx #( parameter IDLE = 10'b1010_1010_10 ) ( input inclk, input pll_rst, input [ 10: 0 ] tx_addr, input [ 15: 0 ] tx_data, input tx_en, output[ 15: 0 ] tx_q, output tx, input rx, output rx_data_vld, output rx_data_rdy, output [ 7: 0 ] rx_data, output clk_100M, output pll_locked ); wire clk_400M; wire rst = !pll_locked; trans_data_link #( .IDLE( IDLE ) ) trans_data_link_inst ( .rst ( rst ), .clk_100M ( clk_100M ), .tx_addr_a ( tx_addr ), .tx_data_a ( tx_data ), .tx_en_a ( tx_en ), .tx_q_a ( tx_q ), .tx_out ( tx ) ); recv_data_link # ( .SYNC_START1( 10'b0011111010 ), //K28.5 with dipin=0; .SYNC_START2( 10'b1100000101 ), //K28.5 with dispin=1 .SYNC_END1 ( 10'b0011111001 ), //K28.1 with dipin=0; .SYNC_END2 ( 10'b1100000110 ) //K28.1 with dispin=1 ) recv_data_link_inst ( .rst ( rst ), .clk_100M ( clk_100M ), .clk_400M ( clk_400M ), .rx ( rx ), .link_rx_data_rdy ( rx_data_rdy ), .link_rx_data ( rx_data ), .link_rx_data_vld ( rx_data_vld ) ); pll1 pll1_inst ( .areset ( pll_rst ), //1'b0; .inclk0 ( inclk ), .c0 ( clk_100M ), .c1 ( clk_400M ), .locked ( pll_locked ) ); endmodule |
(3)仿真文件如下:
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 122 123 124 125 126 127 128 129 130 131 132 133 134 135 136 137 138 139 140 141 142 143 144 145 146 147 148 149 150 151 152 153 154 155 156 157 158 159 160 161 162 163 164 165 166 167 168 169 170 171 172 173 174 175 176 177 178 179 180 181 182 183 184 185 186 187 188 189 190 191 192 193 194 195 196 197 198 199 200 201 202 203 204 205 206 207 208 209 210 211 212 213 214 215 216 217 218 219 220 221 222 223 224 225 226 227 228 229 |
`timescale 1 ns / 1 ps module tb_pinpong ( ); parameter [ 10: 0 ] LEN = 16; parameter PERIOD = 20 ; //周期20 parameter IDLE = 10'b1010_1010_10; reg inclk ; // 模拟板级提供的输入时钟 initial begin inclk = 1'b0; #( PERIOD / 2 ); forever #( PERIOD / 2 ) inclk = ~inclk; end reg pll_rst; //实体模块PLL的rst信号 wire tx_rx; // 收发在testbench的回环信号 wire clk_100M; wire pll_locked; //实体PLL锁定信号 wire rst = !pll_locked; //Testbench内生成复位信号 reg [ 9: 0 ] tx_addr_r; reg tx_pinpong; wire [ 10: 0 ] tx_addr = { tx_pinpong, tx_addr_r }; reg [ 15: 0 ] tx_data; //待发送数据 reg [ 7: 0 ] tx_data_r; reg tx_en; wire [ 15: 0 ] tx_q; wire rx_data_vld; wire rx_data_rdy; wire [ 7: 0 ] rx_data; reg [ 7: 0 ] frame_len; reg [ 2: 0 ] tx_st; initial begin pll_rst = 1'b1; #50 pll_rst = 1'b0; end //=====================================schedule for multi_task or multi_procedure ; reg tx_rdy; //master schedule and authorise tx precudure become active stream. reg tx_rdy_ack; reg [ 2: 0 ] sch_st; //mimic master schedule, always@( posedge clk_100M or posedge rst ) if ( rst ) begin tx_rdy <= 0; sch_st <= 0; end else case ( sch_st ) 0: begin tx_rdy <= 1'b1; if ( tx_rdy_ack ) begin tx_rdy <= 1'b0; sch_st <= 1; end end 1: begin sch_st <= 2; end 2: begin sch_st <= 3; end 3: begin sch_st <= 4; end 4: begin sch_st <= 5; end 5: begin sch_st <= 6; end 6: begin sch_st <= 7; end 7: begin sch_st <= 0; end default: sch_st <= 0; endcase wire [ 7: 0 ] tx_data_p = tx_data_r + 1; always@( posedge clk_100M or posedge rst ) if ( rst ) begin frame_len <= 0; tx_addr_r <= 1023; tx_pinpong <= 0; tx_data <= 0; tx_data_r <= 0; tx_en <= 1'b0; tx_rdy_ack <= 0; tx_st <= 0; end else begin case ( tx_st ) 0: begin tx_addr_r <= 1023; tx_pinpong <= 0; tx_data <= 0; tx_rdy_ack <= 0; frame_len <= 0; tx_st <= 1; end 1: begin tx_rdy_ack <= 0; if ( tx_rdy ) tx_st <= 2; end 2: begin if ( tx_q[ 15 ] ) tx_st <= 6; else tx_st <= 3; end 3: begin if ( frame_len >= LEN ) begin tx_en <= 1'b0; tx_st <= 4; end else begin tx_data <= { tx_data_p, tx_data_r }; frame_len <= frame_len + 2; tx_addr_r <= tx_addr_r + 1; tx_data_r <= tx_data_r + 2; tx_en <= 1'b1; end end 4: begin tx_data <= { 1'b1, 4'b0, LEN }; frame_len <= 0; tx_addr_r <= 1023; tx_en <= 1'b1; tx_st <= 5; end 5: begin tx_en <= 1'b0; tx_pinpong <= tx_pinpong + 1'b1; tx_st <= 6; end 6: begin tx_rdy_ack <= 1'b1; tx_st <= 7; end 7: begin tx_rdy_ack <= 1'b0; tx_st <= 1; end default: tx_st <= 0; endcase end hs_txrx #( .IDLE( IDLE ) ) hs_txrx_inst ( .inclk ( inclk ), .pll_rst ( pll_rst ), .tx_addr ( tx_addr ), .tx_data ( tx_data ), .tx_en ( tx_en ), .tx_q ( tx_q ), .tx ( tx_rx ), .rx ( tx_rx ), .rx_data_vld( rx_data_vld ), .rx_data_rdy( rx_data_rdy ), .rx_data ( rx_data ), .clk_100M ( clk_100M ), .pll_locked ( pll_locked ) ); endmodule |
tx_st状态机转移图如下所示:
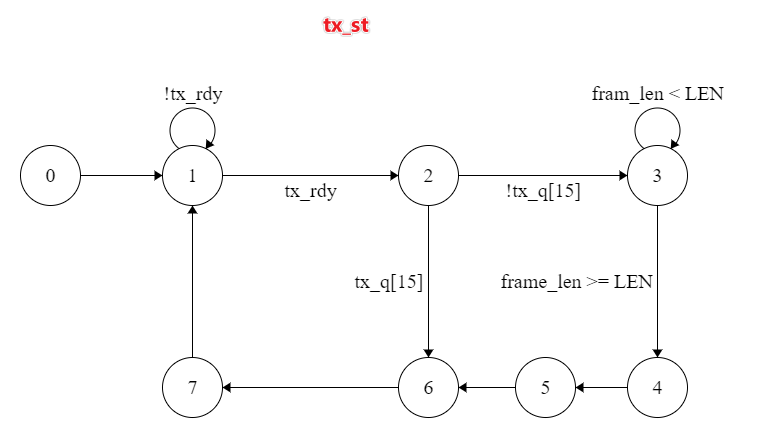
图10
3. 仿真
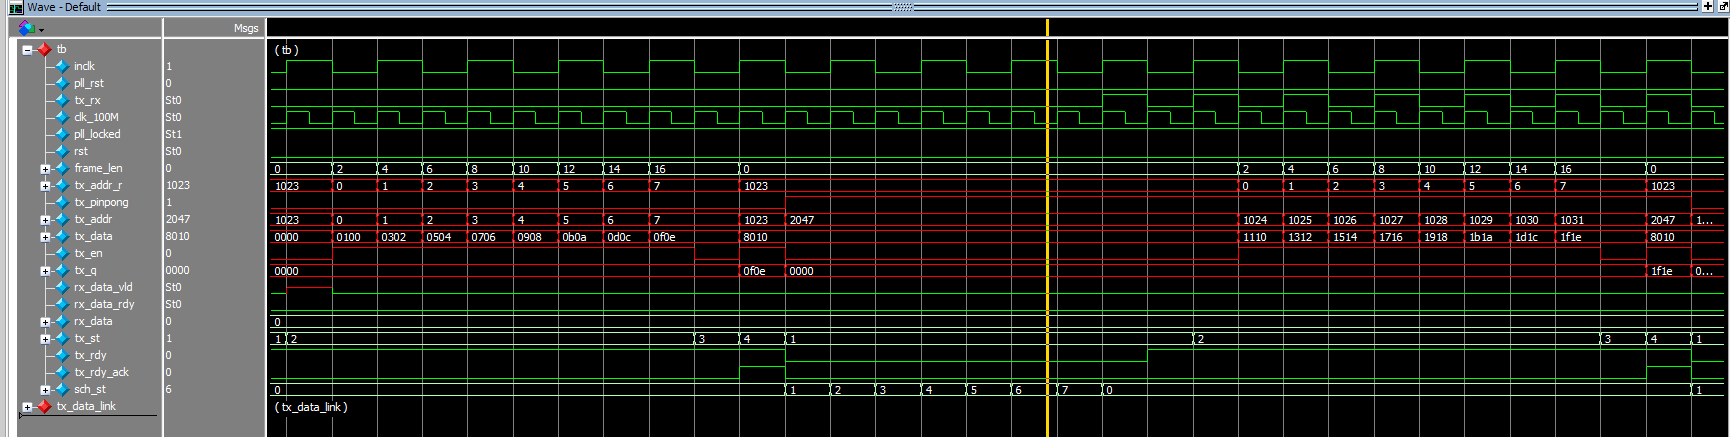
图11 -1 tb_pingong.v 仿真波形1
图11-1 展示了对data_link层乒乓buffer的写控制,注意观察乒乓buffer写端控制字的状态以及应用层的任务调度tx_rdy的状态。看看APP层是否已经由原来的慢速写入(由于发送没有数据缓冲与发送端各层形成了胶着逻辑)变成需要时快速写入,将有更多的时间处理其它任务。
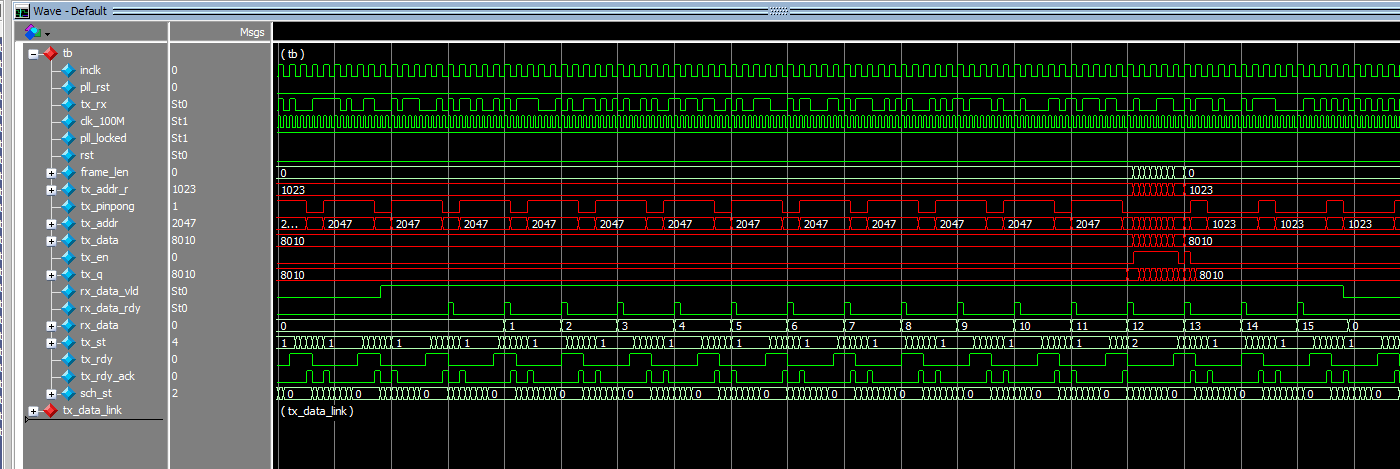
图11 -2 tb_pingong.v 仿真波形2
查看图11-2波形中接收数据是否与发送数据一致。
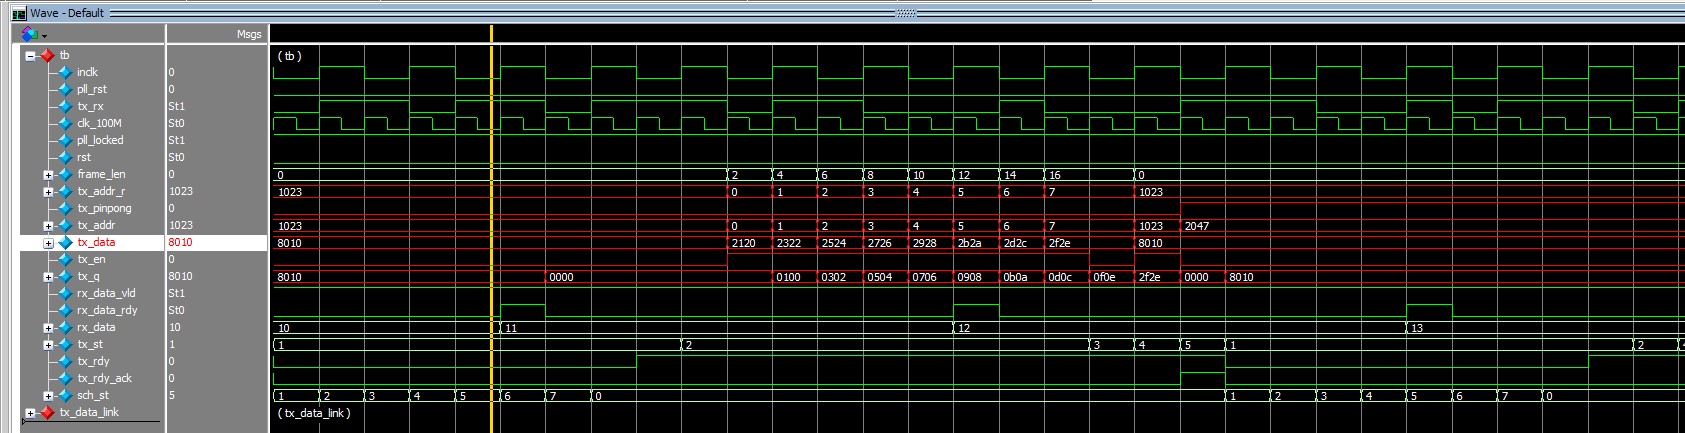
图11 -3 tb_pingong.v 仿真波形3
图11-3显示了,一旦乒乓Buffer有空余的存储空间,并且调度任务满足写过程要求(tx_rdy),完成写数据包操作。
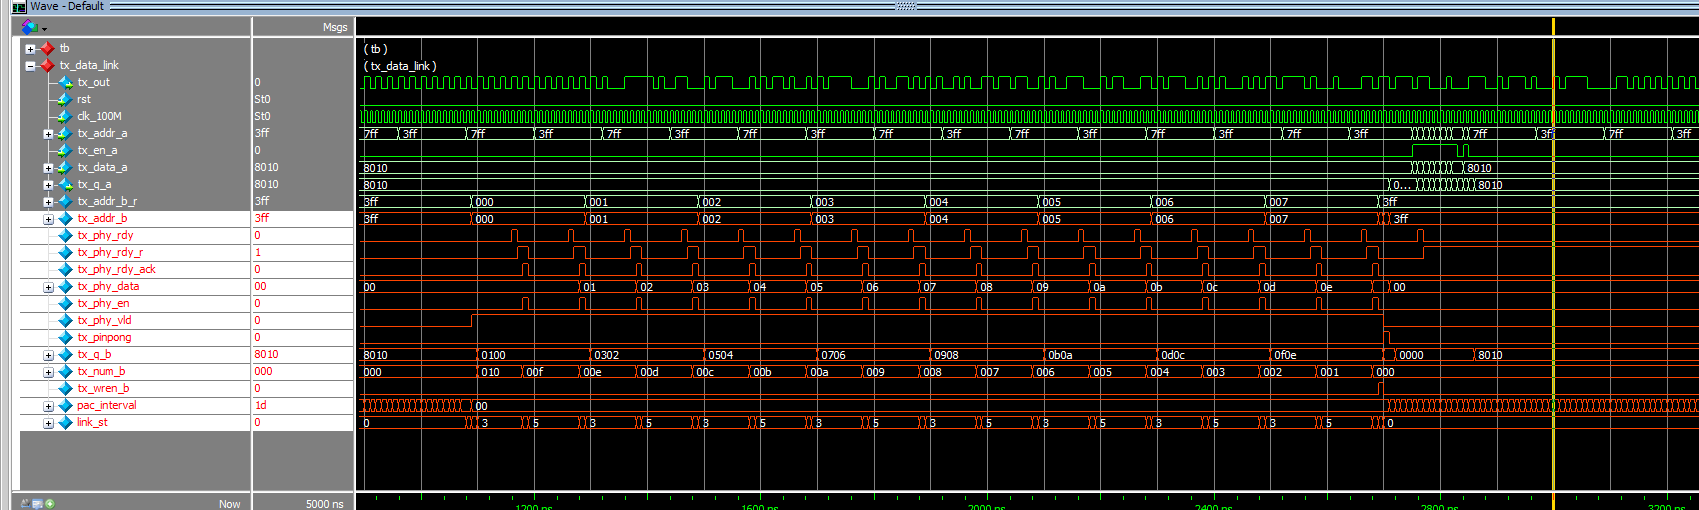
图12 data-link层 乒乓Buffer数据读出与Phy层接口
总结:在数据链路层加入乒乓Buffer后,打破了发送端各层的胶织逻辑(glue logic), 使异步过程的调度更加流畅,对于提高系统整体性能起到了关键作用。乒乓Buffer的数量越多,对异步过程的处理效果也会越好,但FPGA的资源消耗也会随着增加。
本程序虽然提供仿真,但是并没有经过严格测试,开发者至少提供不同包长以及包中字节为奇数的测试。
由于本次课程的程序较长,对程序细节并没有仔细解释,细节解释请观看对应的视频。
quartus 工程文件
[content_control]
[/content_control]