在计算机内部,CPU 需要不断读取指令、处理数据并保存计算结果。为了提高运行速度,现代处理器使用了多种不同的存储结构,包括寄存器(Register)、高速缓存(Cache)、内存(RAM)和硬盘或 SSD。
其中,寄存器是距离 CPU 执行单元最近、访问速度最快的存储结构之一。它能够直接参与指令执行,是现代处理器不可缺少的组成部分。
那么,寄存器究竟是什么?它和 CPU 缓存、内存有什么区别?为什么 CPU 不能全部使用寄存器来保存数据?
一、什么是寄存器?
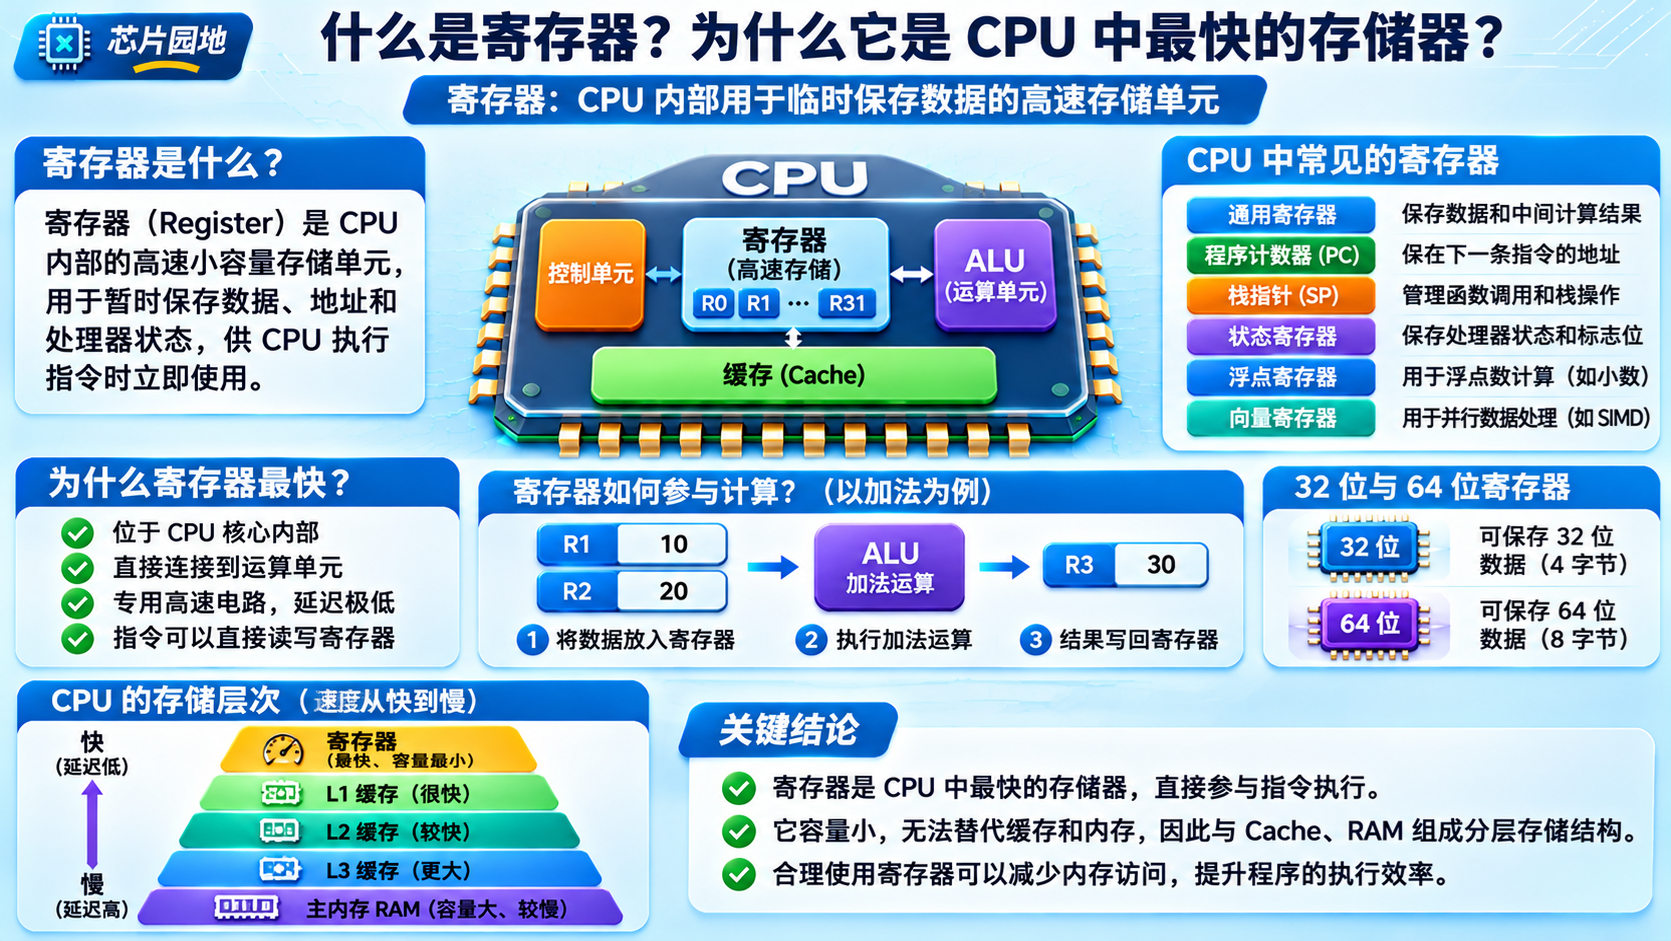
寄存器(Register)是 CPU 内部用于临时保存数据、地址和处理器状态的小容量存储单元。
当 CPU 执行程序时,经常需要把数据放入寄存器,然后由算术逻辑单元(ALU)或其他执行单元进行计算。
例如,计算两个数字相加时,CPU 可以把两个操作数放入寄存器,执行加法指令,然后将计算结果保存到另一个寄存器中。
与普通内存不同,寄存器直接属于处理器的执行体系结构,许多机器指令可以直接指定寄存器作为输入或输出。
寄存器的主要作用不是长期保存数据,而是让 CPU 能够快速取得当前执行指令所需要的信息。
二、寄存器是如何工作的?
假设 CPU 需要执行一个简单的加法:
A = B + C
在一种典型的寄存器计算方式中,处理器首先把 B 和 C 的数值放入寄存器。
随后,加法执行单元读取这两个寄存器中的数据,完成加法运算,再把结果写入目标寄存器。
例如,在 RISC-V 处理器中,可以使用下面的指令:
add x5, x6, x7
这条指令的含义是将寄存器 x6 和 x7 中的数值相加,并把结果写入寄存器 x5。
在这个例子中,三个操作数都位于 CPU 寄存器中,因此加法指令本身不需要访问主内存。
不过,如果原始数据保存在内存中,CPU 通常需要先执行加载指令,将数据读取到寄存器。计算结束后,如果结果需要保存到内存,还要执行存储指令。
这就是寄存器在 CPU 执行过程中发挥的重要作用。
三、CPU 内部有哪些寄存器?
现代处理器包含多种寄存器,不同寄存器负责不同的任务。
通用寄存器(General-Purpose Register): 用于保存整数、地址和中间计算结果,是程序执行过程中经常使用的寄存器。
程序计数器(Program Counter,PC): 保存与程序执行位置有关的指令地址,用于控制下一条指令的获取。遇到跳转或分支指令时,程序计数器会按照执行结果更新。
栈指针(Stack Pointer,SP): 保存栈相关的内存地址,用于函数调用、局部变量管理以及部分程序状态保存。
状态寄存器(Status Register): 保存处理器的控制信息或执行状态。在某些处理器架构中,还包含条件标志位,例如零标志和进位标志。
浮点寄存器(Floating-Point Register): 用于保存浮点运算数据,支持小数计算和科学计算。
向量寄存器(Vector Register): 用于保存多个数据元素,使处理器能够通过向量或 SIMD 指令并行处理多个数值。
不同 CPU 架构的寄存器类型、数量和使用方式并不完全相同。
四、为什么寄存器是 CPU 中最快的存储器?
寄存器速度快,主要与它的位置、硬件结构和访问方式有关。
首先,寄存器直接位于 CPU 核心内部,与执行单元紧密连接。处理器不需要通过外部内存总线来读取寄存器中的数据。
其次,寄存器通常使用专门设计的高速电路实现,具有较短的访问延迟。
第三,CPU 指令集和执行流水线通常针对寄存器操作进行了优化,可以高效读取操作数并写回计算结果。
相比之下,访问主内存需要经过缓存层次、地址转换和内存控制器等环节,延迟通常明显更高。
不过,寄存器并不是所有情况下都能在零等待时间内访问。实际访问延迟取决于处理器架构、寄存器文件设计以及具体执行单元。
因此,更准确地说,寄存器属于 CPU 中访问速度最快的存储资源之一。
五、寄存器、Cache 和 RAM 有什么区别?
寄存器、高速缓存和主内存构成了计算机存储层次结构中的不同部分。
寄存器(Register): 位于 CPU 核心内部,容量非常小,主要保存当前指令和计算过程需要的数据。
一级缓存(L1 Cache): 通常位于 CPU 核心内部,保存近期使用的指令和数据,减少访问更低层存储的次数。
二级缓存(L2 Cache): 容量一般比 L1 更大,但访问延迟通常也更高。
三级缓存(L3 Cache): 通常由多个 CPU 核心共享,容量较大,用于降低访问主内存的频率。
主内存(RAM): 保存正在运行的程序及其数据,容量远大于寄存器和 CPU 缓存,但访问延迟通常更高。
从典型访问延迟来看,大致可以理解为:
寄存器 → L1 Cache → L2 Cache → L3 Cache → RAM
越靠近 CPU 执行单元,存储结构通常越快,但容量也越小。
需要注意,这只是简化的存储层次模型。现代处理器可能采用不同的缓存组织方式,寄存器访问也不能与缓存读取简单地用同一种指标进行比较。
六、为什么 CPU 不把所有数据都放在寄存器中?
既然寄存器速度如此快,为什么 CPU 不使用大量寄存器替代内存?
主要原因是芯片面积、功耗、硬件复杂度和成本。
寄存器需要专门的高速电路实现,而且处理器通常需要同时从多个寄存器读取数据、向寄存器写入结果。
如果寄存器数量大幅增加,寄存器文件的面积、布线复杂度、访问延迟和功耗都可能随之上升。
此外,程序需要处理的数据量可能达到数 GB,甚至数百 GB,而 CPU 寄存器能够保存的数据量非常有限。
因此,现代计算机采用分层存储结构,让寄存器保存当前最需要的数据,Cache 保存近期使用的数据,而 RAM 保存更大规模的程序和数据。
这种设计可以在性能、容量和成本之间取得平衡。
七、32 位和 64 位寄存器是什么意思?
寄存器的位宽决定了它能够保存多少位二进制数据。
例如,一个 32 位寄存器可以保存 32 个二进制位,而一个 64 位寄存器可以保存 64 个二进制位。
在许多 64 位处理器架构中,通用整数寄存器的宽度为 64 位,可以保存 64 位整数或相关地址数据。
例如,RISC-V 的 RV32I 基础整数指令集使用 32 位通用整数寄存器,而 RV64I 使用 64 位通用整数寄存器。
但是,32 位和 64 位处理器的区别并不只是寄存器宽度,还涉及指令集、地址表示、软件执行环境和其他体系结构规定。
此外,现代处理器还可能包含 128 位、256 位、512 位或其他宽度的向量寄存器,用于执行并行数据处理。
八、CPU 核心越多,寄存器也越多吗?
通常,每个 CPU 核心都有自己的寄存器资源。
例如,一颗八核处理器包含八个物理核心,每个核心都需要独立执行指令,因此通常具有各自的整数寄存器文件和其他相关寄存器资源。
不过,这并不意味着八个核心简单共享同一组通用寄存器。
在支持同步多线程(SMT)的处理器中,同一个物理核心还可能同时维护多个硬件线程各自的架构寄存器状态。
因此,实际寄存器组织方式取决于处理器架构、核心数量和线程实现方式。
现代高性能 CPU 还可能使用寄存器重命名(Register Renaming)技术,将程序可见的架构寄存器映射到更多内部物理寄存器,以支持乱序执行并减少不必要的数据依赖。
九、寄存器与 CPU 指令集有什么关系?
寄存器是处理器指令集架构(ISA)的重要组成部分。
不同 CPU 架构定义了不同数量和类型的程序可见寄存器。
例如,RISC-V 的 RV32I 和 RV64I 基础整数指令集定义了 32 个通用整数寄存器,编号为 x0 到 x31。
其中,x0 始终表示数值零,写入 x0 的结果会被丢弃。
ARM 和 x86-64 也有各自的寄存器体系结构。
在编写汇编程序时,程序员可以直接通过寄存器名称指定数据来源和结果位置。
在使用 C、C++ 或 Rust 等高级语言编程时,编译器通常会根据程序逻辑和优化规则,决定如何使用寄存器保存变量和中间结果。
因此,寄存器不仅是硬件结构,也是连接软件指令与 CPU 执行单元的重要组成部分。
十、寄存器为什么会影响程序性能?
寄存器数量和使用效率会影响 CPU 执行程序的速度。
如果程序需要的临时数据能够保存在寄存器中,处理器就可以减少不必要的内存读取和写入操作。
但是,如果同时需要保存的数据超过了可用寄存器资源,编译器可能需要把部分数据临时保存到内存中。这种情况称为寄存器溢出(Register Spilling)。
发生寄存器溢出后,程序可能需要执行额外的加载和存储指令,从而增加执行开销。
现代编译器会使用寄存器分配(Register Allocation)等优化技术,尽可能让频繁使用的数据保存在寄存器中。
对于高性能软件、编译器、操作系统和处理器设计来说,理解寄存器的使用方式非常重要。
总结
寄存器是 CPU 内部用于临时保存数据、地址和处理器状态的高速存储单元,也是 CPU 执行机器指令的重要基础。
它之所以速度快,是因为寄存器位于处理器核心内部,与执行单元紧密连接,并采用针对高速访问优化的硬件结构。
但是,寄存器容量小、硬件成本高,无法替代 Cache 和主内存,因此现代计算机采用分层存储体系,在访问速度、存储容量和成本之间取得平衡。
理解寄存器的工作原理,有助于进一步学习 CPU 架构、汇编语言、RISC-V 指令集、程序编译、寄存器重命名以及现代处理器的流水线执行机制。