d-Matrix:用数字存内计算突破 AI 推理“内存墙”的芯片公司
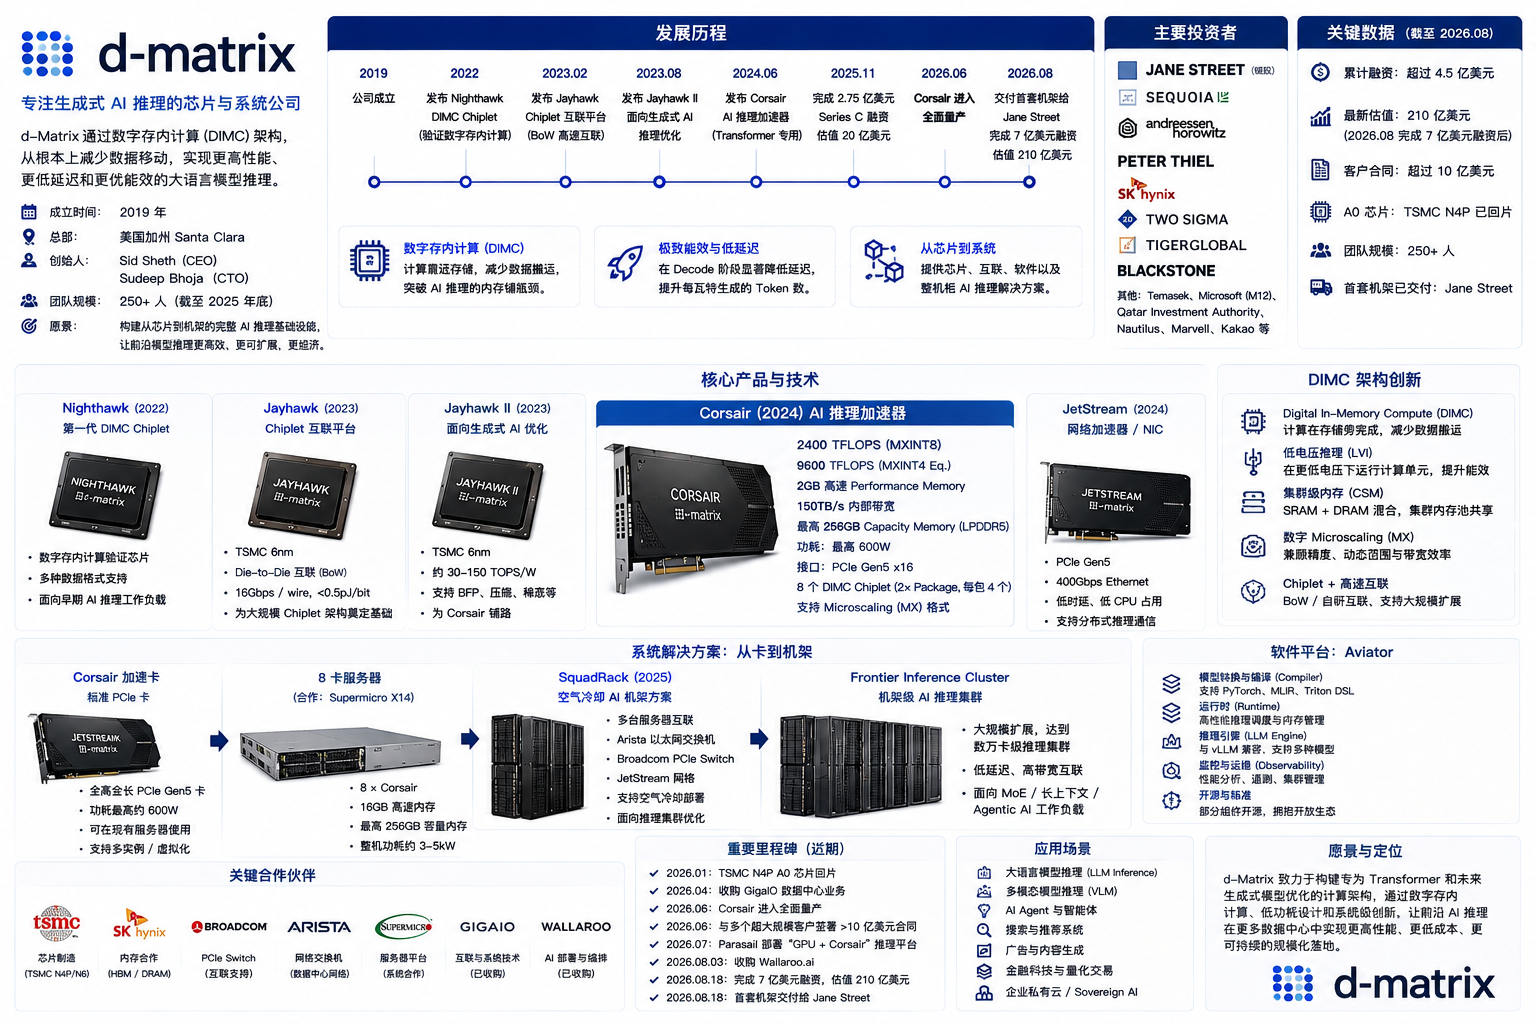
d-Matrix 是一家专注于 生成式 AI 推理芯片、数字存内计算、Chiplet、高速互联和机架级 AI 基础设施 的美国半导体公司。
如果 Nvidia 的核心路线可以概括为:GPU + HBM + CUDA
那么 d-Matrix 选择的是一条非常不同的路线:Digital In-Memory Compute,数字存内计算。简称:DIMC。
它希望解决现代大型语言模型越来越严重的一个问题:计算核心已经很快,但数据移动速度跟不上。
尤其在大模型推理的 Decode 阶段,AI 芯片经常需要不断从显存中读取模型权重和 KV Cache。
大量计算单元实际上并不是在计算,而是在:等待数据。
d-Matrix 因此把部分计算能力直接放到高速存储结构旁边,通过大规模 SRAM、数字存内计算、Chiplet 和高速互联,尽量缩短 Memory → Compute 之间的距离。
截至 2026 年,公司最重要的产品已经形成:
JetStream 网络加速器
Aviator 软件平台
以及:
SquadRack 机架级 AI 推理系统。
2026 年 6 月,Corsair 已经正式进入全面量产,并开始向 Hyperscaler、Neocloud 和 Frontier AI Lab 等优先客户批量交付。
d-Matrix 成立于 2019 年
d-Matrix 成立于:2019 年。
总部位于:美国加州 Santa Clara。
公司目前还在:加拿大 Toronto、澳大利亚 Sydney、印度 Bangalore 以及 塞尔维亚 Belgrade 设有团队或办公室。
截至 2025 年底,公司员工规模已经超过 250 人。
d-Matrix 与很多 2022 年以后突然出现的“生成式 AI 芯片公司”不同。它成立的时候 ChatGPT 还不存在。大语言模型还没有成为全球科技产业最热门的方向。
但是公司创始团队当时已经判断:AI 真正长期烧钱的部分,很可能不是 Training,而是 Inference。
也就是说 训练模型可能只发生有限次数,但模型上线以后可能每天被调用 几百万、几亿 , 甚至 几十亿次。
如果未来 AI 无处不在,那么真正巨大的长期计算账单,很可能来自 推理。这成为 d-Matrix 从成立开始最重要的战略判断。
两位创始人都来自高速数据中心芯片行业
d-Matrix 的两位联合创始人是:Sid Sheth 和 Sudeep Bhoja。
Sid Sheth 目前担任 Founder & CEO。
Sudeep Bhoja 担任 Founder & CTO。
两人在创办 d-Matrix 以前,都曾在 Inphi 工作。Inphi 是一家专门开发高速数据中心互联芯片的半导体公司,后来被 Marvell 收购。
更早以前,两人也拥有 Broadcom 等半导体企业的经验。这段背景对于理解 d-Matrix 非常重要。
因为大型 AI 系统最终不只是 一颗芯片做多少次乘法。还需要解决 内存、芯片互联、服务器互联、网络 以及 数据中心扩展。
而 d-Matrix 两位创始人本身就长期从事 Data Center Interconnect。
这也解释了为什么公司后来很快从 一颗 DIMC 芯片 扩展到 Chiplet + Networking + Rack。
d-Matrix 最初其实试过模拟存内计算
d-Matrix 早期并不是一开始就确定使用今天的数字 DIMC。
Sid Sheth 曾回顾,公司最初研究过 Analog In-Memory Compute。也就是 模拟存内计算。
这种方法可以直接利用存储阵列内部的电流、电荷等模拟特性完成矩阵运算。理论上能效非常高。
但是模拟计算存在 精度、噪声、ADC、工艺变化,以及 软件控制复杂度 等问题。
d-Matrix 最终认为 对于真正的数据中心商业产品来说,模拟方案工程复杂度太高。
于是公司转向 Digital In-Memory Compute。这成为 d-Matrix 与很多其他存内计算创业公司的最大区别之一。
什么是 Digital In-Memory Compute?
传统计算机的基本结构可以简单理解成 Memory 和 Compute 是分开的。数据存放在 DRAM 或 HBM 中。
计算单元需要数据的时候 首先把数据读取出来,经过总线,进入计算单元,完成运算以后,结果再写回内存。这个过程已经持续几十年。
问题是:现代 AI Processor 的乘法器发展速度太快。
一颗芯片可能拥有 数万甚至更多计算单元。但是 Memory Bandwidth 并没有以同样速度增长。
结果就是 计算单元越来越快,却越来越容易 饿死。也就是 没有数据可以算。
这就是所谓:Memory Wall,内存墙。
d-Matrix 的思路:把计算放进存储附近
Digital In-Memory Compute 的核心思想,是把 矩阵乘法相关计算 与 高速数字存储阵列 紧密结合。
这样数据不必每次都跨越很长距离:DRAM → Bus → Compute Core。
很多计算可以直接在 Memory Array 附近 完成。
从芯片架构角度来看,这相当于减少了 Data Movement。
而现代 AI 芯片非常重要的一个规律就是:搬运数据往往比做一次乘法更加耗电。
因此减少数据移动,不仅可以提高性能,还可能明显降低功耗。这就是 d-Matrix DIMC 架构最核心的逻辑。
Nighthawk:第一代 DIMC 技术验证
2022 年,d-Matrix 正式公开:Nighthawk。Nighthawk 是公司的早期数字存内计算 Chiplet。
它最重要的目的并不是 马上取代 Nvidia GPU。而是证明:Digital In-Memory Compute 可以真正做成 Silicon。
当时公司完成 4400 万美元融资,并公开 Nighthawk DIMC Chiplet。
投资者包括:Playground Global、M12,也就是 Microsoft Venture Fund、SK Hynix、Nautilus Venture Partners、Marvell Technology 等。
这也让 d-Matrix 从早期技术创业公司逐渐进入 AI 半导体行业视野。
Jayhawk:开始进入 Chiplet 时代
Nighthawk 以后,d-Matrix 在 2023 年推出:Jayhawk。
Jayhawk 最大变化之一,是加入:Chiplet Die-to-Die Interconnect。
d-Matrix 使用开放的:Bunch of Wires,BoW,标准连接 Chiplet。
Jayhawk 使用 TSMC 6nm 制造。
公司公布的 Die-to-Die 连接能力达到:16Gbps / wire。 能源效率低于 0.5pJ/bit。这代表 d-Matrix 已经意识到 单颗芯片不可能无限扩大。未来 AI Processor 很可能需要使用 Chiplet。
为什么 d-Matrix 很早就选择 Chiplet?
如果把所有功能全部放在一颗 Monolithic Die 里面,会产生几个问题。
首先是:芯片面积越来越大。面积越大 ,晶圆良率越低。
其次: 先进工艺芯片制造成本极高。
第三 :不同功能并不一定全部需要最先进制程。
Chiplet 因此开始成为:AMD、Intel、Nvidia,以及越来越多 AI 芯片企业的重要方向。
d-Matrix 的思路是 把 DIMC Compute + Memory 做成可扩展 Chiplet。
然后使用高速 Die-to-Die Interface,把多个 Chiplet 像 Lego 一样组合起来。
Jayhawk II:为生成式 AI 重新优化
2023 年 ChatGPT 爆发。
d-Matrix 很快发布:Jayhawk II。
这一代 DIMC Engine 已经明确针对:Large Language Model 以及 Generative AI Inference。
Jayhawk II 同样使用 6nm 工艺。
公司当时表示,其 DIMC Engine 可以实现 约 30 到 150 TOPS/W 的计算效率范围,并支持 Floating Point、Block Floating Point、Compression 以及 Sparsity。
更加重要的是:Jayhawk II 不再只是技术验证芯片。它开始直接为后来 Corsair 商业产品铺路。
2023 年融资 1.1 亿美元
2023 年 9 月:d-Matrix 完成 1.1 亿美元 Series B。这一轮由 Temasek 领投。
融资的重要目标就是:把前面的 Nighthawk、Jayhawk I、Jayhawk II 技术真正转化成 Corsair 商业 AI 加速器。
这也是 d-Matrix 从“Chiplet 技术公司”进入“AI 产品公司”的关键阶段。
Corsair:d-Matrix 当前真正的核心产品
2024 年 d-Matrix 正式公开:Corsair。Corsair 是目前 d-Matrix 整个业务最核心的 AI 推理平台。
它把公司多年来开发的 DIMC,Chiplet,Die-to-Die Interconnect,Block Floating Point 以及 Aviator Software 整合到同一个商业产品中。
Corsair 采用 标准 PCIe Gen5 全高全长加速卡 形式。这意味着数据中心可以像安装 GPU 一样, 直接把 Corsair 安装进普通服务器。
一张 Corsair 卡里面实际上有 8 个 Chiplet
Corsair 的内部结构很有意思。
一张卡拥有 两个 Package。
每个 Package 包含 4 个 DIMC Chiplet。
所以整张 Corsair Card 一共有 8 个 Chiplet。
这些 Chiplet 通过 DMX Link 高速连接。
两张 Corsair 卡之间还可以通过 DMX Bridge 继续扩展。
这意味着 d-Matrix 从一开始就没有把 Corsair 当成 孤立的 PCIe Accelerator。
它希望把大量 DIMC Chiplet 组成一个 可扩展 Memory-Compute Fabric。
Corsair 的一个关键数字:150TB/s
Corsair 最引人注意的参数之一就是:Memory Bandwidth。
一张卡集成 2GB Performance Memory。这部分高速存储直接与 DIMC Compute 紧密结合。
官方公布的内部带宽达到:150TB/s。不是 150GB/s。而是 150 Terabytes per second。这也是 d-Matrix 与传统 GPU 最大的技术区别。
传统 GPU 依赖 HBM。HBM 已经非常快。
但是 DIMC 通过把 Compute 和 SRAM 紧密结合,使内部数据传输带宽可以达到完全不同的数量级。
为什么只有 2GB 高速内存?
这也是 Corsair 很容易被误解的地方。2GB 看起来非常小。
Nvidia GPU 已经拥有 80GB、96GB、甚至更大的 HBM。
但是 d-Matrix 并不是希望 把整个模型全部塞进这 2GB。
Corsair 实际上采用 两层内存。
第一层:Performance Memory。也就是 2GB 超高速 SRAM-Based Integrated Memory。
第二层:Capacity Memory。
Corsair 可以配置最高:256GB Off-Chip Memory。
因此可以简单理解为:超高速小内存 ,较慢但容量大的外部内存。这很像 CPU Cache 的思想。
从概念上理解,可以把 Corsair 的 Memory Hierarchy 想象成:CPU Cache 和 Main Memory 之间的关系。
真正需要极高速访问的数据 尽量留在高速 SRAM。不需要立即使用的大量权重 保存在更大的 Capacity Memory 中。
软件和编译器负责决定:什么数据什么时候进入 Performance Memory。
因此 Corsair 真正的竞争力不仅来自硬件。也来自 Compiler。
Corsair 峰值 AI 算力
Corsair 官方技术资料显示:单卡峰值 Dense Compute 达到 2400 TFLOPS MXINT8。 以及 9600 TFLOPS MXINT4 Equivalent。
需要特别注意:MXINT8 和 MXINT4 是 Microscaling / Block Floating Point 相关数据格式。
因此不能简单把这个数字与 Nvidia 某张 GPU 的普通 INT8 或 FP8 峰值算力直接一一比较。不同 值格式、稀疏率、模型、Batch Size 都会产生巨大影响。
评价 AI 推理芯片更加实际的指标应该是:Tokens/s,Latency,Tokens/Watt,以及 Tokens/Dollar。
Block Floating Point 是 d-Matrix 的另一项核心技术
d-Matrix 很早就采用:Block Floating Point。
今天 OCP 将类似格式标准化为:MX,Microscaling。
普通 Floating Point 中 每个数字都拥有自己的 Exponent。
Block Floating Point 则允许一组数字 共享某些 Scale 或 Exponent 信息。这样可以减少 硬件复杂度、存储量 和 数据带宽。同时又比普通整数量化保留更多动态范围。
d-Matrix 当前支持:MXINT8 和 MXINT4 等数值格式。
这与 Nvidia、AMD 和其他 AI 芯片公司目前大量进入 FP8、FP4、INT4 低精度计算 属于同一个产业趋势:AI 推理越来越不需要 FP32。
Corsair 功耗约 600W
Corsair 一张 PCIe 卡的功率范围最高大约:600W。这比普通低功耗 NPU 高很多。但它仍低于目前部分高端液冷 GPU Accelerator 的极端功率水平。
更加重要的是 d-Matrix 的 SquadRack 设计目前强调可以 空气冷却。这对很多现有数据中心非常有吸引力。
因为 AI 数据中心最大的新成本之一已经不是芯片。而是 Power + Cooling。
d-Matrix 为什么越来越强调 Decode?
2026 年以后,d-Matrix 的市场定位发生了一个非常有意思的变化。
公司不再简单宣传 “Corsair 替代 GPU。” 而是越来越强调 GPU + Corsair。
原因就是大型语言模型推理可以分成:Prefill 和 Decode。
Prefill 是 模型首先处理用户输入。它需要大量矩阵计算。这一阶段 GPU 非常擅长。
Decode 则是 一个 Token、一个 Token 产生输出。Decode 通常更加 Memory Bound。这正好是 Corsair 的优势。
GPU 做 Prefill,Corsair 做 Decode
这就形成一种新的架构:
GPU → Prefill
Corsair → Decode
两种芯片各自执行自己最擅长的工作。
这种方法称为:Disaggregated Inference。
2026 年,d-Matrix 与 Gimlet Labs 的测试显示,在特定工作负载下,将 Corsair 与 GPU 组合后,一个原本约 24 秒 的响应可以减少到 不到 2 秒。
需要强调:这不是说 Corsair 在所有 AI 模型中都比 Nvidia GPU 快十倍。这是特定 异构、解耦推理 Pipeline 下的测试结果。但这种技术方向非常值得关注。
2026 年 Parasail 已经开始商业部署 GPU + Corsair
2026 年 7 月,AI Inference Cloud 公司 Parasail 宣布部署 d-Matrix Corsair。
更加有意思的是,Parasail 并没有把 Nvidia GPU 全部删除。
它选择:Nvidia Hopper / Blackwell ,d-Matrix Corsair。
Parasail 表示,这种组合针对部分推理服务可以获得最高约 10 倍更快 Token Generation 以及更好的成本效率。
这是 d-Matrix 商业战略上的一个重要变化:不一定与 Nvidia 正面竞争。而可以成为:Nvidia GPU 的推理加速伙伴。
这可能是一条非常现实的路线
直接告诉客户 “把所有 Nvidia GPU 扔掉,全部换成我的芯片。” 通常非常困难。
因为 Nvidia 已经拥有:CUDA、PyTorch、TensorRT、NCCL、NVLink 以及完整软件生态。
但是如果 d-Matrix 说:“继续保留 GPU,我只负责 Decode。” 迁移难度明显降低。
这样客户可以:
GPU 做 Prefill,
Corsair 专门做 高速 Token Generation。
这种 Heterogeneous Compute 可能成为 d-Matrix 最有现实意义的商业突破口。
JetStream:d-Matrix 开始自己解决网络问题
当一台服务器里面有很多 Corsair,或者多个服务器需要共同运行模型时,芯片之间必须交换大量数据。如果网络延迟比 DIMC 本身的计算延迟 还要高,整个系统性能就会被网络拖垮。
因此 d-Matrix 推出:JetStream。
JetStream 是 I/O Accelerator / Transparent NIC。
它采用 PCIe Gen5,并支持标准 Ethernet。
官方资料显示:JetStream 可以提供最高 400Gbps 网络带宽。
为什么使用标准 Ethernet 很重要?
Nvidia 有 NVLink 和 InfiniBand。这些技术性能非常强。但也让 Nvidia 能够控制 芯片、服务器 和 网络 整个生态。
d-Matrix 则更加倾向 Open Standards。
JetStream 使用 标准 Ethernet。
SquadRack 又使用 Arista Switch 和 Broadcom PCIe Switch。
这种路线的优点是 客户不需要完全进入某一家厂商的封闭系统。
它更接近 Composable AI Infrastructure。
SquadRack:d-Matrix 已经进入整机柜
2025 年,d-Matrix 发布:SquadRack。
SquadRack 是公司从 AI Chip Vendor 升级为 AI Infrastructure Vendor 的重要标志。
一套 SquadRack 主要整合:
JetStream Network Accelerator
Supermicro X14 AI Server
Broadcom PCIe Switch
Arista Ethernet Switch
以及:
Aviator 软件平台。
这实际上已经是一套完整:Rack-Scale AI Inference System。
SquadRack 不需要液冷
d-Matrix 当前特别强调:SquadRack 可以部署在 传统空气冷却数据中心。不需要专门建设液冷基础设施。这可能是一个非常实际的市场优势。
因为世界上绝大多数现有数据中心并不是为了 100kW、120kW 甚至更高功率 AI Rack 而建设的。
很多企业拥有大量 10kW、20kW、30kW 传统机柜。
如果为了 AI 把 供电、冷却、管路 全部重建,成本极高。
所以 “能不能装进现有数据中心?” 正在成为 AI 芯片的重要竞争指标。
Corsair 2026 年已经进入全面量产
2026 年 6 月 9 日,d-Matrix 正式宣布:Corsair 进入 Full Production。
公司表示已经获得 Hyperscaler、Neocloud 以及 Frontier AI Lab 的需求,并将在 2026 年夏季开始批量交付给优先客户。这一点非常重要。
因为过去几年,Corsair 的很多性能主要来自 公司测试、模拟器 以及客户 Early Access。
到了 2026 年,d-Matrix 才真正进入 Mass Production。
Corsair 使用 TSMC N6,而不是最新 3nm
Corsair 的制造路线也非常值得注意。
公司没有追求 TSMC 3nm 或者 2nm。
Corsair 使用 TSMC N6 并与 Alchip Technologies 合作制造。这看起来似乎不够先进。但是 d-Matrix 有自己的考虑。
TSMC N6 工艺成熟、价格相对低、产能容易获得、良率较高。
更加重要的是:Corsair 不需要昂贵的 HBM + CoWoS 封装。
不依赖 HBM,是 Corsair 一个非常大的供应链差异
当前高性能 AI GPU 几乎全部高度依赖 HBM。但是全球 HBM 供应非常紧张。
同时 HBM + Advanced Packaging 成本也非常高。
Corsair 当前使用 SRAM-Based DIMC,LPDDR5 Capacity Memory。而不是传统 HBM + CoWoS。
同时使用 Organic Substrate。
这让 d-Matrix 可以避开当前 AI 芯片产业最拥挤的 HBM / CoWoS 供应瓶颈。
对于一家创业公司来说:这可能是非常重要的量产优势。
但 d-Matrix 下一步又开始进入 3D DRAM
有意思的是,虽然 Corsair 当前刻意避开 HBM,d-Matrix 并没有认为 DRAM 不重要。
相反 公司下一代技术路线正在进一步把 Memory 和 Compute 靠得更近。
d-Matrix 已经开发:3DIMC。也就是 3D Stacked Digital In-Memory Compute。
简单来说 把 DRAM 通过 3D Stacking 直接放到计算 Die 上方。
Pavehawk:第一颗 3DIMC 芯片已经运行
2025 年,d-Matrix 宣布 第一颗 Pavehawk 3DIMC Silicon 已经在实验室运行。
Pavehawk 并不是当前量产的主要商业芯片。它更加像 下一代技术验证平台。
公司表示,Pavehawk 用于验证 DRAM Stacking 和 Digital In-Memory Compute 之间结合。
下一代架构叫 Raptor
d-Matrix 下一代正式架构:Raptor
计划进一步采用 3DIMC。也就是说 ,Corsair 的第一代商业逻辑是 SRAM DIMC + External Capacity Memory。
未来 Raptor 希望变成 3D DRAM + DIMC。
如果成功,这可能同时解决Corsair 当前一个明显限制:高速内存虽然非常快,但 容量仍然不够大。
3D Stacked DRAM 可以把 容量 和 低延迟 同时提高。
Aviator:d-Matrix 的软件平台
硬件只是 AI 芯片的一半。另一半仍然是 Software。
d-Matrix 的软件平台叫:Aviator。
Aviator 包括:模型转换、Compiler、Compression、Runtime、Inference Engine、Driver、Monitoring 以及 Distributed Inference 等功能。
它的任务就是, 让一个原来运行在 PyTorch 或者其他 AI 环境中的模型,能够被转换成 Corsair 可以运行的程序。
Aviator 尽量建立在开放软件之上
d-Matrix 没有试图从零重新制造整个 AI 开发生态。
Aviator 使用或兼容:PyTorch,MLIR,Triton DSL 以及 OpenBMC 等开放技术。这是一种非常务实的策略。
因为任何 AI 芯片创业公司都很难在几年内复制 CUDA 二十多年的生态。
更加现实的方法是 让开发者尽量继续使用已经熟悉的软件。
Qwen3 已经实现完整模型运行
2026 年 7 月,d-Matrix 与 Infinity 合作,把 Qwen3 完整模型部署到 Corsair。
双方从早期 Tensor Parallel 测试进一步推进到 完整 Stateful Multi-Token Inference。这也是 Corsair 软件成熟度的重要进展。
因为 跑一个 Matrix Multiplication Benchmark 和跑完整 LLM 完全不是一个问题。
真正的 LLM Inference 还要处理:Tokenizer、KV Cache、Attention、Sampling 模型并行 以及 连续 Token Generation。
2026 年 d-Matrix 开始通过收购补齐系统能力
d-Matrix 2026 年另外一个非常明显的变化是开始收购公司。
2026 年 4 月,d-Matrix 收购 GigaIO 的 Data Center Business。
GigaIO 的核心技术包括:SuperNODE 以及 FabreX PCIe Fabric。
同时 d-Matrix 获得了一支拥有机架级系统和高速互联经验的工程团队。
这说明 d-Matrix 已经认识到 仅仅设计 Corsair 不够。它还必须真正知道 怎样部署几十、几百张 Accelerator。
2026 年 8 月又收购 Wallaroo.ai
仅仅四个月以后的2026 年 8 月 3 日, d-Matrix 又宣布收购 Wallaroo.ai。
Wallaroo.ai 主要从事 AI Model Deployment 和 Inference Orchestration。
这次收购为 d-Matrix 增加了:Kubernetes、AI Deployment、Orchestration 以及 Production Inference方面的软件技术。
这样 d-Matrix 的能力就进一步变成:
Silicon
↓
Networking
↓
Rack
↓
Runtime
↓
Deployment
↓
Orchestration。
这是一条非常明显的:Full-Stack AI Infrastructure 路线。
d-Matrix 2025 年融资 2.75 亿美元
2025 年 11 月:
d-Matrix 完成 2.75 亿美元 Series C。
公司估值达到 20 亿美元。
累计融资达到 4.5 亿美元。
这一轮由:BullhoundCapital,Triatomic Capital 以及 Temasek 共同领投。
其他投资者包括:
Qatar Investment Authority
EDBI
M12,Microsoft Venture Fund
Nautilus Venture Partners
Industry Ventures 以及 Mirae Asset。
截至 2026 年 8 月,d-Matrix 仍然是一家 Private Company。目前没有公开完成 IPO。
SK Hynix 为什么很早就投资 d-Matrix?
SK Hynix 是全球最重要的 DRAM 和 HBM 公司之一。它早在 d-Matrix 早期融资阶段就已经参与投资。这实际上非常有战略意义。
因为 d-Matrix 的全部技术哲学几乎都围绕 Memory Bottleneck。
从 SRAM DIMC 到 3D Stacked DRAM,d-Matrix 一直在尝试改变 AI Processor 与 Memory 之间的关系。
所以拥有大型 Memory Manufacturer 作为产业投资者,对公司的未来技术路线显然非常重要。
d-Matrix 与 Nvidia 最大的区别
如果简单比较:
Nvidia 的核心可以概括成:GPU + HBM + CUDA + NVLink。
d-Matrix 则更加接近:DIMC + SRAM + Chiplet + JetStream + Aviator。
Nvidia 最大的优势是:通用性。GPU 可以同时承担:Training、Prefill、Decode、HPC 以及大量其他计算。
d-Matrix 则更加集中 Inference。尤其是 Memory-Bound Decode。
这意味着 d-Matrix 理论上可以在特定推理阶段更加高效。但它不能完全替代 GPU 的所有作用。
d-Matrix 现在甚至主动接受这一点
这也是公司 2026 年战略最成熟的地方之一。
它不再强调:“GPU 不需要了。” 而是提出 CPU + GPU + XPU 共同工作。
比如:
CPU 负责系统任务。
Corsair 负责 Low-Latency Decode。
JetStream 负责 数据传输。
Aviator 负责 软件调度。
这种 Heterogeneous Compute,很可能比所有芯片都强行竞争同一个工作负载更加合理。
d-Matrix 与 Groq 有什么不同?
Groq LPU 的核心优势是:Deterministic Execution。
Groq 尽量在编译阶段就决定:
每个数据什么时候移动,
每条指令什么时候执行。
这样可以实现非常低的 Single-User Latency。
d-Matrix 则更加关注:Memory Bandwidth。
它认为 Decode 最核心的问题是:数据移动。
所以它把 Memory 和 Compute 直接融合。
简单来说:
Groq 更加像是在解决:Scheduling Problem。
d-Matrix 更加像是在解决:Memory Problem。
d-Matrix 与 SambaNova 有什么不同?
SambaNova 同样非常重视 Dataflow 和 Memory。但是 SambaNova 的 RDU 是一种大型可重构数据流架构。
d-Matrix 则更加聚焦 Digital In-Memory Compute。
SambaNova 更像 让整个芯片根据模型数据流进行重构。
d-Matrix 更像 直接重新设计 Memory + Matrix Multiply 之间的物理关系。
两家公司的目标都是 减少数据移动。但实现方式非常不同。
d-Matrix 与 Etched 也完全不同
Etched 的技术赌注是:Transformer ASIC。它通过牺牲通用性,让芯片只为 Transformer 优化。
d-Matrix 则没有把 某一种 Transformer 操作 完全写死。
它更关注的是:Memory-Centric Architecture。
只要未来 AI 模型仍然存在 大量 Memory-Bound Matrix / Tensor Operation,DIMC 都可能继续拥有价值。
所以从架构风险来看,d-Matrix 比“只运行一种模型架构”的 ASIC 更加灵活。
d-Matrix 与 FuriosaAI 的竞争点
FuriosaAI RNGD 同样强调:Performance per Watt。
但 FuriosaAI 使用:
Tensor Contraction Processor
HBM3。
d-Matrix Corsair 则采用:
Digital In-Memory Compute
SRAM
LPDDR5。
FuriosaAI 试图通过 更加高效地执行 Tensor 提高利用率。
d-Matrix 则更直接 减少数据离开 Memory 的次数。
两者代表 AI 推理优化的两种不同哲学。
d-Matrix 最大优势之一:Memory Wall 是真实问题
无论未来模型采用 Transformer、MoE、Multimodal 还是 Agentic AI,只要模型参数继续扩大,Memory Bandwidth 都会是重大问题。
尤其在 Decode 阶段,大量时间不是用于 Arithmetic。而是 Memory Access。
因此 d-Matrix 选择 直接攻击 Memory Wall,从长期看是一个非常有逻辑的技术方向。
第二个优势:不依赖昂贵 HBM + CoWoS
Corsair 当前最现实的商业优势之一是 可以绕开 HBM 和 CoWoS 供应链。
Nvidia、AMD 以及大量 AI Accelerator 公司都在争夺 SK Hynix、Samsung、Micron 的 HBM。同时还争夺 先进封装产能。
d-Matrix 使用:N6、Organic Substrate、SRAM 以及 LPDDR5。供应链明显更加成熟。这可能帮助 Corsair 更快扩大产量。
第三个优势:可以安装进现有数据中心
Corsair 是 标准 PCIe Accelerator。
JetStream 也是 标准 PCIe。
SquadRack 使用 Ethernet。并且 不要求液冷。
这意味着很多企业不需要 重新建设整个 AI Data Center。对于 金融、电信、政府、普通企业 来说,这可能比峰值性能多 10% 更有吸引力。
第四个优势:d-Matrix 不再要求客户二选一
2026 年最值得注意的变化的是:
公司开始把 Corsair 定位成:GPU Complement。
而不是:GPU Replacement。这大幅降低了采用风险。
客户可以先保留 Nvidia GPU。只把部分 Decode Workload 转到 Corsair。如果确实省钱 ,再逐步扩大。这比一次性迁移整个 CUDA Infrastructure 容易得多。
第五个优势:已经从芯片扩大到完整系统
今天 d-Matrix 已经拥有:
Corsair
JetStream
Aviator
SquadRack
再加上:
GigaIO 的 Rack-Scale 技术
和:
Wallaroo.ai 的 Orchestration 软件。
这说明公司已经逐渐具备 从 Silicon 到 Data Center 的完整能力。这也是未来真正挑战 Nvidia 必须具备的能力。
d-Matrix 最大的问题:2GB 高速 SRAM 仍然很小
SRAM 非常快,但 面积大、成本高、容量小。
2GB Performance Memory 对传统芯片已经非常巨大。
但面对 70B、100B 甚至 数百 B 参数模型,仍然远远不够。
所以很多权重必须留在 External Capacity Memory。
一旦频繁访问外部内存,DIMC 的优势可能下降。这也是公司为什么必须开发 3DIMC。
第二个问题:600W 也不是低功耗芯片
d-Matrix 经常强调 能源效率。但 Corsair 单卡最高 约 600W。因此它并不是 Hailo 那种几瓦级 NPU。
所谓 Energy Efficient,指的是 完成相同推理工作需要多少电。而不是 单张卡的绝对功耗很低。这两个概念不能混淆。
第三个问题:真实模型性能仍需要更多独立验证
d-Matrix 公布了很多非常漂亮的指标:10 倍交互速度、3 倍成本效率、3 到 5 倍能效。
2026 年 Gimlet Labs 的异构 Pipeline 测试也显示出非常明显的延迟改善。
但是 不同模型、不同 GPU、Batch Size、Context Length、Quantization 以及 Prefill / Decode 分工方式,都会显著改变结果。
因此不能简单得出 Corsair 全面比 Nvidia 快十倍。
更加准确的说法应该是:
在特定 Memory-Bound、低延迟和异构 Decode 工作负载中,d-Matrix 正在展示非常有竞争力的性能。
第四个问题:CUDA 生态仍然非常强大
虽然 d-Matrix 可以与 GPU 一起工作,但软件仍然是长期挑战。
Nvidia 已经拥有:CUDA、cuBLAS、cuDNN、TensorRT、NCCL、Triton 和 海量开发者。
d-Matrix 必须让 Aviator 做到足够简单。
理想状态是:开发者根本不需要知道 DIMC、DMX Link 或者 Chiplet 如何工作。
只需要 把 PyTorch Model 放进去,就能高效运行。
如果这一步不能做到,硬件优势就很难真正转化成市场份额。
第五个问题:3DIMC 的工程难度非常高
3DIMC 是一个非常有潜力的方向。
但 3D Stacking,本身就是非常复杂的半导体技术。
需要解决 热量、良率、TSV、封装、内存可靠性 以及 成本。
因此 Pavehawk 已经工作,是一个重要里程碑。
但 Raptor 能不能真正稳定、大规模、低成本量产,仍然需要继续观察。
d-Matrix 为什么特别值得关注?
如果观察今天 AI 芯片行业,大多数公司都在增加 更多 MAC、更多 Tensor Core、更多 HBM。
d-Matrix 提出的问题更加底层 :如果瓶颈根本就不在计算单元,而在数据搬运怎么办?这其实与整个计算机体系结构历史高度相关。
而大型语言模型正在把这个问题进一步放大。
d-Matrix 的答案就是:不要让数据一直跑到计算核心。
而应该:让计算尽可能靠近数据。
这可能是后 GPU 时代的重要方向之一
未来 AI 数据中心可能不会只有 一种 Accelerator。
Prefill 使用 GPU 或专用 Accelerator。
Decode 使用 Memory-Centric Accelerator。
Networking 使用 DPU / SmartNIC。
这种架构实际上比 “所有任务全部交给 GPU” 更加接近传统数据中心长期的发展方式:不同处理器做不同事情。
d-Matrix 当前正在押注的,就是这种 Heterogeneous AI Computing。
总结
d-Matrix 是目前全球 AI 芯片创业公司中技术路线非常独特的一家。
它并没有把重点放在 制造更大的 GPU。而是选择解决 AI 推理中越来越严重的:Memory Wall。
公司的发展路线可以简单概括成:
2019:d-Matrix 成立
↓
Nighthawk:Digital In-Memory Compute
↓
Jayhawk / Jayhawk II:DIMC + Chiplet
↓
Corsair:商业化 AI Inference Accelerator
↓
JetStream:高速网络
↓
Aviator:AI 软件平台
↓
SquadRack:机架级 AI 推理系统
↓
Pavehawk / Raptor:3DIMC。
Corsair 当前拥有:
8 个 DIMC Chiplet
2GB 高速 Performance Memory
最高 256GB Capacity Memory
150TB/s 内部 Memory Bandwidth
以及:
2400 TFLOPS MXINT8 峰值 Dense Compute。
2026 年 6 月 Corsair 正式进入:Full Production。并开始批量交付客户。
2026 年 7 月:
Parasail 又开始把:
Nvidia Hopper / Blackwell + Corsair 组成真实商业异构 AI 推理平台。
与此同时,d-Matrix 在 2026 年连续收购:
GigaIO Data Center Business
和:
Wallaroo.ai
进一步补齐 Rack-Scale Infrastructure 和 AI Orchestration 能力。
资本方面,公司 2025 年完成:2.75 亿美元 Series C
累计融资达到:4.5 亿美元
当时估值:20 亿美元。
因此今天的 d-Matrix 已经不能简单称为:“一家存内计算芯片公司”。
它正在变成:Memory-Centric AI Inference Infrastructure Company。
未来真正决定 d-Matrix 能不能成功的,也不是 Corsair 某一项 TOPS 数字。
更加重要的是四个问题:
DIMC 的实际 Token 性能优势能不能在更多大模型中持续体现?
GPU + Corsair 的异构推理模式能不能真正成为行业标准?
Aviator 能不能把非 CUDA Accelerator 的软件迁移成本降到足够低?
Pavehawk 和 Raptor 的 3DIMC 能不能真正把 SRAM 的低延迟和 DRAM 的大容量结合起来?
如果这些问题最终得到肯定答案,那么 d-Matrix 可能代表 AI 芯片行业非常重要的一次架构变化:
过去我们不断思考 怎样制造更快的计算核心。
d-Matrix 则提出 :也许真正应该重新设计的,是计算和内存之间的关系。
而随着大型语言模型越来越受到 Memory Bandwidth、KV Cache 和 Decode Latency 限制,这个问题可能会变得越来越重要。