Etched:只为 Transformer 而生的 AI 芯片公司,正从 Sohu 走向整机柜推理系统
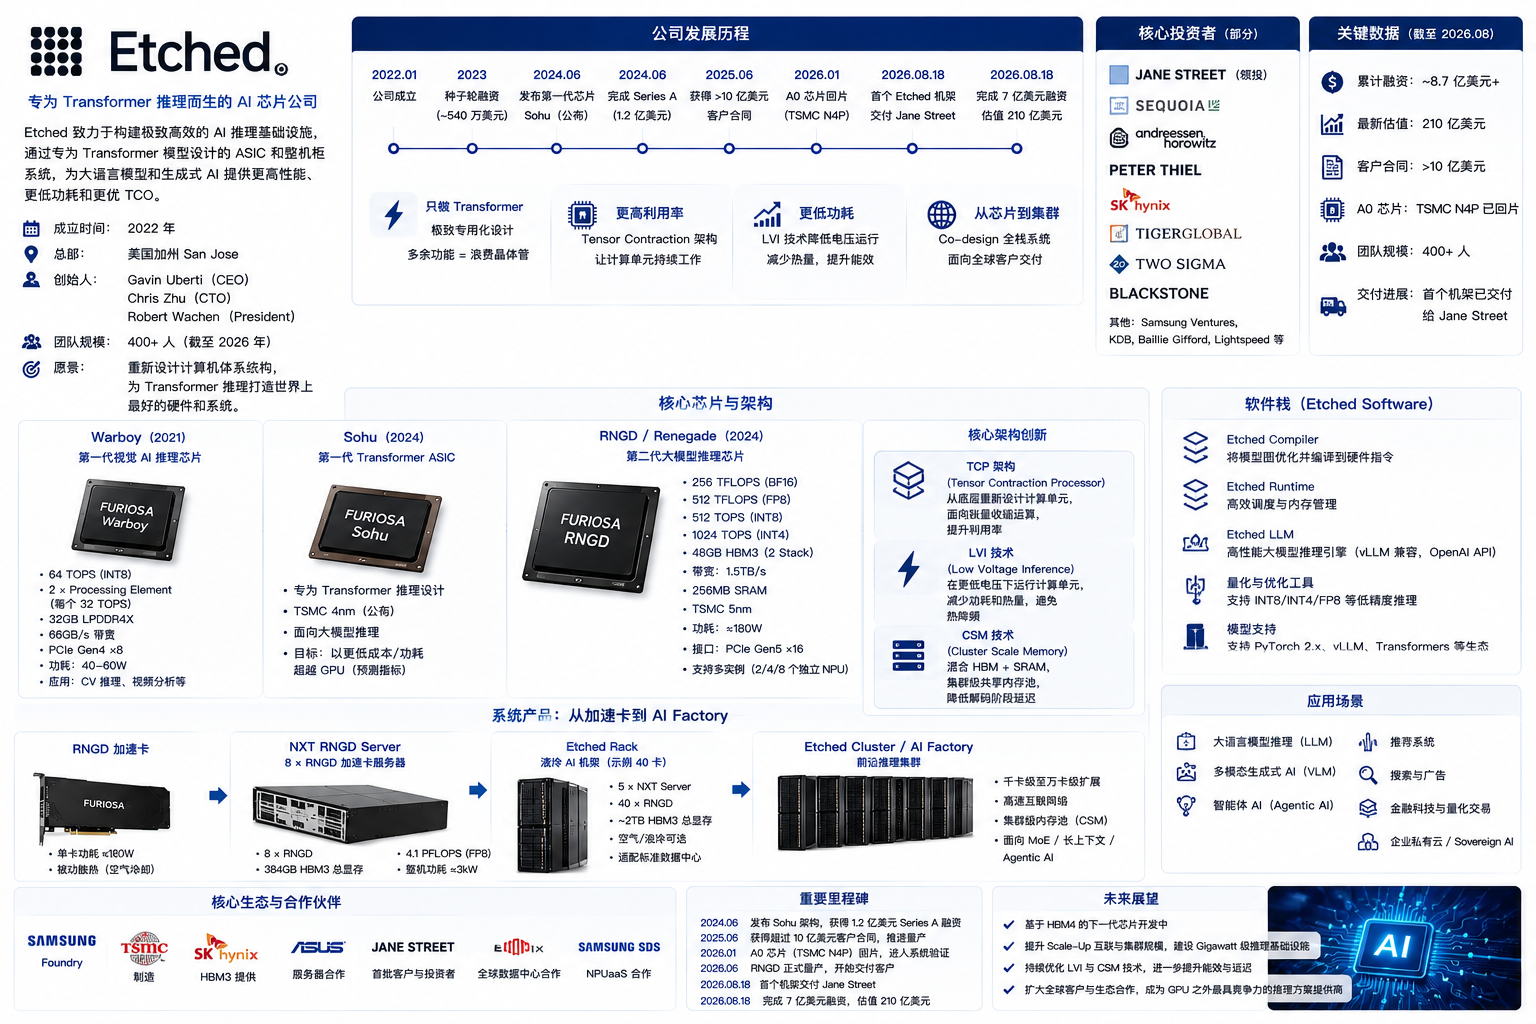
Etched 是美国一家专注于 大型 AI 模型推理芯片和数据中心 AI 基础设施 的半导体创业公司。
在所有挑战 Nvidia 的 AI 芯片公司中,Etched 的技术路线可能是最激进的之一。
很多公司会说 ,我们的芯片既可以运行 Transformer,也可以运行 CNN、推荐模型、科学计算和其他 AI 工作负载。
Etched 的早期思路正好相反, 只做 Transformer。
如果未来最重要的 AI 模型长期建立在 Transformer 及其衍生架构之上,那么为什么还要像 GPU 一样,为大量可能永远不会使用的功能保留晶体管?
Etched 因此提出:把 Transformer 需要的计算直接固化进 ASIC。
2024 年,公司公开第一代产品:Sohu。
到了 2026 年,Etched 的定位已经进一步扩大。
它现在不再只是强调一颗 Sohu 芯片,而是把自己定义为:
Frontier Inference Clusters. 也就是:前沿模型推理集群。
公司开始同时设计:
HBM / SRAM 内存系统
高速互联
PCB
供电
液冷
软件
以及:
完整 AI 机架。
2026 年,Etched 的第一版 A0 芯片已经由 TSMC N4P 工艺制造成功,并开始进入客户验证和实际交付阶段。2026 年 8 月 18 日,公司宣布第一套 Etched AI 机架已经交付给量化交易公司 Jane Street。
Etched 成立于 2022 年
Etched 成立于:2022 年。
总部位于:美国加州 San Jose。
公司由三位年轻的 Harvard 学生共同创立:Gavin Uberti, Chris Zhu 以及 Robert Wachen。
三人后来都离开 Harvard,把主要精力投入 Etched。
其中:
Gavin Uberti 目前担任联合创始人兼 CEO。
Robert Wachen 担任联合创始人兼 President。
Chris Zhu 则继续参与公司的核心技术研发。
Etched 官方资料显示,Gavin Uberti 此前深入参与 AI Compiler 开发,并曾为 Apache TVM 开发 Cortex-M Backend;三位创始人后来也都获得了 Thiel Fellowship。
Etched 最早为什么敢只押注 Transformer?
Etched 创业时做了一个风险极大的判断:
Transformer 不只是暂时流行的一种 AI 模型,而可能长期成为 AI 的核心计算结构。
今天的大语言模型:GPT、Claude、Gemini、Llama、Qwen、DeepSeek ,几乎全部建立在 Transformer 或其重要变体之上。
Transformer 不仅可以处理:文字,还可以处理:图像、视频、语音 以及 多模态模型。
所以 Etched 认为:如果未来 AI 的大部分计算最终都来自 Transformer,那么设计一颗什么都能运行的 GPU,就会产生大量不必要的硬件开销。
CEO Gavin Uberti 2024 年公开表示,公司在 2022 年成立时就是基于这一判断:Transformer 最终会成为主流。
GPU 最大的优势,也是 Etched 眼中的弱点
一张 Nvidia GPU 可以运行:Transformer、CNN、Scientific Computing、Rendering、Simulation、CUDA Program 以及大量其他工作负载。对于用户来说,这是极大的优势。
但是从芯片设计角度来看, 通用性意味着必须保留大量不同硬件资源。
Etched 的思想则是:如果一个数据中心已经确定未来几年就是用来运行 LLM Inference, 那么为什么还要为那些根本不会使用的计算模式付钱?
这就是:ASIC 和 GPU 最根本的区别。
GPU 是:General Purpose Accelerator。
Etched 则押注:Extreme Specialization。
第一代产品 Sohu
2024 年,Etched 正式公开:Sohu。
Sohu 被定位为:Transformer 专用 ASIC。它并不是传统 GPU,也不是一般意义上的通用 NPU。
Sohu 的设计原则非常简单:只要不是 Transformer,就不运行。
这意味着它不需要为了 CNN、LSTM 或其他完全不同的神经网络架构保留大量通用硬件。
Etched 可以把更多晶体管直接用于 Transformer 真正需要的计算和数据移动。
2024 年 Etched 宣布 Sohu 时表示,芯片将采用 TSMC 4nm 制造。
Sohu 当年提出了非常惊人的性能目标
Sohu 在 2024 年受到大量关注,一个重要原因就是:Etched 公布的性能预测非常激进。
公司当时宣称:一台 8 × Sohu Server 在 Llama 70B 推理中可以达到超过 500,000 Tokens/s。
公司甚至表示 一套 Sohu Server 理论上可以替代 160 张 Nvidia H100。
并宣称在特定 Transformer 推理场景下,其性能和成本可能比 Nvidia Blackwell 更有优势。
这里必须特别说明:
这些是 Etched 在 Sohu 尚未大规模量产时公布的公司性能预测和 Benchmark 主张,不能简单理解成经过独立第三方验证的普遍性能结论。
不同模型、Context Length、Batch Size、量化精度 以及软件版本,都可能产生完全不同的结果。
为什么专用 ASIC 理论上可以这么快?
最容易理解的方法,是看看 Bitcoin Mining。
Bitcoin 最早可以使用:CPU。后来使用 GPU。但是最终真正大规模挖矿使用的是:ASIC。
原因并不是 ASIC 比 GPU 更通用。恰恰相反, ASIC 几乎什么都不能做。它只会高速执行 特定算法。
Etched 对 Transformer 的判断与此非常类似。
公司认为:
如果 AI 世界最终长期被 Transformer 主导,
那么 Transformer ASIC 可能重复:
GPU → ASIC
在 Bitcoin Mining 中发生过的产业变化。
但这是一个巨大的技术赌注
Etched 最大的优势,同时也是它最大的风险。
假设未来五年 Transformer 仍然统治 AI, Etched 的超专用架构就可能获得巨大优势。
但是如果未来突然出现一种全新的模型架构, 不再使用 Transformer,那么传统 GPU 只需要 更新软件。
Etched 可能需要 重新设计芯片。这就是 ASIC 的根本风险。
2024 年 Reuters 在报道 Etched 时也特别指出,公司自己承认:把公司未来押在 Transformer 上是一项高风险选择。
2026 年的 Etched 已经发生明显变化
如果只根据 2024 年的 Sohu 新闻理解 Etched,现在已经不够准确。
到了 2026 年,公司官网几乎不再把重点放在 “Sohu 一颗芯片有多快。”
而是强调:Frontier Inference Clusters。
也就是说:Etched 已经从 Transformer ASIC 公司 明显转向 完整 AI 推理系统公司。
公司现在提出 真正决定未来 AI Inference 性能的已经不仅仅是一颗芯片。
而是:芯片、内存、互联、供电、散热、软件 和 整个 Rack ,必须共同设计。
2026 年,A0 芯片终于真正回来
2026 年对 Etched 来说是非常关键的一年。
公司公开表示:
第一版:A0 Silicon. 已经由 TSMC N4P 制造完成并返回公司。
A0 可以理解为:第一版真实量产级芯片 Silicon。
这意味着 Etched 已经从:模拟器、RTL、芯片设计, 真正进入 Physical Silicon。这对任何 AI 芯片创业公司都是最关键的一关。
很多芯片创业公司最后失败,并不是设计理念不好。而是进入真实 Silicon 后可能发现: 频率达不到,功耗太高,内存控制器出现问题,高速接口不稳定,良率太低,封装复杂,驱动程序不成熟。
所以, A0 能不能工作 往往比任何 PowerPoint Benchmark 都更加重要。
Etched 当前已经开始真正交付硬件
2026 年 8 月 18 日 Etched 宣布:
第一套完整机架已经交付给 Jane Street。
Jane Street 不只是投资者, 它还成为 Etched 的 首批实际客户之一。
Jane Street 表示已经对 Etched 芯片进行了测试,并对早期结果表示满意,现在已经把自己的 Etched Rack 部署到数据中心。这件事情的意义非常大。
因为 Etched 终于从 “我们的芯片将会非常快” 跨入 “真实客户已经拿到机器”。
Etched 已经获得超过 10 亿美元客户合同
2026 年 6 月,Etched 表示 已经获得超过 10 亿美元 的客户合同需求。
这些客户包括:AI 公司、Cloud Provider 以及其他大型算力用户。公司随后启动量产,以满足这些订单。
需要注意:合同金额并不等同于已经确认的营业收入。
真正实现收入,还取决于:产品交付、客户验收、量产规模 以及合同执行。
但是对于一家第一代 Silicon 才刚刚回来的芯片创业公司来说, 超过 10 亿美元订单 已经说明市场对替代 Nvidia 推理方案拥有非常强烈需求。
Etched 当前最重要的新技术之一:LVI
2026 年 Etched 公布了一项非常值得注意的新技术:Low Voltage Inference
简称:LVI。
中文可以理解为:低电压推理。
现代 AI GPU 虽然拥有极高峰值 FLOPS,但如果计算单元真正长期保持高利用率,芯片功耗会迅速上升。温度升高以后,芯片又必须 降低频率。
这就是:Thermal Throttling。
结果就是:峰值 FLOPS 很漂亮,但持续运行时未必真正能够长期达到峰值性能。
Etched 希望在更低电压下运行计算单元
Etched 表示:它重新设计了数学计算模块,使部分计算逻辑能够在明显更低的电压下运行。
按照公司的说法,其 Math Blocks 可以运行在多数现代 AI 芯片一半以下的电压范围。
这样能够减少 功耗 和 热量,并允许芯片在更高真实利用率下持续运行。
Etched 宣称,在 Trillion-Parameter Sparse MoE 工作负载中,系统可以达到 80% 以上 Peak FLOPS 利用率 而不发生严重 Thermal Throttling。
同样需要说明 这是 Etched 自己公布的技术指标。未来仍然需要更多客户和第三方测试验证。
为什么降低电压这么有效?
芯片动态功耗大致与 Voltage² 成比例。
简单来说:电压稍微降低,功耗就可能显著下降。
这也是几十年来 CPU 和 GPU 设计一直非常重视 Voltage Scaling 的原因。
但是电压不能无限降低。因为电压过低以后, Transistor Switching 会变慢,甚至产生计算错误。
所以 LVI 真正困难的地方并不是 “把电压调低”, 而是 怎样重新设计计算单元,使它能够稳定在更低电压下工作。
Etched 第二项重要技术:Cluster Scale Memory
2026 年 Etched 另外公布了:
Cluster Scale Memory
简称:CSM。
这是 Etched 当前架构里面可能更加重要的一项技术。
因为大模型推理真正的核心瓶颈之一已经变成 Memory。
尤其是在 Decode 阶段。
生成一个 Token 时,芯片需要不断访问 Model Weights 和 KV Cache。
如果数据不能及时送到计算单元,那么 再多 FLOPS 也没有用。
为什么只靠 HBM 还不够?
HBM 已经是现在最昂贵、最快的数据中心 AI 内存之一。
但是它仍然比 On-Chip SRAM 慢很多。
一种极端方案就是:像某些 AI 芯片一样大量使用 SRAM。优点是 非常快。但问题是 SRAM 面积巨大,价格昂贵,容量小。
如果完全使用 HBM ,容量大,但是访问延迟又高于 SRAM。
Etched 因此选择:HBM + SRAM Hybrid。
Etched 想把整个集群的内存变成一个高速池
Cluster Scale Memory 的核心思想是:在一个 Scale-Up Domain 内,让不同芯片能够通过 Etched 自己的超低延迟、高带宽互联,共享更大的 Memory Pool。
这样就可以同时利用:HBM 的大容量 和 SRAM 的低延迟。
Etched 认为,这种结构特别适合 Decode 以及 需要极低 Token Latency 的 AI Agent 应用。
Prefill 和 Decode 已经成为两个完全不同的问题
大语言模型推理其实可以分成两个主要阶段:Prefill 和 Decode。
Prefill 是:模型读取用户输入,并计算初始状态。
这一阶段特点是:计算量很大。
Decode 则是:一个 Token、一个 Token 不断生成答案。
这一阶段往往更加受:Memory Bandwidth 和 Latency 影响。
所以一个架构如果只追求 最高 FLOPS,不一定同时拥有最低 Decode Latency。
Etched 当前最大的系统设计目标,就是 同时优化 Prefill 和 Decode。
这也是公司为什么从单颗 ASIC 进一步升级成 Rack-Scale Architecture。
Etched 已经开始针对 MoE 设计
未来 AI 模型另外一个越来越重要的方向是:Mixture of Experts
简称:MoE。
例如很多先进大模型并不是每次调用所有参数。
模型可能拥有 1 万亿参数,但一个 Token 实际只激活其中一部分 Expert。这种结构可以减少计算量。但是会增加 Memory 和 Chip-to-Chip Communication 复杂度。
Etched 当前的 Frontier Inference Cluster 已经明确针对 Many-Trillion-Parameter MoE 设计。
这说明 Etched 已经不再只是围绕 2023 年时代的普通 Transformer 优化。
它正在尝试适应 Agentic AI + MoE + Long Context 的新一代推理负载。
Etched 已经从芯片公司变成机架公司
Etched 现在的产品逻辑大致可以理解为:
AI ASIC
↓
Package
↓
Inference Card
↓
Server
↓
Liquid-Cooled Rack
↓
Frontier Inference Cluster。
Nvidia 已经从 GPU 发展到 HGX、DGX、NVL72。
Cerebras 销售 完整 Wafer-Scale System。
SambaNova 有 SambaRack。
Rebellions 有 RebelRack 和 RebelPOD。
Tenstorrent 有 Galaxy。
Etched 最终也发现 只卖一颗芯片已经不够。
为什么 AI 芯片公司最后都必须做系统?
例如:64 张加速卡一起运行模型。如果卡与卡之间通信很慢,所有芯片都会等待。
再比如:每张芯片设计成 1000W,整个 Rack 就可能无法正常供电和散热。
所以未来 AI Infrastructure 必须联合优化:
Compute
Networking
Power
Cooling
以及:
Software。
Etched 把这种方法称作:从 Transistor 到 Token 的 Co-Design。
Etched 已经建立自己的台湾制造设施
2026 年 Etched 又采取了一项对于创业公司非常少见的措施:在台湾建立自己的生产设施。
同时,公司在 San Jose 建立:数据中心、测试设施 以及 NPI Prototyping Lab。
NPI 是 New Product Introduction。也就是 新产品导入。
这些设施让 Etched 可以更加快速地完成:芯片回来、封装、板卡、整机、测试、修改 以及 量产导入。
这意味着 Etched 正在加强 Vertical Integration。
Etched 已经拥有超过 400 名工程师
Etched 早期只是几位 Harvard 学生。但到了 2026 年,公司已经拥有 400 多名工程师。
团队成员来自:Nvidia、Google TPU、Broadcom、SK Hynix、TSMC 等公司。
这也是 Etched 从创业 Demo 转向真正芯片公司的关键变化。
Etched 从 Nvidia 挖来了很多重要人才
Etched 当前管理团队非常值得关注。
例如:
Brian Loiler,担任 VP of Platform。他此前在 Nvidia 工作 22 年,并参与建立 HGX 和 DGX 系统。
这意味着 Etched 现在不仅仅需要会设计 ASIC 的工程师,它需要真正懂 Rack-Scale AI System 的人。
ASIC 团队同样加入了 Nvidia 老将
Etched 的:
Saptadeep Pal,担任 VP of ASIC & Architecture。他此前参与 Nvidia V100, A100 以及 H100 架构团队。
这使 Etched 对 Nvidia AI GPU 本身的设计方法拥有非常深入的行业经验。
软件负责人来自 Google TPU
Etched 软件负责人:
David Munday,此前参与建立 Google TPU v1 到 TPU v5 的软件团队。也曾参与 DeepMind Project Astra 相关工作。
这说明 Etched 已经认识到 :挑战 Nvidia 最大的问题绝对不是 只做出一颗更快的芯片。而是 Software。
Etched 同样需要解决 CUDA 问题
Nvidia 最大的护城河仍然是:CUDA。
大量 AI 软件已经围绕:PyTorch、CUDA、cuDNN、NCCL、TensorRT、Triton 建立。
Etched 如果要求开发者:完全重写模型。商业推广会非常困难。
但是 Transformer-only ASIC 有一个特殊优势:它不需要支持世界上所有 CUDA 程序。
Etched 只需要把:最重要的 Transformer Inference Workload 支持得足够好。这可以显著缩小软件生态建设范围。
但即使如此,Compiler、Kernel、Runtime、Distributed Inference、Monitoring 和 Fleet Management 仍然是巨大工程。
2024 年 Series A 融资 1.2 亿美元
Etched 第一次真正引起全球资本市场关注是 2024 年 6 月。
公司宣布完成 1.2 亿美元 Series A。
投资者包括 Peter Thiel 以及多家风险投资机构。
当时这笔资金主要用于 Sohu 研发 以及 TSMC 生产。
在此之前 ,2023 年 Etched 的 Seed Round 只有大约 540 万美元
当时公司估值约 3400 万美元。
到 2026 年,资本市场对 Etched 的评价完全改变
2026 年 6 月:Etched 表示此前已经通过四轮未公开融资累计获得约 8 亿美元。其中包括 TSMC 体系 VentureTech Alliance 的战略投资。
当时公司披露 已经获得超过 10 亿美元客户合同。
2026 年 7 月估值已经超过 100 亿美元
2026 年 7 月,Etched 又完成约 3 亿美元 融资。
公司估值达到 103 亿美元。
参与者包括 Sequoia、SK Hynix、Andreessen Horowitz、Jane Street 等。
这意味着仅仅两年前,Etched 还是一家需要证明 “Transformer ASIC 能不能做出来” 的小型创业公司。
仅一个月以后,估值又达到 210 亿美元
更加惊人的是 2026 年 8 月 18 日,Etched 宣布又完成 7 亿美元融资。
这轮融资由 Jane Street 领投。
其他参与机构包括:Kleiner Perkins、Sequoia Capital、Andreessen Horowitz、Peter Thiel、Tiger Global、Bain Capital Ventures、Blackstone 等。
公司最新估值达到 210 亿美元。短短一个月左右 Etched 估值再次翻倍。
为什么 Jane Street 特别值得注意?
Jane Street 是全球著名量化交易公司。
它同时具有两个身份 投资者 以及 客户。
Jane Street 在实际测试 Etched 硬件以后,领投了最新一轮融资。同时成为首批部署 Etched Rack 的客户。这比普通 VC 投资更有意义。
因为 Jane Street 自己需要 极低延迟、高吞吐计算 以及大量 AI 工作负载。
它属于 实际用机器的人。
Etched 的投资者阵容已经非常强
截至 2026 年,Etched 的机构投资者和战略支持者已经包括:
Sequoia Capital
Andreessen Horowitz
SK Hynix
VentureTech Alliance
Jane Street
Two Sigma
Blackstone
Tiger Global
Peter Thiel 等。
个人投资者和顾问阵容同样非常特别,包括:
Geoffrey Hinton
Andrej Karpathy
Fei-Fei Li
Aidan Gomez
Arthur Mensch 等 AI 领域重要人物。
当然 投资者阵容强大并不等于芯片最终一定成功。
半导体历史上有很多获得巨额投资、技术也很先进,但最终没有形成大市场的公司。
Etched 与 Nvidia 最大的区别
如果简单概括:
Nvidia 的路线是:
GPU + CUDA + HBM + NVLink + NVSwitch + Networking + Rack。
Etched 的路线则更加接近:
Transformer ASIC + HBM/SRAM Hybrid + Proprietary Interconnect + Low Voltage Compute + Rack-Scale Co-Design。
Nvidia 最大优势是:
Flexibility。
Etched 最大优势则希望来自:
Specialization。
两者实际上代表了处理器设计中一个持续几十年的经典矛盾:
General Purpose vs Application Specific。
Etched 与 Groq 有什么不同?
Groq 的 LPU,非常强调 确定性执行、低延迟 和 高速 Token Generation。
Groq 的核心思想是 尽量让 Compiler 在执行之前就确定 数据什么时候移动、指令什么时候执行。
Etched 则更加激进地把 Transformer 本身 作为 ASIC 设计边界。
同时 2026 年的 Etched 更加强调:
HBM/SRAM Hybrid + Rack Scale Memory。
因此两家公司虽然都攻击 Inference,但技术哲学不同。
Etched 与 Cerebras 完全不同
Cerebras 的路线是:把一整块晶圆做成一颗巨大处理器。也就是:Wafer Scale Engine。
Etched 则仍然采用传统先进制程芯片,并通过 高速互联、内存池 和 Rack 扩大规模。
简单来说,
Cerebras 强调 One Giant Chip。
Etched 强调 Highly Specialized Cluster。
Etched 与 FuriosaAI 也不同
FuriosaAI RNGD 使用 Tensor Contraction Processor。希望通过更加通用的 Tensor 数据流提高 AI 推理效率。
它仍然希望支持 LLM、VLM、Vision 等多种神经网络。
Etched 则把赌注下得更重:Transformer family。
因此理论上,Etched 的专用程度更高。但架构风险也更大。
Etched 最大的优势:敢于放弃通用性
在半导体行业,放弃功能本身也是一种优化。
如果确认一个功能永远不会使用,就可以 删除相关电路。
删除以后 ,芯片面积下降,功耗下降,控制逻辑减少,软件复杂度降低,更多晶体管可以留给真正重要的计算单元。
Etched 的整个公司实际上就是建立在“我们愿意放弃什么?” 这个问题上。而不是 “我们还能增加什么功能?”
第二个优势:Inference 市场可能比 Training 更大
Etched 并没有重点挑战 AI Training。它更加集中于 Inference。这是一个非常有战略意义的选择。
一个模型可能只训练几个月。但是一旦上线,可能连续运行几年。
例如未来有 10 亿 AI 用户,每天每个人与 AI Agent 进行几十次交互。产生的 Token 数量会极其巨大。
所以从长期成本来看,Inference Compute 完全可能成为比 Training 更大的市场。
AI Agent 对 Etched 尤其有利
AI Agent 和普通 Chatbot 有明显区别。
Chatbot 可能 用户问一次,模型回答一次。
Agent 为了解决一个任务,可能需要 推理、搜索、调用工具、再次推理、检查结果、调用另一个模型,然后重新规划。
一个用户请求背后可能产生 几十次甚至几百次模型调用。
这意味着 Token Demand 可能呈现巨大增长。
如果未来真正进入 Agentic AI 时代,推理成本将成为企业极大的支出。
这正是 Etched 希望解决的问题。
第三个优势:已经开始真正做 Silicon + System Co-Design
Etched 2026 年最值得注意的地方,并不是融资估值。而是 公司已经建立了完整系统团队。
从 晶体管、Math Array、HBM、SRAM、Interconnect、PCB、VRM、Cold Plate 一直做到 Rack。
这种 Full-System Co-Design 正越来越成为高端 AI 芯片公司的基本要求。
第四个优势:团队质量明显提升
Etched 已经从几位年轻创始人,发展到 超过 400 名工程师。
而且包括:
Nvidia HGX / DGX、
Google TPU、
以及 消费电子量产 等多个领域的资深工程师。
对于一家准备进行大规模芯片量产的企业,这些工程经验往往比某一个架构概念更加重要。
Etched 最大的风险:Transformer 会不会永远存在?
这仍然是最根本的问题。
Etched 的早期逻辑是 Transformer Wins。但是 AI 发展非常快。
已经有人研究 SSM、Mamba、Diffusion Language Model 以及 各种 Transformer Replacement。
未来也可能出现 完全不同的模型架构。
如果这些架构真正取代 Transformer,GPU 可能只需要更新 软件。
Etched 则可能需要 重新 Tape-Out。这就是极端专用 ASIC 必须承担的风险。
但 Transformer 本身也在不断变化
即使 Transformer 不消失,今天的 Transformer 和 2022 年的 Transformer 已经不完全一样。
越来越多模型使用 MoE、GQA、MLA、Long Context、Speculative Decoding 以及 各种新的 Attention 机制。
所以 Etched 不能真的把 “某一个固定版本 Transformer” 写死在芯片里。
它仍然需要 足够的 Programmability 来支持 模型快速变化。这也是 Etched 下一阶段技术能否成功的关键。
第二个风险:从一套 Rack 到十万套 Rack 完全不同
2026 年 8 月,第一套 Rack 已经交付。这是重大进展。
但是 制造一套机器 和 制造十万套机器 完全不是一个问题。
大规模量产需要 晶圆产能、先进封装、HBM、PCB、电源、冷却、机柜、物流 以及 全球售后系统。
Etched 当前提出的目标甚至是 Gigawatt Scale。这将是一项巨大制造挑战。
第三个风险:HBM 供应
Etched 现在使用 HBM + SRAM 混合架构。
而全球 HBM 供应高度集中于 SK Hynix、Samsung 和 Micron。其中 SK Hynix 已经成为 Etched 投资者之一。这有利于供应链合作。
但未来如果 Etched 真正扩大到 Gigawatt Scale,HBM 供应仍然可能成为限制因素。
第四个风险:Nvidia 不会停下来
Etched 当前针对的不是 2024 年的 H100。
真正需要面对的是 未来的 Nvidia。
Nvidia 同样在不断提高 Transformer Engine、FP4 / FP8、HBM、NVLink、KV Cache 管理、Speculative Decoding 以及 Inference Software。
Nvidia 甚至可以自己越来越多地硬化 Transformer 运算。
因此 Etched 的优势必须足够大,才能抵消 CUDA 生态 和 Nvidia 平台规模 带来的巨大优势。
第五个风险:目前很多性能数据仍需要独立验证
Etched 2024 年提出过极其惊人的 Sohu Benchmark。
2026 年公司又表示, 早期客户测试已经获得领先的 Throughput、Latency 和 Power Efficiency。
但是目前公开的独立第三方 标准化 Benchmark 仍然相对有限。
Jane Street 已经实际测试和部署,是一个非常积极的信号。
但未来市场仍然需要看到更多 AI 公司、Cloud Provider 以及 MLPerf 类公开结果。
为什么 Etched 特别值得关注?
Etched 与很多 Nvidia Challenger 最大的区别不是 它说自己的芯片更快。几乎所有 AI 芯片创业公司都会这么说。
Etched 真正特别的地方是:它愿意放弃 GPU 最重要的优势——通用性。
它实际上在做一个极端选择:如果未来 AI 最重要的工作就是 Transformer 推理,那么就为这一件事情制造一台最极端的机器。
这种思路很可能 非常成功,或者 非常失败。中间状态反而比较少。
从 Sohu 到 Frontier Inference Cluster
因此现在理解 Etched,已经不能简单写成 “Sohu AI 芯片公司。”
更加准确的描述应该是:Etched 是一家专门为 Frontier Model Inference 重新设计整台计算机的公司。
它现在设计的已经不是单独 ASIC。
而是:
Compute
HBM / SRAM
Interconnect
Power
Cooling
Software
Rack。
2024 年的核心故事是:Transformer-only ASIC。
2026 年的核心故事则已经变成:Transformer / MoE-optimized AI Factory。
总结
Etched 是目前全球 AI 芯片创业公司中最激进、也最值得观察的一家公司之一。
公司成立于:2022 年。最初由 Gavin Uberti、Chris Zhu 和 Robert Wachen 三位 Harvard 学生共同创立。
2024 年 Etched 公开第一代 Sohu Transformer ASIC,并获得 1.2 亿美元 Series A。
它提出一个极端技术路线:不做通用 GPU,只运行 Transformer。
到了 2026 年,公司的技术路线已经明显升级。
Etched 的 A0 芯片已经通过 TSMC N4P 制造完成。
公司推出 Low Voltage Inference 以及 Cluster Scale Memory。
并开始把 ASIC、HBM、SRAM、高速互联、电源、液冷 和 软件 整合成 Frontier Inference Cluster。
公司披露已经获得超过 10 亿美元客户合同。
2026 年 8 月 18 日,第一套 Etched Rack 正式交付:Jane Street。
同一天, Etched 宣布完成 7 亿美元融资。公司最新估值达到 210 亿美元。
这意味着 Etched 已经从 2023 年估值只有约 3400 万美元 的小型芯片创业公司,在三年左右时间里迅速成长为 210 亿美元估值的 AI 基础设施企业。
但是 估值不等于成功。
Etched 真正需要证明的仍然是四件事情:
第一,Transformer 及其衍生架构能不能继续长期统治 AI?
第二,Etched 的真实性能优势能不能通过更多独立客户验证?
第三,公司能不能把一套能够工作的 Rack 扩大到数万甚至数十万套量产?
第四,它的软件和系统生态能不能让客户真正愿意离开 Nvidia?
如果这几个问题最终都得到肯定答案,那么 Etched 可能代表 AI 芯片行业一次非常重要的变化:
未来最大的推理数据中心,也许会越来越多地采用:为某一种主流 AI 架构专门制造的 ASIC。
这与 Bitcoin Mining 曾经从:CPU → GPU → ASIC 发生的变化非常相似。
而 Etched 正在押注 Transformer 也会经历同样的历史。