Rebellions:韩国崛起最快的 AI 推理芯片与 NPU 基础设施企业
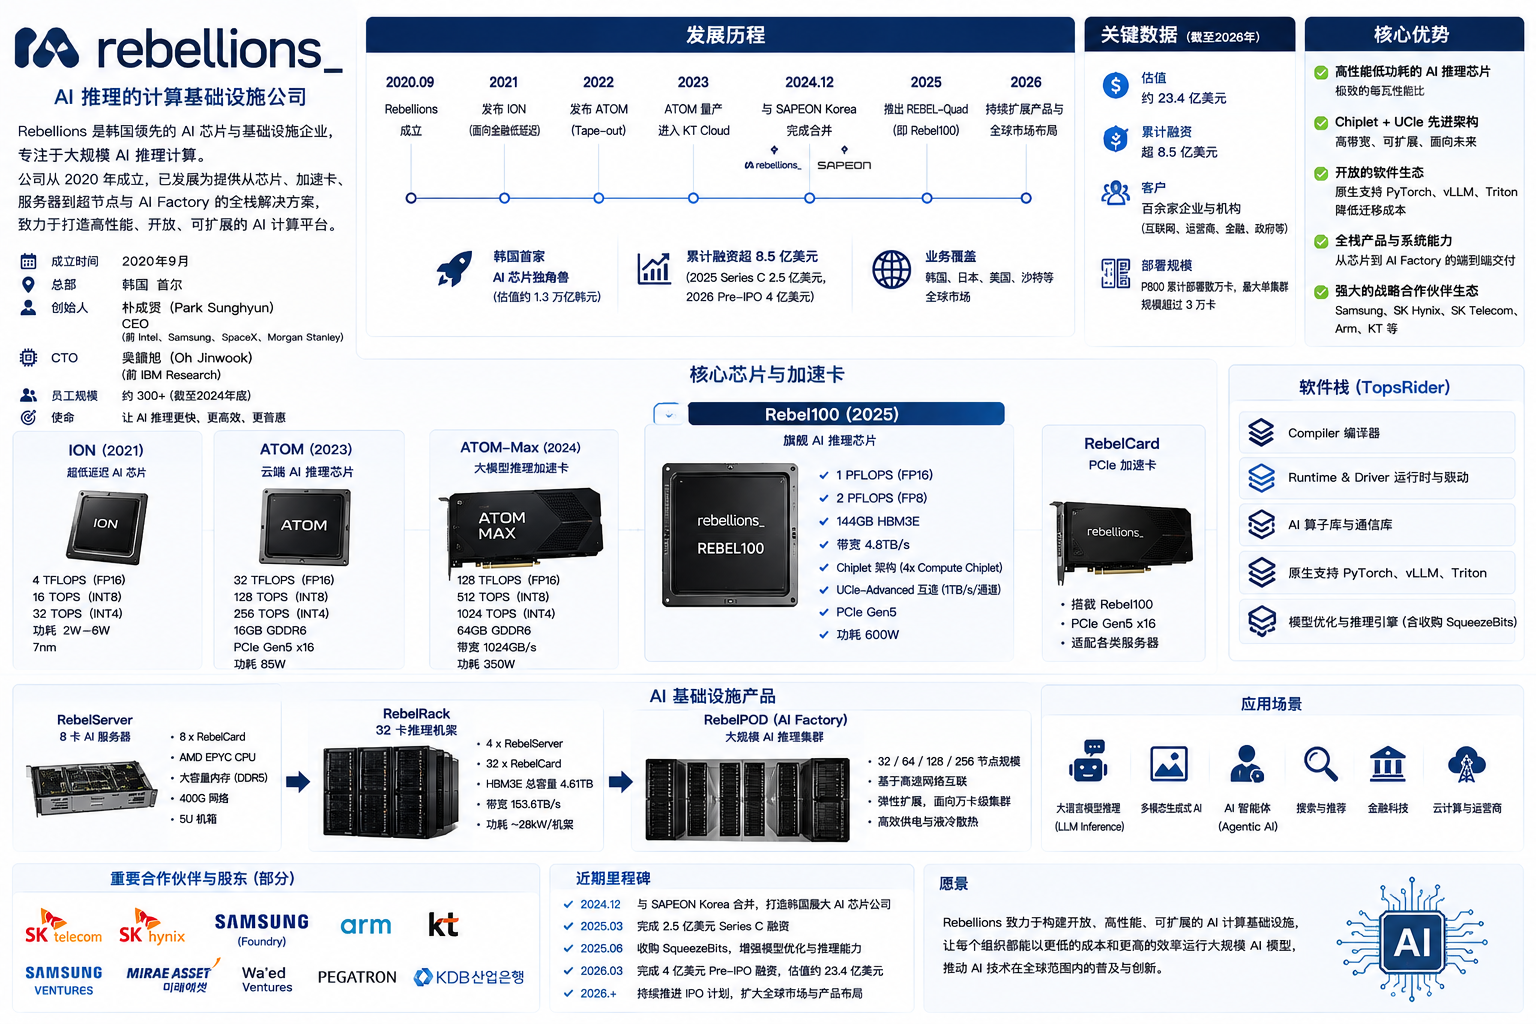
Rebellions Inc. 是韩国一家专注于 AI 推理芯片、NPU、Chiplet、大语言模型推理服务器和 AI 数据中心基础设施 的半导体企业。
公司成立于 2020 年。但 Rebellions 的发展速度非常快。
从第一颗面向金融市场的 ION,到数据中心 AI 推理芯片 ATOM,再到 ATOM-Max,以及今天的旗舰产品 Rebel100。
Rebellions 已经从一家设计 NPU 的创业公司逐渐扩展成为一家提供:
AI 芯片 + AI 加速卡 + 服务器 + 机架 + AI Factory + 软件栈 的完整 AI 基础设施企业。
更加重要的是 2024 年 12 月,Rebellions 与 SK Telecom 旗下 AI 芯片公司 SAPEON Korea 完成合并。
合并后的新公司继续使用 Rebellions 这一名称,并由原 Rebellions 创始人 Park Sunghyun 继续担任 CEO。
这次合并使 Rebellions 一跃成为韩国规模最大的独立 AI 芯片创业公司,并成为韩国首家 AI 半导体独角兽。
Rebellions 成立于 2020 年
Rebellions 成立于 2020 年 9 月。公司总部位于韩国,并在美国硅谷设有 Rebellions America,同时已经进入日本和沙特阿拉伯市场。
公司从创立开始就没有选择制造传统 GPU。
它的重点非常明确:AI Inference。也就是:人工智能推理。
这与 Nvidia 的发展路线有明显区别。
Nvidia GPU 同时承担:AI 训练、AI 推理、HPC、图形渲染 以及大量通用 GPU 计算。
Rebellions 则希望针对 大规模 AI 推理 ,重新设计处理器,从而提高 性能、芯片利用率、能效 以及 每美元能够产生的 Token 数量。
创始人 Park Sunghyun 拥有非常特殊的职业经历
Rebellions 联合创始人兼 CEO 是:Park Sunghyun(박성현)。中文资料有时译作:朴成贤。他的职业经历非常有意思。
Park 本科毕业于 KAIST,韩国科学技术院。之后进入美国 MIT 学习电子工程与计算机科学,并获得博士学位。
他的职业经历包括:Intel,Samsung Research America,SpaceX 以及 Morgan Stanley。
在 SpaceX,他从事 ASIC 芯片设计。
后来在 Morgan Stanley 工作期间,则参与金融市场超低延迟计算系统。
也正是在金融行业工作期间,他开始更加认真地考虑:
如果针对某一种计算任务直接设计专用芯片,能不能比传统 CPU 和 GPU 更快?
2020 年,他返回韩国,与团队共同创立 Rebellions。
CTO Jinwook Oh 同样拥有芯片架构背景
Rebellions 另一位重要联合创始人是:Jinwook Oh。他目前担任公司 CTO。
Jinwook Oh 曾在 IBM Research 从事处理器和芯片设计工作。
因此 Rebellions 创始团队从成立开始,就不是单纯由 AI 软件工程师组成。
它更加接近一个:Computer Architecture + ASIC + AI Software 团队。这对于开发自己的 NPU 非常重要。
因为真正的 AI 芯片必须同时解决:指令集、计算单元、内存系统、数据流、芯片互联、编译器 以及 Runtime。
第一颗芯片:ION
Rebellions 第一颗芯片叫做:ION,于 2021 年 推出。它最初并不是用来运行 ChatGPT。
ION 针对的是一个非常特殊的市场:金融高频交易。
金融高频交易最重要的要求之一不是 总计算量最大。而是 Latency,也就是延迟必须极低。有时候几十微秒甚至几微秒的差距,都可能决定交易是否成功。
这与 Park Sunghyun 在 Morgan Stanley 的工作经历有直接关系。
ION 是一颗非常小而高效的 NPU
ION 使用 TSMC 7nm 工艺。
官方资料显示,它可以提供:4 TFLOPS FP16,16 TOPS INT8 以及 32 TOPS INT4。
最大功耗只有 2W—6W。
它支持 CNN、LSTM、BERT 等不同类型的 AI 模型。相比今天几百瓦甚至上千瓦的数据中心 AI 芯片,这个数字非常小。
但是 ION 的目标从来就不是大型语言模型。
它首先证明了一件事情:Rebellions 能够真正设计、流片并运行自己的 AI Processor。
ION 的核心理念后来一直延续下来
ION 已经体现出 Rebellions 后来非常重要的设计哲学:High Utilization。也就是 尽量提高实际运行时计算单元利用率。
很多处理器拥有很高的 Peak FLOPS。但是峰值性能并不等于实际性能。
如果大量计算单元因为 等待内存、等待数据、等待同步 而处于空闲状态,那么 理论算力再高也没有意义。
Rebellions 因此从一开始就非常强调:真正被利用的计算能力。这也是后来 ATOM 和 Rebel100 的核心设计思想之一。
第二代产品:ATOM
真正让 Rebellions 进入 AI 数据中心市场的产品是:ATOM。
ATOM 于 2022 年完成 Tape-Out。并于 2023 年开始进入实际数据中心。
韩国大型电信运营商 KT 成为 Rebellions 最重要的早期战略合作伙伴之一。
2023 年,ATOM 开始进入 KT Cloud 数据中心。这也是韩国较早真正商业部署 NPU 云计算基础设施的案例之一。
ATOM 使用 Samsung 5nm 制程
ATOM 使用 Samsung 5nm EUV 制造。
官方目前公布的 ATOM 主要规格包括:
32 TFLOPS FP16
128 TOPS INT8
256 TOPS INT4
显存 16GB GDDR6
显存带宽 256GB/s
主机接口 PCIe Gen5 ×16
最大功耗 85W。
这组数据体现出 Rebellions 一个非常明显的目标:Performance per Watt。
它并不试图直接制造一颗功耗 700W 或 1000W 的超级 GPU。它首先希望在较低功耗环境下完成 AI 推理。
ATOM 为什么特别适合数据中心推理?
ATOM 一个很有意思的功能是:Multi-Instance NPU。一颗 ATOM 可以被分成多个相互隔离的任务环境。
早期官方资料显示,它最多可以支持 16 个独立任务。这对于云服务商非常有价值。
因为数据中心并不总是在运行 一个巨大模型。很多时候同时有大量客户运行 图像识别、文本分类、Embedding、语音模型、小型语言模型。
如果一颗芯片可以同时安全运行多个独立任务,那么硬件利用率就会提高。
ATOM 已经从韩国走向海外
截至 2025 年以后,Rebellions 表示 ATOM 系列已经在 韩国,日本,沙特阿拉伯以及 美国 实现客户部署。
这意味着 Rebellions 已经不再只是 “韩国国产 AI 芯片”。它开始真正尝试进入 全球 AI 数据中心市场。
ATOM-Max:把 ATOM 扩展到更大规模推理
随着大型语言模型越来越普及,16GB 显存的普通 ATOM 开始遇到明显限制。
于是 Rebellions 推出了 ATOM-Max。
ATOM-Max 的计算能力大幅提高到:
128 TFLOPS FP16
512 TOPS INT8
以及 1024 TOPS INT4。
显存则提高到 64GB GDDR6
显存带宽 1024GB/s
最大功耗 350W。
这已经明显从 传统 Computer Vision NPU, 进入 大模型推理加速器。
SK Telecom 已经测试 ATOM 和 ATOM-Max
2025 年,SK Telecom 开始测试 Rebellions ATOM NPU。
测试场景包括:AI 电话摘要、垃圾信息过滤、金融助手 以及其他 AI 服务。
SK Telecom 当时表示,希望根据测试结果进一步把 ATOM-Max 用于更大规模商业 AI 服务。这对于 Rebellions 非常重要。
因为 AI 芯片真正困难的地方不是 跑一个 Demo。而是 连续为真实用户提供 AI 服务。
2024 年发生了一件决定 Rebellions 命运的大事
2024 年,韩国 AI 芯片产业发生了一次重要整合。Rebellions 与 SAPEON Korea 决定合并。
SAPEON 原本是 SK Telecom 体系中的 AI 半导体公司。其技术历史可以追溯到 SK Telecom 内部的 AI 芯片研发项目。
SAPEON 曾经推出 X220 以及 X330 等数据中心 AI 加速器。
为什么 Rebellions 和 SAPEON 要合并?
今天一家 AI 芯片公司需要同时投入:先进制程、HBM、Chiplet、先进封装、编译器、AI Framework、服务器、网络 和 数据中心部署。
如果韩国同时维持多个规模不大的 AI 芯片创业公司,就很难与 Nvidia、AMD 以及全球大型云计算公司竞争。
所以 SK Telecom 和 Rebellions 决定 把资源集中起来。
2024 年 12 月完成正式合并
2024 年 12 月 1 日 Rebellions 和 SAPEON 正式完成合并。合并后的公司继续使用 Rebellions 名称。
Park Sunghyun 继续担任 CEO。
合并时新公司的企业价值约 1.3 万亿韩元。这使它成为 韩国第一家 AI 芯片独角兽。
SK Telecom、SK Hynix 和 SK Square 成为重要战略力量
合并以后,原 SAPEON 背后的 SK Telecom,SK Hynix 以及 SK Square 都成为新 Rebellions 的重要战略投资者。这对 Rebellions 的意义非常大。
因为 SK 集团不仅有资本,SK Hynix 更是全球最重要的 HBM 制造企业之一。
而现在大模型 AI 芯片最关键的零部件之一恰恰就是 HBM。
所以 Rebellions 形成了一套非常有意思的韩国半导体产业链:
Rebellions:AI Processor
Samsung:Foundry + Advanced Packaging
SK Hynix:HBM
SK Telecom:AI Data Center + AI Service
这也是它与很多普通创业公司最大的区别之一。
REBEL:真正针对大型语言模型重新设计
在 ATOM 开始商业化以后,Rebellions 马上启动下一代芯片 REBEL。
2024 年 11 月 REBEL SoC 完成 Tape-Out。
它与 ATOM 最大的区别是:
REBEL 从设计之初就是为了 LLM,Multimodal AI 以及 大规模数据中心推理 而开发。
后来这一产品逐渐演变成为今天的 Rebel100。
Rebel100 是 Rebellions 当前最重要的芯片
截至 2026 年,Rebellions 当前旗舰 AI 加速器是 Rebel100。
早期公开名称包括 REBEL,REBEL-Q 以及 REBEL-Quad。
目前商业产品统一使用 Rebel100。
它是 Rebellions 从普通 NPU 公司走向大型 AI 基础设施公司的关键产品。
Rebel100 最大特点:Chiplet
Rebel100 没有把所有计算单元放在一颗巨大单片 Die 上。
它采用 4 个相同 Compute Chiplet 组成一颗完整 SoC。
这四颗 Chiplet 使用 UCIe-Advanced 进行高速互联。这是一项非常重要的技术选择。
为什么 AI 芯片越来越喜欢 Chiplet?
随着芯片越来越大,一颗巨大 Monolithic Die 会遇到几个问题。
首先:良率下降。芯片面积越大,晶圆上出现缺陷影响整颗芯片的概率越高。
其次:设计越来越困难。
第三:制造成本越来越高。
Chiplet 的思路就是 把一个巨大芯片拆成几个较小芯片。然后使用高速接口重新组合起来。
理论上,这样可以提高 设计灵活性、制造良率 以及 产品扩展能力。
AMD EPYC 已经证明 Chiplet 可以非常成功。
现在 Chiplet 正在快速进入 AI Accelerator。
Rebel100 使用 UCIe-Advanced
Rebellions 最大胆的一项设计之一,就是采用 UCIe-Advanced。
UCIe 全称:Universal Chiplet Interconnect Express。它试图成为 Chiplet 时代类似 PCIe 的标准接口。
Rebel100 的四颗 Chiplet 通过 UCIe-Advanced 连接。
官方公布的 Chiplet 接口带宽达到 每通道约 1TB/s。
Rebellions 希望让四颗 Chiplet 从软件角度看起来 像一颗完整芯片。这非常重要。
因为如果软件需要自己管理 Chiplet 0、Chiplet 1、Chiplet 2、Chiplet 3,编程会非常复杂。
更理想的方式是 硬件负责 Chiplet,软件看到一颗 Accelerator。
Rebel100 使用 Samsung 4nm
Rebel100 采用 Samsung 4nm 制造。
它拥有 4 个 Compute Chiplet。 并配备 144GB HBM3E。
显存带宽达到 4.8TB/s。这是从 ATOM 到 Rebel100 一个非常巨大的变化。
ATOM 使用 GDDR6。
Rebel100 已经进入 HBM3E。
为什么 HBM 对大模型这么重要?
LLM 推理经常不是 计算单元不够快。真正的问题是 模型权重送不到计算单元。
假设模型拥有几十亿甚至几百亿参数。每生成一个 Token,都可能需要读取大量 Weight 以及 KV Cache。
如果显存带宽不够,那么大量矩阵计算单元就只能 等待数据。
所以现代 AI GPU 的核心竞争越来越变成 Compute + HBM + Interconnect。
Rebel100 的 144GB HBM3E + 4.8TB/s 就是专门针对这一问题设计。
Rebel100 的算力
Rebellions 官方目前公布的 Rebel100 峰值计算能力达到 1,024 TFLOPS FP16。也就是大约 1 PFLOPS FP16。
FP8 达到 2,048 TFLOPS。也就是 约 2 PFLOPS FP8。
当前 Rebel100 加速卡最大功耗约 600W。
这意味着 Rebellions 已经彻底离开最早几瓦功耗的 ION 市场。
它开始直接进入 高端数据中心 AI Accelerator。
Rebel100 为什么特别强调 Mixed Precision?
大模型并不要求所有计算都使用 FP32。
现在越来越多模型使用 BF16、FP16、FP8,甚至更低精度。
原因是 精度降低以后,可以减少 存储空间、显存带宽 和 计算成本。
Rebel100 因此设计了:Unified Mixed-Precision Compute Engine。
FP16 和 FP8 可以在统一流水线中执行。
Rebellions 表示,这种设计能够提高核心利用率,避免不同精度单元长期闲置。
Predictive DMA:提前把 KV Cache 搬过来
Rebel100 另外一个很有意思的技术是 Predictive DMA。
大型语言模型 Decode 阶段会不断访问 KV Cache。
如果计算核心每一次都等 KV Cache 从 HBM 读取以后才开始计算,就会产生大量空闲时间。
Rebellions 的思路是 预测下一步需要什么数据,并提前移动数据。
这种设计的本质仍然是解决 AI 芯片最核心的问题之一:Moving Data。
不是让计算核心更快地等待数据,而是 尽量不让它等待。
RebelCard:把 Rebel100 做成标准 AI 加速卡
Rebel100 本身是一颗 AI Processor。
真正安装在服务器里面的产品叫 RebelCard。它通过 PCIe Gen5 连接服务器。这样服务器厂商可以像安装 GPU Accelerator 一样安装 Rebellions NPU。
Rebellions 2026 年还与 Arm 和 SK Telecom 合作,把 Arm 新一代数据中心 CPU 与 RebelCard 组成完整 AI 推理服务器。
Rebellions 开始和 Arm 深度合作
2025 年以后,Arm 成为 Rebellions 一个越来越重要的合作伙伴和投资者。
2026 年,SK Telecom、Arm 和 Rebellions 宣布联合开发下一代 AI Server。
系统采用:
Rebellions NPU。
这种体系结构非常有意思。
NPU 专门负责 AI Inference。
这可能成为未来 Nvidia GPU Server 之外的另一种数据中心架构。
RebelServer:Rebellions 已经开始卖整台 AI 服务器
Rebellions 已经不满足于只出售 Chip 或者 PCIe Card。
公司目前已经推出 RebelServer。
一台 RebelServer 采用 5U 机箱,并集成 8 张 RebelCard。
服务器使用 AMD EPYC CPU,同时配备 大容量 DDR5 内存 和 400G 高速网络。
这说明 Rebellions 的商业模式已经发生明显变化。从 卖 NPU 变成 卖 AI Computer。
RebelRack:32 张 RebelCard 组成一个机架
再往上就是 RebelRack。
RebelRack 是完整的:Rack-Scale AI Inference Infrastructure。
一套 NPU Rack 包括 4 台 RebelServer。 总计 32 张 RebelCard。
官方配置拥有:4.61TB HBM3E
总显存带宽:153.6TB/s
FP8 峰值算力:约 65.5 PFLOPS
机架最大功耗:约 28kW。
这已经不是传统意义上的服务器。它更接近 AI Computing Rack。
RebelPOD:直接进入 AI Factory
RebelRack 之上,Rebellions 又推出:RebelPOD。
RebelPOD 是把多个 RebelRack 组合起来的 AI Factory。
官方提供 32 节点,64 节点,128 节点 以及 256 节点 等不同配置。
以最小的 32 节点版本为例:
系统包含:256 张 RebelCard
HBM3E 总容量约:36.86TB
FP8 峰值算力达到:约 524.3 PFLOPS。
这说明 Rebellions 已经开始直接挑战 大型 AI 数据中心基础设施市场。
为什么所有 AI 芯片公司最后都开始卖服务器?
这是 AI 行业一个非常明显的趋势。
以前半导体公司的商业模式通常是 我卖芯片,你自己设计服务器。但是 AI 时代情况发生了变化。
因为几十张甚至几百张 AI Accelerator 一起运行以后,需要同时解决:网络、散热、电源、机柜、Runtime、集体通信、模型切分 以及 分布式推理。
客户真正想购买的越来越不是 一颗芯片。而是 插上以后就能跑模型的 AI Factory。
所以 Nvidia 有 DGX、HGX、NVL72。
Cerebras 有完整 Wafer-Scale System。
SambaNova 有 SambaRack。
Tenstorrent 有 Galaxy。
Rebellions 现在也有 RebelServer + RebelRack + RebelPOD。
Rebellions 软件栈同样非常重要
如果只有 Rebel100,没有软件生态,Rebellions 很难进入真正的数据中心。因此公司已经建立自己的完整软件栈。
包括:Compiler,Runtime,Driver,Firmware 以及 模型执行和推理软件。
但是更加重要的是 Rebellions 并不希望建立一个完全封闭的新生态。
Rebellions 正在尽量靠近 PyTorch 和 vLLM
Rebel100 当前已经强调原生支持 PyTorch 2.x,vLLM 以及 Triton。这是一个非常关键的战略。
因为 Nvidia 最大的优势就是 开发者已经习惯 PyTorch + CUDA。
如果使用 Rebellions 意味着 整个模型全部重写,那么几乎没有企业愿意迁移。
更加现实的方法就是 尽可能保持上层 AI 软件不变,只替换底层 Accelerator。
Rebellions 不希望重新创造一个 CUDA
这一点非常值得注意。
很多 AI 芯片创业公司早期都想 “我要建立自己的 CUDA。” 但是二十多年 CUDA 生态几乎不可能在几年内复制。
Rebellions 现在更加倾向于:Open Source + Open Standards。
也就是尽量依靠 PyTorch、vLLM、Triton、Red Hat OpenShift 以及行业标准接口。
这种路线的目标不是让开发者 学习 Rebellions 编程。而是 让原来的 AI 软件尽量直接跑在 Rebellions 上。
2025 年与 Red Hat 建立合作
2025 年,Rebellions 与 Red Hat 合作。
双方把 Rebellions NPU 与 Red Hat OpenShift AI 结合。这对于进入 企业 AI 以及 私有云 AI 非常重要。
很多银行、政府和大型企业并不会直接运行裸机 AI Server。
它们需要:Kubernetes、Container、Security、Monitoring 以及 Enterprise Support。
如果 Rebellions 想进入真正的企业数据中心,这种软件生态必须完善。
2026 年又收购了 SqueezeBits
2026 年 6 月 Rebellions 宣布收购韩国 AI 推理优化公司:SqueezeBits。
SqueezeBits 专门研究 模型优化、量化 以及 AI Inference Serving。
收购完成以后,Rebellions 将 芯片、服务器、模型优化、推理引擎 进一步整合到同一家公司。
这再次说明 Rebellions 已经不想只做 Semiconductor Company。
它正在转向 Full-Stack AI Infrastructure Company。
2026 年已经使用 RebelServer 运行 SK Telecom 大模型
2026 年 7 月, Rebellions 宣布成功使用自己的 RebelServer 运行 SK Telecom 的 A.X K1 大型 Foundation Model。
公司还展示了基于这套平台运行 Agentic AI 服务。这种真实模型运行比单纯公布芯片 TFLOPS 更重要。
因为它说明:
Rebel100
软件栈
服务器
已经开始进入 Production AI Service 阶段。
与 Samsung 的关系非常深
Samsung 对 Rebellions 来说不是普通供应商。
双方在多个层面存在合作。
第一:Samsung Foundry。
ATOM 使用 Samsung 5nm。
Rebel100 使用 Samsung 4nm。
第二:先进封装。
Chiplet + HBM3E 对封装技术要求非常高。
第三:Samsung Ventures
也是 Rebellions 投资者。因此 Rebellions 的成长也与韩国完整半导体产业链密切相关。
SK Hynix 的战略价值可能更加重要
SK Hynix 是全球 HBM 最重要的厂商之一。
而 Rebellions 又恰恰需要 HBM3E。
所以 SK Hynix 成为股东之后,对 Rebellions 的意义并不只是 资金。更加重要的是 Memory Supply Chain。
AI Processor 公司
HBM 公司
Foundry
Advanced Packaging 组成一套完整产业联盟。
Rebellions 正在逐渐形成这种结构。
KT 是 Rebellions 最早的重要客户之一
韩国另一家大型电信运营商 KT 很早就投资 Rebellions。更加重要的是 KT Cloud 真正部署了 ATOM。
这帮助 Rebellions 完成从 Prototype 到 Commercial Data Center 的关键跨越。
很多 AI 芯片公司最大的问题就是 没有真实客户帮助验证芯片。
Rebellions 幸运的地方就在于 KT 和后来 SK Telecom 都提供了真实数据中心环境。
沙特阿美也是重要投资者
沙特阿美旗下Wa’ed Ventures也投资了 Rebellions。
2024 年,Wa’ed Ventures 又追加约 1500 万美元 投资。
当时 Rebellions 累计融资已经超过 2.25 亿美元。
Rebellions 随后进一步进入 Saudi Arabia。
2025 年,公司设立 Rebellions Saudi Subsidiary。
这与沙特大规模建设 AI Data Center 以及 Sovereign AI 基础设施有直接关系。
Sovereign AI 正成为 Rebellions 的重要机会
Sovereign AI 可以简单理解为:一个国家希望自己的 AI 算力、数据和模型掌握在自己手中。
过去很多国家建设 AI 平台只能购买 Nvidia GPU。但是现在越来越多国家开始希望拥有 第二供应商、开放架构 以及 更加自主的 AI Infrastructure。
Rebellions 因此把 Sovereign AI 作为最重要的全球市场之一。沙特、韩国、日本 以及其他国家都可能成为目标客户。
Rebellions 还在进入日本
2025 年 2 月 Rebellions 正式成立 Rebellions Japan。
日本本身拥有 汽车、机器人、制造业、电信 和 数据中心 等大量潜在 AI 市场。
2025 年,公司又与日本 Tomen Devices 等企业合作,进一步推动 AI 推理基础设施进入日本市场。
美国则可能决定 Rebellions 最终能走多远
Rebellions 已经在 Santa Clara, California 设立美国公司。
2025—2026 年,公司明显加快美国市场扩张,并引入美国 AI 基础设施领域高管。
原因很简单:如果 Rebellions 最终只能够在韩国市场成功,它可以成为一家很好的韩国半导体公司。
但如果它想真正成为 Global AI Chip Company ,就必须进入 美国数据中心市场。
2025 年融资 2.5 亿美元
2025 年 9 月 Rebellions 完成 2.5 亿美元 Series C。
当时公司估值约 14 亿美元。
这一轮投资者非常值得注意。包括:Arm,Samsung Ventures,Pegatron VC,Korea Development Bank 以及 其他国际投资机构。Arm 的加入尤其重要。
这说明 Rebellions 已经开始进入全球 CPU + AI Accelerator 产业链。
2026 年又融资 4 亿美元
仅仅大约半年以后,2026 年 3 月 30 日 Rebellions 又完成 4 亿美元 Pre-IPO 融资。
这一轮由 Mirae Asset Financial Group 以及 Korea National Growth Fund 领投。
融资完成以后,公司累计融资达到约 8.5 亿美元。估值约 23.4 亿美元。
这意味着 Rebellions 已经成为亚洲资金实力最强的独立 AI 芯片创业公司之一。
Rebellions 正在准备 IPO
这轮融资名称本身就是 Pre-IPO。
Rebellions 已经明确表示正在为未来上市做准备。
不过截至 2026 年 8 月 24 日,Rebellions 仍然是一家 非上市公司。
韩国媒体 2026 年 5 月报道,公司原本希望更早提交上市预审,但后来调整 IPO 时间表,市场预计正式上市时间可能推迟到 2027 年。
因此目前不能把 Rebellions 写成:“韩国上市 AI 芯片公司”。更加准确的是:正在进行 Pre-IPO 阶段的 AI 芯片独角兽。
Rebellions 为什么特别值得关注?
Rebellions 最大的特点,不只是 “韩国也有一家 AI 芯片公司”。真正有意思的是它的发展路线。
最早 ION,专攻 低延迟 AI。
然后 ATOM,专攻 低功耗数据中心推理。
后来 ATOM-Max,进入 大型 AI Inference。
现在 Rebel100,直接面向 LLM、MoE、Multimodal AI 和 Agentic AI。
产品又进一步从 芯片 扩大到:
RebelCard
↓
RebelServer
↓
RebelRack
↓
RebelPOD。
这是一条非常明显的 从 Chip 到 AI Factory 的发展路线。
Rebellions 与 Nvidia 最大的区别
Nvidia 的核心优势可以概括成:
GPU + CUDA + HBM + NVLink + NVSwitch + Networking + DGX。
Rebellions 则试图建立:
NPU + HBM3E + UCIe Chiplet + Open Software + RebelServer + RebelRack + RebelPOD。
但是两家公司最大的区别仍然是 Nvidia 更加通用。
Rebellions 更加集中于 Inference。
Rebellions 并没有把主要资源投入 大型 AI 模型训练。
它押注的是 未来真正最大的 AI 计算市场之一,会是 Inference。
为什么 Inference 市场可能比 Training 更大?
训练一个模型可能需要 几个月。但是模型一旦发布以后,可能连续运行 几年。
如果一个大模型每天服务 1 亿用户,每天生成 数百亿甚至数千亿 Token,长期计算成本非常庞大。
AI Agent 出现以后,这个数字还会继续增加。
因为一个用户请求背后可能触发 几十次模型调用。
因此 Tokens per Watt 以及 Tokens per Dollar,可能成为 AI 数据中心越来越重要的指标。这正是 Rebellions 希望进入的位置。
Rebellions 与 Groq 有什么不同?
Groq 同样重点发展 AI Inference。但两家公司架构不同。
Groq 的 LPU 特别强调 确定性执行、超低延迟 以及 高速 Token Generation。
Rebellions 更加强调 HBM + Chiplet + UCIe + 大规模数据中心扩展。
简单来说:
Groq 更像是在追求 极快的实时推理流水线。
Rebellions 则越来越像是在建设 完整的大规模 NPU AI 数据中心。
Rebellions 与 Tenstorrent 也不同
Tenstorrent 的路线是:RISC-V + Tensix + Chiplet + Networked AI。
它同时开发 CPU IP 和 AI Accelerator。
Rebellions 则更加集中 AI Inference NPU。
它没有同时建立自己的通用 CPU 架构。而是选择与 AMD、Arm 等 CPU 平台合作。
这种路线可以降低研发范围,让公司把更多资源投入 NPU、HBM、Chiplet 和 AI 软件。
Rebellions 与韩国 FuriosaAI 是直接竞争者
韩国另外一家非常重要的 AI 芯片公司是 FuriosaAI。
FuriosaAI 同样专注 AI Accelerator 和 LLM Inference。
因此韩国本土 AI 芯片市场实际上已经形成 Rebellions 和 FuriosaAI 两家非常有代表性的创业公司。
Rebellions 一个明显优势是 它已经通过与 SAPEON 合并获得 SK Telecom、SK Hynix 以及 SK 集团产业资源。
FuriosaAI 则依靠自己的独立技术路线竞争。
未来两家公司可能成为韩国 AI 半导体产业最值得观察的两个玩家。
Rebellions 最大的优势之一:韩国半导体产业链
韩国本来就是全球最强大的半导体国家之一。
拥有 Samsung Electronics 和 SK Hynix。
但是过去韩国最强的是 Memory Semiconductor。例如:DRAM、NAND、HBM。真正高性能 AI Logic Processor 市场,则被 Nvidia 等美国企业主导。
Rebellions 的意义就在于 ,韩国希望把 Memory 优势延伸到 AI Logic。
如果能够形成:
Rebellions NPU
Samsung Foundry
SK Hynix HBM
Samsung Advanced Packaging
那么韩国就可能建立更加完整的 AI Semiconductor Supply Chain。
第二个优势:性能功耗比
Rebellions 从 ION 到 ATOM 再到 Rebel100,一直非常强调 Energy Efficiency。这是一个越来越重要的问题。
今天一个大型 AI 数据中心可能需要 几十兆瓦、几百兆瓦,甚至 Gigawatt 级电力。
很多地区真正限制 AI 数据中心建设的已经不是 买不到服务器,而是 没有足够的电。
所以如果一个 AI Accelerator 可以在相同 Token 吞吐量下减少 20%,30% 甚至 50% 的电力,经济价值会非常巨大。
第三个优势:已经进入真实数据中心
Rebellions 不是只有 PPT 的 AI 芯片公司。
ATOM 已经进入 KT Cloud。
SK Telecom 已经使用 Rebellions NPU 测试真实 AI 服务。
2026 年 RebelServer 又已经运行 A.X K1 大型 Foundation Model。
这种商业验证是非常重要的竞争优势。
第四个优势:Chiplet 路线非常前沿
Rebel100 使用:UCIe-Advanced + 4 Chiplets。
如果 UCIe 最终真的成为未来 Chiplet 的通用标准,那么 Rebellions 很早就获得了相关工程经验。
未来公司甚至可以进一步把 NPU Chiplet、CPU Chiplet、I/O Chiplet、Memory Controller 组合成更复杂的 AI Processor。
第五个优势:已经从芯片扩展到系统
Rebellions 现在已经能够提供:
Rebel100
RebelCard
RebelServer
RebelRack
以及 RebelPOD。
加上 软件、模型优化 和 SqueezeBits 推理技术,它已经逐渐接近 完整 AI Infrastructure Vendor。
这比单纯出售一颗 ASIC 更容易进入大型企业。
Rebellions 最大的挑战仍然是 CUDA
Rebellions 最大的问题仍然是 CUDA。
今天 AI 工程师已经习惯:
PyTorch
CUDA
cuDNN
NCCL
TensorRT
Triton。
如果使用 Rebel100 需要大量重新开发代码,很多企业就不会迁移。
所以 Rebellions 现在大量投入 PyTorch、vLLM、Triton、Red Hat 以及 Open Source 生态。
从长期来看 软件兼容性甚至可能比 Rebel100 本身的峰值 TFLOPS 更重要。
第二个挑战:Rebellions 主要做推理
专攻推理有优势,也有风险。
优势是 可以针对 LLM Inference 做得更加高效。
但是 Nvidia GPU 最大的优势之一就是 同一套硬件什么都能做。
客户购买 GPU 后可以 今天训练模型,明天做推理,后天运行 HPC。
如果购买一套只能高效执行某类推理任务的 NPU,客户需要更加确定 未来工作负载不会发生巨大变化。
因此 Rebellions 必须保持足够强的 Programmability。
第三个挑战:性能还需要更多第三方验证
AI 芯片公司几乎都会公布 与 Nvidia 相比性能更高、功耗更低 或者 成本更低。
但是企业真正部署时,还需要看 真实 LLM、真实 Batch Size、真实 Context Length、真实并发用户 以及 真实软件版本。
因此 Rebel100 能否长期建立信誉,很大程度上取决于 MLPerf 等标准 Benchmark 以及 大型第三方客户实际测试结果。
第四个挑战:先进封装和 HBM
Rebel100 的优势:144GB HBM3E。同时也是供应链挑战。
HBM3E 本身就非常昂贵。而 HBM + 4 Chiplet + UCIe + Advanced Packaging 制造难度明显高于普通 PCIe ASIC。
因此未来 Rebellions 不仅需要设计好芯片。还必须解决 HBM 供应、先进封装良率、Samsung Foundry 产能 以及 大规模量产成本。
第五个挑战:Nvidia 的规模太大
Rebellions 2026 年估值约 23.4 亿美元。这对于创业公司来说已经非常可观。但是与 Nvidia 相比,仍然是非常小的公司。
Nvidia 每年可以投入巨额研发资金,同时控制 GPU、Networking、Software、Server 以及全球开发者生态。
Rebellions 不需要真正“击败 Nvidia”才能成功。
更加现实的目标可能是:在 AI Inference、Sovereign AI 和低功耗数据中心中占据一个稳定市场。
Sovereign AI 可能成为 Rebellions 最大机会之一
对于美国大型云计算公司来说 ,Nvidia GPU 已经拥有非常成熟的生态。
但是对于 韩国、沙特、日本 以及很多希望建立自己 AI 基础设施的国家来说,第二供应商 本身就有战略价值。
如果 Rebellions 能提供 性能足够好、价格合理、能效优秀、软件开放 并且 不被单一美国 GPU 生态锁定的 AI 基础设施,那么它并不一定需要全面超越 Nvidia。
它只需要成为 可信赖的 Alternative AI Infrastructure。
这已经是一个非常大的市场。
Rebellions 未来可能不再被称作“芯片公司”
观察 Rebellions 最近的发展,可以看到一个很明显的变化。
2023 年公司最重要的产品是 ATOM Chip。
2026 年,公司官网重点已经变成:
Rebel100
RebelServer
RebelRack
RebelPOD。
与此同时,又收购了:
SqueezeBits。
这意味着公司的核心产品已经从 Silicon 逐渐扩大到 Inference Infrastructure。
未来 Rebellions 更可能把自己定义成 AI Infrastructure Company。而不只是 AI Semiconductor Company。
总结
Rebellions 是目前全球 AI 芯片创业公司中发展速度非常快的一家公司,也是韩国最重要的 AI NPU 企业之一。
它的发展路线非常清楚:
2020:Rebellions 成立
↓
2021:ION
面向金融和超低延迟 AI。
↓
2022—2023:ATOM
进入数据中心 AI 推理。
↓
2024:ATOM 大规模商业化
同时与 SAPEON 推动合并。
↓
2024 年 12 月:Rebellions + SAPEON
↓
2025:REBEL-Quad / Rebel100
进入 HBM3E + UCIe Chiplet + Frontier LLM。
↓
2026:RebelServer + RebelRack + RebelPOD
开始直接提供完整 AI Factory。
与此同时,公司又在 2026 年收购 SqueezeBits,把模型优化和推理软件进一步纳入自己的技术体系。
从芯片技术来看,Rebellions 当前最值得关注的是 Rebel100。
它拥有:
4 个 UCIe-Advanced Chiplet
144GB HBM3E
4.8TB/s HBM 带宽
约 1 PFLOPS FP16
以及:
约 2 PFLOPS FP8。
但是更加重要的是:
Rebellions 已经不再只是比较:
“我的 NPU 有多少 TFLOPS。”
它正在构建:
NPU
HBM
Chiplet
Open Software
AI Server
Rack
AI Factory。
2025 年,公司完成 2.5 亿美元 Series C;2026 年 3 月又完成 4 亿美元 Pre-IPO 融资,累计融资达到约 8.5 亿美元,估值约 23.4 亿美元。截至 2026 年 8 月,公司仍然属于私人企业,正式 IPO 尚未完成。
Rebellions 最终能否成为真正的全球 AI 芯片巨头,现在还不能下结论。
但它拥有几个非常难得的条件:
Samsung 的 Foundry 和先进封装能力
SK Hynix 的 HBM 能力
SK Telecom 和 KT 的真实数据中心
沙特资本与 Sovereign AI 市场
以及:
一支真正拥有 ASIC、系统架构和 AI 软件经验的团队。
未来真正决定 Rebellions 成败的,可能不是 Rebel100 的单项峰值算力,而是四个问题:
Rebel100 能不能实现真正的大规模量产?
PyTorch、vLLM 和 Triton 软件体验能不能接近 GPU?
RebelRack 和 RebelPOD 能不能稳定扩展到大型 AI 数据中心?
Rebellions 能不能在韩国之外获得真正的大型商业客户?
如果这些问题能够逐渐解决,Rebellions 很可能不只是 “韩国的 Nvidia 挑战者”。
它更加可能成为 AI 时代另外一种重要计算路线:
专门为大规模推理打造的、开放而高能效的 NPU 基础设施平台。