一、什么是 GPU?
GPU 是 Graphics Processing Unit 的缩写,中文称为图形处理器。
GPU 最初主要用于加速计算机图形处理,例如绘制三维游戏画面、处理图像、显示复杂的视觉效果以及执行图形渲染任务。
随着计算技术的发展,人们发现 GPU 不仅能够处理图形,还特别适合执行大量相似的数学运算,因此逐渐被应用于科学计算、人工智能、机器学习、视频处理和高性能计算等领域。
今天,GPU 已经不再只是游戏显卡中的图形处理芯片。在人工智能服务器、超级计算机、自动驾驶系统以及各种数据处理平台中,GPU 都扮演着重要角色。
尤其是在深度学习领域,GPU 已经成为训练和运行大型神经网络的重要计算设备。
要理解 GPU 为什么能够执行这些任务,首先需要了解 CPU 和 GPU 在设计目标上的区别。
CPU 主要追求灵活性、低延迟和复杂任务的执行效率,而 GPU 更注重在同一时间处理大量数据的能力。
这种设计上的差异,决定了 GPU 特别适合并行计算。
二、CPU 与 GPU 有什么区别?
CPU 是 Central Processing Unit 的缩写,中文称为中央处理器。CPU 是计算机的通用处理核心,负责执行操作系统、应用程序以及各种控制和计算任务。
现代 CPU 通常拥有多个功能强大的核心,每个核心都能够执行复杂指令,并使用缓存、分支预测和乱序执行等技术提高程序运行效率。
GPU 的设计思路则有所不同。GPU 通常拥有大量算术运算单元,并通过专门的并行执行结构,让许多计算任务同时进行。
与 CPU 相比,GPU 通常把更多芯片资源投入到计算吞吐量上,而不是让每个执行单元都具备与 CPU 核心相同的复杂控制能力。
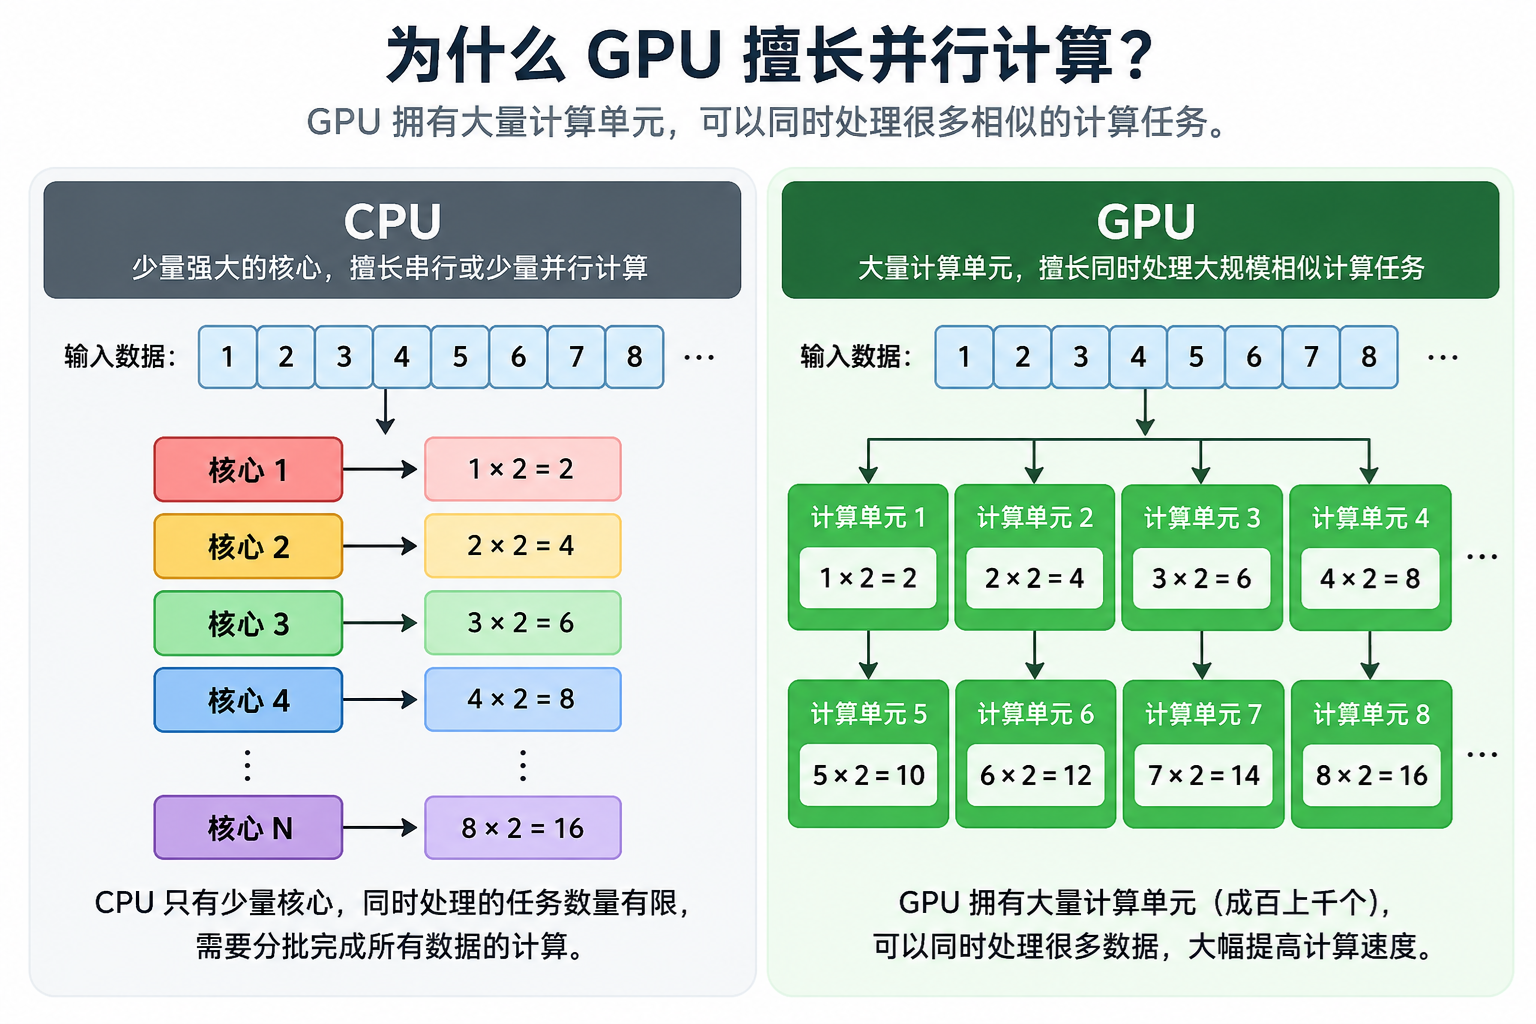
可以用一个简单的例子理解两者之间的区别。假设现在需要对一百万个数字执行相同的乘法运算。
CPU 可以利用多个核心和向量指令分批完成计算,而 GPU 则能够把这些数据分配给大量并行执行的线程,让许多乘法运算同时进行。
如果一个程序包含大量复杂判断、频繁的任务切换,或者必须等待前一步结果才能继续执行,那么 CPU 往往更合适。
GPU 的优势主要来自大量能够同时执行的计算任务,而不是单个任务必然执行得更快。
因此,CPU 和 GPU 并不是简单的替代关系,而是面向不同工作负载设计的处理器。
现代计算机通常让 CPU 负责系统控制、任务调度和一般程序执行,让 GPU 负责适合大规模并行处理的计算工作。
三、什么是并行计算?
并行计算是指把一个计算问题分成多个可以同时执行的部分,再利用多个处理单元共同完成任务。它与串行计算形成对比。在串行计算中,操作通常按照一定顺序逐步执行;在并行计算中,只要各个操作之间没有必须等待的依赖关系,就可以让它们同时运行。
假设有一百万张图片需要调整亮度。如果按照串行方式处理,程序可以先处理第一张图片,再处理第二张图片,直到所有图片处理完成。如果使用并行计算,就可以同时处理多张图片,或者把一张图片中的不同像素分配给不同线程进行计算。
例如,一个图像像素的亮度调整可能只需要读取原始像素值、执行一次数学计算,再写回新的像素值。对于大多数普通图像处理操作,一个像素的计算并不需要等待其他像素的结果。这样的任务可以拆分成大量相对独立的小任务,非常适合 GPU。
并行计算也存在限制。如果任务之间存在严格的数据依赖关系,例如必须先得到第一个计算结果才能进行第二次计算,那么简单地增加处理单元并不能让所有步骤同时执行。
因此,并行计算的关键不仅是拥有大量处理单元,更重要的是计算任务能否被有效地分解,以及这些任务之间是否存在复杂的依赖关系。
四、为什么 GPU 擅长并行计算?
GPU 擅长并行计算,主要是因为它的硬件结构、线程执行方式、内存系统以及任务调度机制都围绕高吞吐量进行了优化。
现代 GPU 包含多个并行计算单元。
不同厂商对这些计算单元使用不同名称,例如 NVIDIA GPU 中的 Streaming Multiprocessor,简称 SM;AMD GPU 中也有用于组织大量并行执行资源的计算单元结构。
每个计算单元可以管理和执行多个线程组,通过大量线程共同处理计算任务。
GPU 的优势并不是简单地把每个线程都安排到一个完全独立的处理器核心上,而是通过共享执行资源、协调线程执行以及快速切换可执行的线程组,提高整个芯片的计算资源利用率。
例如,在向量加法任务中,我们需要计算两个数组中对应元素的和。如果两个数组各有一百万个元素,那么每一对元素的加法通常都可以独立执行。
GPU 可以为这些元素安排大量线程,在不同执行单元上并行完成计算。
GPU 还特别适合处理具有统一计算模式的数据。当成千上万个线程需要执行相同或相近的操作时,GPU 可以有效利用其并行指令执行结构,减少重复的控制开销。
此外,GPU 具有面向高吞吐量优化的内存系统。
高性能独立 GPU 通常使用 GDDR 或 HBM 等高带宽显存技术,让大量计算单元能够持续读取和写入数据。
对于需要处理大型矩阵、图像和神经网络张量的任务,内存带宽往往直接影响计算效率。
这些因素共同形成了 GPU 的核心优势:通过大量并行线程、较高的计算吞吐量以及高带宽内存,在单位时间内完成大量相似的计算。
五、GPU 如何同时执行大量线程?
理解 GPU 并行计算,还需要区分线程、执行单元和处理器核心。
线程可以理解为程序中的一条执行任务。
对于 GPU 而言,程序通常会启动大量线程,让不同线程处理不同的数据元素。例如,在数组加法中,第一个线程可以处理第一个元素,第二个线程处理第二个元素,以此类推。
但 GPU 启动一百万个线程,并不意味着芯片内部同时存在一百万个独立的物理计算核心。
线程是软件执行任务的抽象,而物理执行单元是实际完成计算的硬件资源。大量线程会根据 GPU 的资源和调度机制,分批或交错地执行。
以 NVIDIA 的 CUDA 架构为例,线程会被组织成 Thread Block,也就是线程块。硬件执行时,还会把线程组织成 Warp。
一个 Warp 通常包含 32 个线程,这些线程以协调的方式执行指令。
这种执行模式通常称为 SIMT,即 Single Instruction, Multiple Threads,中文可以理解为单指令、多线程。
多个线程拥有各自的执行状态和数据,但在硬件执行层面,它们会被组织起来共同执行指令。
需要注意的是,SIMT 并不意味着所有线程必须始终执行完全相同的程序路径。
如果不同线程遇到不同的条件分支,GPU 仍然能够执行这些分支,但可能需要分别处理不同的线程执行路径,从而降低部分并行效率。
现代 GPU 会通过硬件调度,在某些线程等待内存数据时执行其他已经准备好的线程。这种方式能够隐藏部分内存访问延迟,让计算单元尽量保持忙碌。
因此,GPU 的强大并行能力来自大量线程的高效组织与调度,而不只是物理计算单元的数量。
六、什么是 SIMD 和 SIMT?
在介绍 GPU 架构时,经常会遇到 SIMD 和 SIMT 两个术语。它们都与并行执行有关,但含义并不完全相同。
SIMD 是 Single Instruction, Multiple Data 的缩写,中文称为单指令、多数据。
它表示一条指令可以对多个数据元素执行相同类型的操作。例如,一条向量加法指令可以同时处理多个整数或者浮点数。
现代 CPU 也支持 SIMD。Intel 和 AMD 处理器中的 SSE、AVX 等向量指令集,就是 CPU 使用数据并行技术的典型例子。因此,并行计算并不是 GPU 独有的能力。
SIMT 则强调多个线程的执行组织方式。程序员可以把计算任务划分为大量逻辑线程,每个线程处理不同的数据和索引。GPU 硬件再把这些线程组织成适合并行执行的线程组。
从硬件执行方式来看,GPU 的 SIMT 往往利用类似 SIMD 的并行执行资源,但它为程序提供的是多线程编程模型。不同 GPU 架构在执行宽度、线程组织方式和调度细节上可能存在差异。
对于初学者来说,可以简单理解为:SIMD 关注一条指令如何处理多个数据元素,而 SIMT 关注大量线程如何在 GPU 硬件上协调执行。
七、GPU 为什么适合矩阵计算?
矩阵可以理解为按行和列排列的一组数字。在计算机图形学、科学计算、机器学习和人工智能中,大量问题都可以表示为矩阵或张量运算。
例如,神经网络经常需要执行矩阵乘法。假设有两个大型矩阵,程序需要通过乘法和加法计算结果矩阵中的各个元素。在满足计算依赖关系的情况下,结果矩阵中许多元素可以同时计算。
GPU 可以把这些计算任务划分到大量线程或线程组中,让多个计算单元并行完成运算。通过合理安排数据分块、缓存使用以及内存访问方式,还可以减少重复的数据读取,提高整体计算效率。
现代 AI GPU 通常还提供专门用于矩阵计算的硬件单元。例如,NVIDIA 的 Tensor Cores 可以加速特定数据类型和形状的矩阵运算。其他 GPU 厂商也提供相应的矩阵计算加速能力。
这些专用硬件通常支持 FP16、BF16、FP8 等不同数值格式,具体支持范围取决于 GPU 架构。
与传统的 FP32 浮点计算相比,使用较低精度的数据格式通常能够降低数据传输量,并在适当的硬件上提高计算吞吐量。
不过,低精度计算可能带来数值误差,因此实际应用需要根据算法要求选择合适的精度。
AI 训练和推理往往会采用混合精度计算,在性能和数值稳定性之间取得平衡。
正是因为 GPU 能够高效执行大规模矩阵运算,它才成为现代人工智能计算的重要基础。
八、GPU 为什么能够加速人工智能?
人工智能,尤其是深度学习,需要执行大量重复的数学计算。
神经网络在训练过程中,需要根据输入数据计算预测结果,再根据误差调整模型参数。这一过程通常涉及矩阵乘法、向量运算、归一化、激活函数以及梯度计算。
这些操作中的许多部分具有很高的数据并行性。GPU 可以让大量线程共同执行计算,从而显著提高神经网络的训练吞吐量。
例如,在大型语言模型中,输入文本首先被转换为 Token,也就是模型处理的基本文本单位。随后,这些 Token 会被映射为数值向量,并经过多层神经网络处理。
在 Transformer 模型中,注意力机制、线性投影和前馈网络等部分都包含大量矩阵运算。这些计算可以有效利用 GPU 的并行计算能力以及专门的矩阵运算硬件。
但是,GPU 加速 AI 并不是简单地让更多线程运行。计算还受到显存容量、内存带宽、数据传输速度以及不同运算之间依赖关系的影响。
例如,在大型语言模型推理过程中,Prefill 阶段通常需要处理输入提示中的多个 Token,因此能够形成较大的并行计算任务。而在自回归生成的 Decode 阶段,后一个 Token 的生成通常依赖前一个 Token,因此单条请求的生成过程存在顺序限制。
在这种情况下,GPU 即使拥有非常强大的理论计算能力,也可能因为显存带宽、KV Cache 读取以及每一步生成的数据依赖而无法始终发挥全部计算性能。
这说明 GPU 的并行能力非常重要,但实际 AI 性能还取决于整个系统的设计。
九、显存和内存带宽为什么重要?
GPU 要执行并行计算,首先需要获取数据。计算单元即使能够以极高速度进行数学运算,如果数据不能及时送达,仍然需要等待。
GPU 的内存系统因此非常重要。独立 GPU 通常配备专用显存,例如 GDDR6、GDDR7 或 HBM。不同类型的显存具有不同的带宽、容量、功耗和封装成本特点。
内存带宽表示单位时间内可以传输的数据量,通常使用 GB/s 或 TB/s 表示。带宽越高,理论上每秒能够在显存和计算单元之间传输的数据就越多。
例如,一个计算任务需要不断读取大量数组数据,但每读取一个元素只执行少量数学运算。在这种情况下,性能可能主要受到内存带宽限制,而不是计算单元的理论运算速度限制。
相反,如果一个计算任务能够重复使用已经加载到高速缓存或片上存储中的数据,并执行大量数学运算,那么它就可能更接近计算能力的上限。
这种区别可以通过 Arithmetic Intensity,也就是算术强度来理解。算术强度描述计算任务每传输一定数量的数据能够完成多少次运算。
算术强度较低的任务通常更容易受到内存带宽限制,而算术强度较高的任务更有机会发挥 GPU 的计算吞吐量。
GPU 架构也使用寄存器、缓存和片上共享存储等机制来减少不必要的显存访问。开发者可以通过合理组织数据布局、提高数据复用率以及优化线程之间的协作,提高计算效率。
因此,判断一块 GPU 的性能时,不能只看计算单元数量或者理论浮点运算速度,还需要综合考虑显存带宽、容量和实际程序的访问方式。
十、GPU 并行计算有哪些限制?
尽管 GPU 擅长大规模并行计算,但它并不是所有任务的最佳选择。
首先,GPU 需要足够多的可并行任务。如果程序只有少量计算,或者执行过程存在大量前后依赖,那么 GPU 的大量计算资源可能无法充分利用。
其次,GPU 对控制流程复杂的任务可能不够高效。如果同一线程组中的不同线程频繁进入不同条件分支,就可能出现线程执行路径分化。
这种现象通常称为 Branch Divergence,即分支分歧。它可能导致部分执行资源暂时无法参与有效计算。
第三,数据传输会产生额外开销。在传统的 CPU 加独立 GPU 系统中,CPU 主内存和 GPU 显存通常位于不同的物理存储设备上。
将数据从 CPU 内存传输到 GPU 显存,或者把计算结果传回 CPU,都可能消耗时间。对于计算量很小的任务,数据传输和 GPU 启动开销甚至可能超过计算本身的时间。
第四,GPU 的并行线程需要合理管理共享数据。如果多个线程需要修改同一个位置的数据,就可能产生数据竞争问题。
程序必须使用同步、原子操作或其他机制保证结果正确,而这些操作可能降低并行效率。
此外,GPU 程序的性能还受到寄存器占用、线程组大小、缓存命中率、内存访问模式和计算精度等因素影响。
因此,一个程序能否在 GPU 上获得明显加速,需要结合实际算法、数据规模和硬件架构进行分析,而不能只根据 GPU 的理论计算能力判断。
十一、GPU 除了人工智能还能做什么?
在计算机图形学中,GPU 负责几何处理、光栅化、纹理采样、着色和图像输出等工作。
现代 GPU 还能够通过专门的硬件单元加速部分光线追踪计算,让游戏和三维应用生成更加真实的光照、阴影和反射效果。
在视频处理领域,GPU 可以加速图像缩放、颜色转换、滤镜处理和部分视频制作任务。
许多 GPU 还集成独立的视频编码与解码引擎,用于处理 H.264、HEVC、AV1 等格式。需要注意的是,专用视频引擎与执行通用并行计算的 GPU 运算单元并不完全相同。
在科学计算领域,GPU 被广泛应用于流体力学、分子动力学、天气模拟、物理计算和工程仿真。
这些问题通常需要对大量网格、粒子或者数值矩阵执行相似运算,因此能够从大规模并行计算中受益。
在医学影像领域,GPU 可以加速 CT 和 MRI 图像重建、三维可视化以及部分图像分析任务。在金融计算中,GPU 也可以用于蒙特卡洛模拟、风险分析和某些数值模型。
随着通用 GPU 计算技术的发展,开发者可以使用 CUDA、OpenCL、HIP、SYCL 等编程平台或技术,把适合并行执行的计算任务交给 GPU,而不必把 GPU 限制在传统图形渲染工作中。
这种利用 GPU 执行通用计算的方法,通常称为 GPGPU,也就是 General-Purpose Computing on Graphics Processing Units,中文称为通用图形处理器计算。
十二、GPU 能够代替 CPU 吗?
虽然 GPU 在许多计算任务中具有显著优势,但它并不能完全代替 CPU。
操作系统需要处理复杂的控制流程、系统调用、硬件中断、进程管理、文件系统和设备驱动。
这些任务通常包含大量条件判断和顺序依赖,对执行延迟与灵活性有较高要求,因此适合由 CPU 负责。
GPU 则更适合接收已经组织好的计算任务,对大量数据进行集中处理。
例如,当应用程序需要训练神经网络时,CPU 可以负责程序逻辑、数据准备以及计算任务提交,而 GPU 负责执行大规模矩阵运算。
当然,现代 CPU 也可以执行并行计算,GPU 也不局限于简单数学运算。随着处理器技术的发展,CPU、GPU、NPU 和其他专用加速器之间的分工正在不断变化。
NPU 是 Neural Processing Unit 的缩写,中文通常称为神经网络处理单元。它主要针对某些神经网络运算进行优化,常见于智能手机、个人计算机和嵌入式设备。
在现代计算系统中,CPU、GPU 和 NPU 可以根据工作负载发挥各自优势。真正重要的不是让某一种处理器完成全部任务,而是把不同类型的计算安排到合适的硬件上。
十三、如何判断一个程序适不适合 GPU?
判断一个程序是否适合 GPU,可以从计算任务的并行性、数据规模、内存访问以及控制流程几个方面进行分析。
首先,需要判断任务能否分解为大量相对独立的操作。如果不同数据元素可以同时处理,那么 GPU 通常具有较好的发挥空间。例如,图像像素处理、大规模矩阵乘法以及大量粒子的物理计算都具有明显的数据并行性。
其次,需要考虑数据规模。GPU 的任务启动和数据传输存在一定开销。如果只处理几个数字,使用 CPU 可能更加直接高效。如果需要处理数百万个数据元素,GPU 的并行吞吐量优势通常更容易体现出来。
第三,需要分析数据访问方式。如果程序不断进行不规则的内存访问,或者频繁等待随机位置的数据,GPU 就可能难以充分利用内存带宽。相反,连续、合并且能够重复利用数据的访问模式通常更有利于高效执行。
第四,需要考察程序中的分支和同步操作。如果线程之间存在大量相互等待,或者不同线程执行完全不同的控制路径,那么 GPU 的并行效率可能受到影响。
最后,还需要根据具体 GPU 架构、计算精度要求以及软件实现进行性能测试。理论上适合并行的算法,不一定能够自动获得理想加速。实际性能通常依赖合理的并行划分、内存管理和程序优化。
十四、总结:GPU 的真正优势是什么?
GPU 的核心优势不是简单地拥有更多核心,而是采用了面向高吞吐量计算的硬件架构,能够高效组织大量线程,并对大规模数据执行相同或相近的数学运算。
CPU 更强调通用性、复杂控制和单个任务的低延迟执行,而 GPU 更强调大规模数据并行和整体计算吞吐量。
当计算任务能够分解成大量相对独立的操作时,GPU 就有机会显著提高处理速度。
从早期的三维图形渲染,到现代的人工智能训练、科学模拟和高性能计算,GPU 的发展始终围绕如何更有效地处理大规模并行工作负载展开。
但 GPU 的性能并不只取决于计算单元数量。线程调度、内存带宽、缓存结构、数据复用、数值精度以及任务之间的依赖关系,都会影响最终计算效率。
理解 GPU,也就需要理解现代计算机性能的一个基本原则:处理器的速度不仅取决于它每秒能够执行多少次运算,还取决于这些运算能否同时进行,以及数据能否及时到达计算单元。