随着人工智能技术的发展,越来越多的计算机、智能手机和嵌入式设备开始配备专门的 AI 处理器。
其中,NPU(Neural Processing Unit,神经网络处理单元)正在成为现代芯片的重要组成部分。
传统计算机主要依靠 CPU 和 GPU 完成计算任务。那么,为什么 AI 还需要 NPU?NPU 与 CPU、GPU 有什么不同?它又是如何加速人工智能计算的?
一、什么是 NPU?
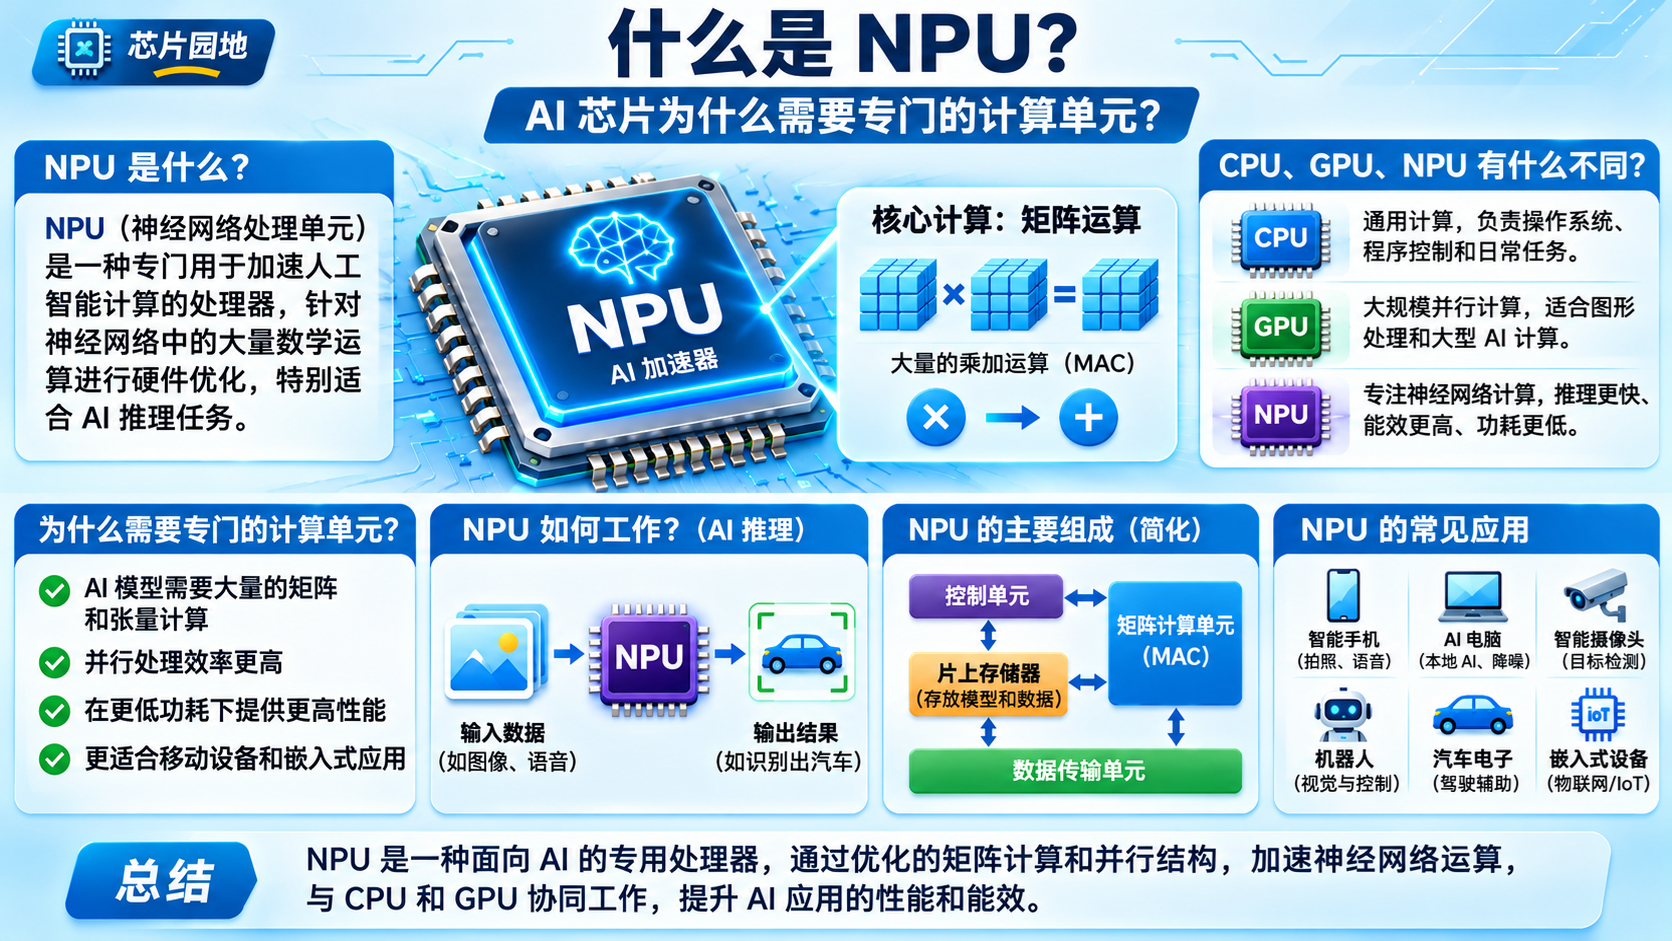
NPU 是一种专门用于加速人工神经网络计算的处理器。它针对机器学习和深度学习中的常见数学运算进行了硬件优化,尤其适合执行 AI 模型的推理任务。
所谓 AI 推理(AI Inference),就是使用已经训练好的模型处理新数据并生成结果。例如,智能手机识别人脸、计算机识别语音、摄像头检测物体,以及本地运行的小型语言模型,都可能使用 NPU 加速。
与通用 CPU 不同,NPU 不需要高效处理所有类型的程序,而是重点优化神经网络中的重复计算,从而提高计算吞吐量并降低功耗。
二、为什么 AI 需要专门的计算单元?
传统 CPU 擅长执行复杂的程序指令、逻辑判断和操作系统任务,但神经网络具有不同的计算特点。
例如,在图像识别任务中,AI 模型可能需要对大量数字进行乘法和加法运算。这些计算通常涉及向量、矩阵和张量。
张量(Tensor)可以简单理解为多维数字数组。神经网络使用张量保存输入数据、模型权重和中间计算结果。
AI 模型运行时,可能需要执行数百万甚至数十亿次乘加运算。如果完全依靠 CPU,某些模型的执行速度和能源效率可能无法满足设备要求。
因此,芯片设计人员开发了专门的矩阵计算单元,让大量乘法和加法可以并行执行。
这也是 NPU 的核心设计思想:让专门的硬件高效处理神经网络中最常见的计算。
三、NPU 是如何工作的?
NPU 的工作过程可以分为几个主要步骤。
首先,系统将需要处理的数据送入 AI 模型。例如,输入数据可能是一张图片、一段语音,或者来自传感器的一组测量值。
接下来,NPU 从内存读取模型参数和输入数据,并使用内部计算单元执行神经网络运算。
这些计算通常包括矩阵乘法、卷积运算、加法,以及 ReLU 等激活函数。
NPU 内部的大量计算单元可以同时处理不同的数据,从而提高运算效率。
计算完成后,结果被写回内存,再由 CPU 或应用程序进行后续处理。
需要注意的是,NPU 通常不是独立运行整个 AI 应用程序。CPU 仍然负责操作系统、任务调度和应用程序控制,NPU 主要承担适合硬件加速的神经网络计算。
四、NPU 内部有哪些主要组成部分?
虽然不同厂商的 NPU 架构存在差异,但通常包含以下几类硬件。
矩阵计算单元(Matrix Computing Unit): 负责大量矩阵乘法和并行计算,是许多 NPU 的核心组成部分。
乘加单元(MAC Unit): MAC 是 Multiply-Accumulate 的缩写,表示乘法累加运算。它将两个数字相乘,再把结果加到累加器中。神经网络中的大量计算都可以分解为乘加操作。
片上存储器(On-Chip Memory): 用于暂存模型权重、输入数据和中间结果,减少频繁访问外部内存带来的延迟和功耗。
数据传输单元(Data Transfer Engine): 负责在计算单元、片上存储器和系统内存之间搬运数据。
控制单元(Control Unit): 负责协调计算任务、数据流和硬件资源。
优秀的 NPU 设计不仅需要强大的计算能力,还必须减少数据传输开销,因为在现代 AI 芯片中,数据搬运可能消耗大量时间和能源。
五、为什么 NPU 可以降低功耗?
NPU 的能源效率主要来自专用计算结构、并行处理和较低精度的数值运算。
传统 CPU 需要支持复杂的指令集、分支预测和各种通用计算功能,而 NPU 可以将更多硬件资源用于神经网络中的常见操作。
此外,许多 NPU 支持 INT8 等低精度数据格式。
INT8 使用 8 位整数表示数值。与 FP32 等较高精度格式相比,适当使用 INT8 可以减少数据存储量和传输带宽需求,并提高硬件计算效率。
不过,低精度运算可能影响模型准确率,因此需要经过量化和精度验证。
通过专用硬件和数据流优化,NPU 在适合的 AI 工作负载上通常能够提供较高的每瓦性能。
六、NPU、CPU 和 GPU 有什么区别?
CPU、GPU 和 NPU 都可以执行计算,但设计目标不同。
CPU(中央处理器): 主要负责操作系统、应用程序、逻辑控制和通用计算。它具有很强的灵活性,适合执行复杂的软件任务。
GPU(图形处理器): 具有大量并行计算资源,适合图形渲染、科学计算,以及 AI 模型训练和推理。
NPU(神经网络处理单元): 专门优化神经网络计算,通常重点关注推理速度、计算吞吐量和能源效率。
例如,在一台 AI 笔记本电脑中,CPU 可以运行应用程序,GPU 可以负责图形渲染和大型并行任务,而 NPU 可以加速兼容的语音识别、图像处理等本地 AI 功能。
三种处理器并不是互相替代,而是根据工作负载进行分工。
七、什么是 TOPS?数值越大越好吗?
在介绍 NPU 性能时,厂商经常使用 TOPS 作为指标。
TOPS 是 Trillions of Operations Per Second 的缩写,表示每秒万亿次运算。
例如,一颗标称 40 TOPS 的 NPU,在规定的计算精度和测试条件下,理论峰值可以达到每秒 40 万亿次运算。
但是,TOPS 并不等于真实应用程序的运行速度。
实际性能还取决于模型结构、数据精度、内存带宽、软件驱动和硬件利用率。
另外,不同厂商对运算次数的统计方式可能有所不同,因此不能只看 TOPS 数字就判断哪颗 AI 芯片更快。
八、NPU 可以运行大语言模型吗?
可以,但需要满足模型与硬件的兼容条件。
大语言模型(LLM)需要大量矩阵计算,同时还需要存储模型权重和运行过程中产生的数据。
部分 NPU 可以加速语言模型中的矩阵运算,但并非所有模型都能完整运行在 NPU 上。
模型大小、内存容量、支持的数据格式、算子类型以及软件框架,都会影响运行效果。
例如,一些较小、经过量化的语言模型可以在支持的 NPU 上运行,而更大的模型可能需要 GPU、CPU 或云端计算资源。
因此,拥有 NPU 不代表计算机一定能够流畅运行所有 AI 模型。
九、NPU 主要应用在哪些领域?
智能手机: 用于人脸识别、计算摄影、语音处理、实时翻译和图像增强。
AI 个人电脑: 用于背景虚化、语音降噪、视频会议效果,以及兼容的本地 AI 应用。
智能摄像头: 用于目标检测、图像分类和实时视频分析。
机器人与嵌入式系统: 用于视觉识别、传感器数据分析和部分智能控制功能。
汽车电子: 用于部分驾驶辅助、车内监测和传感器数据处理任务。
在这些领域,低功耗和本地实时处理通常比单纯追求最高计算速度更加重要。
十、NPU 与 AI 芯片是什么关系?
NPU 是 AI 加速器的一种,但并不是所有 AI 芯片都叫 NPU。
AI 芯片是一个更广泛的概念,包括用于 AI 训练或推理的 GPU、专用加速器和其他定制处理器。
一些智能手机和笔记本电脑采用 SoC(System on a Chip,片上系统)架构,把 CPU、GPU、NPU、内存控制器和其他功能模块集成在一颗芯片中。
这种设计可以让不同处理单元共享系统资源,并根据任务选择适合的计算硬件。
另外,NPU 往往也属于某种专用集成电路(ASIC)设计,但并非所有 ASIC 都是 NPU。
总结
NPU 是一种针对人工神经网络计算优化的专用处理器。它通过矩阵计算单元、乘加运算、片上存储器和数据流优化,提高 AI 推理的处理效率。
CPU 负责通用计算,GPU 擅长大规模并行计算,而 NPU 专注于高效执行兼容的神经网络任务。