沐曦股份(MetaX):中国高性能 GPU 与 AI 算力芯片企业
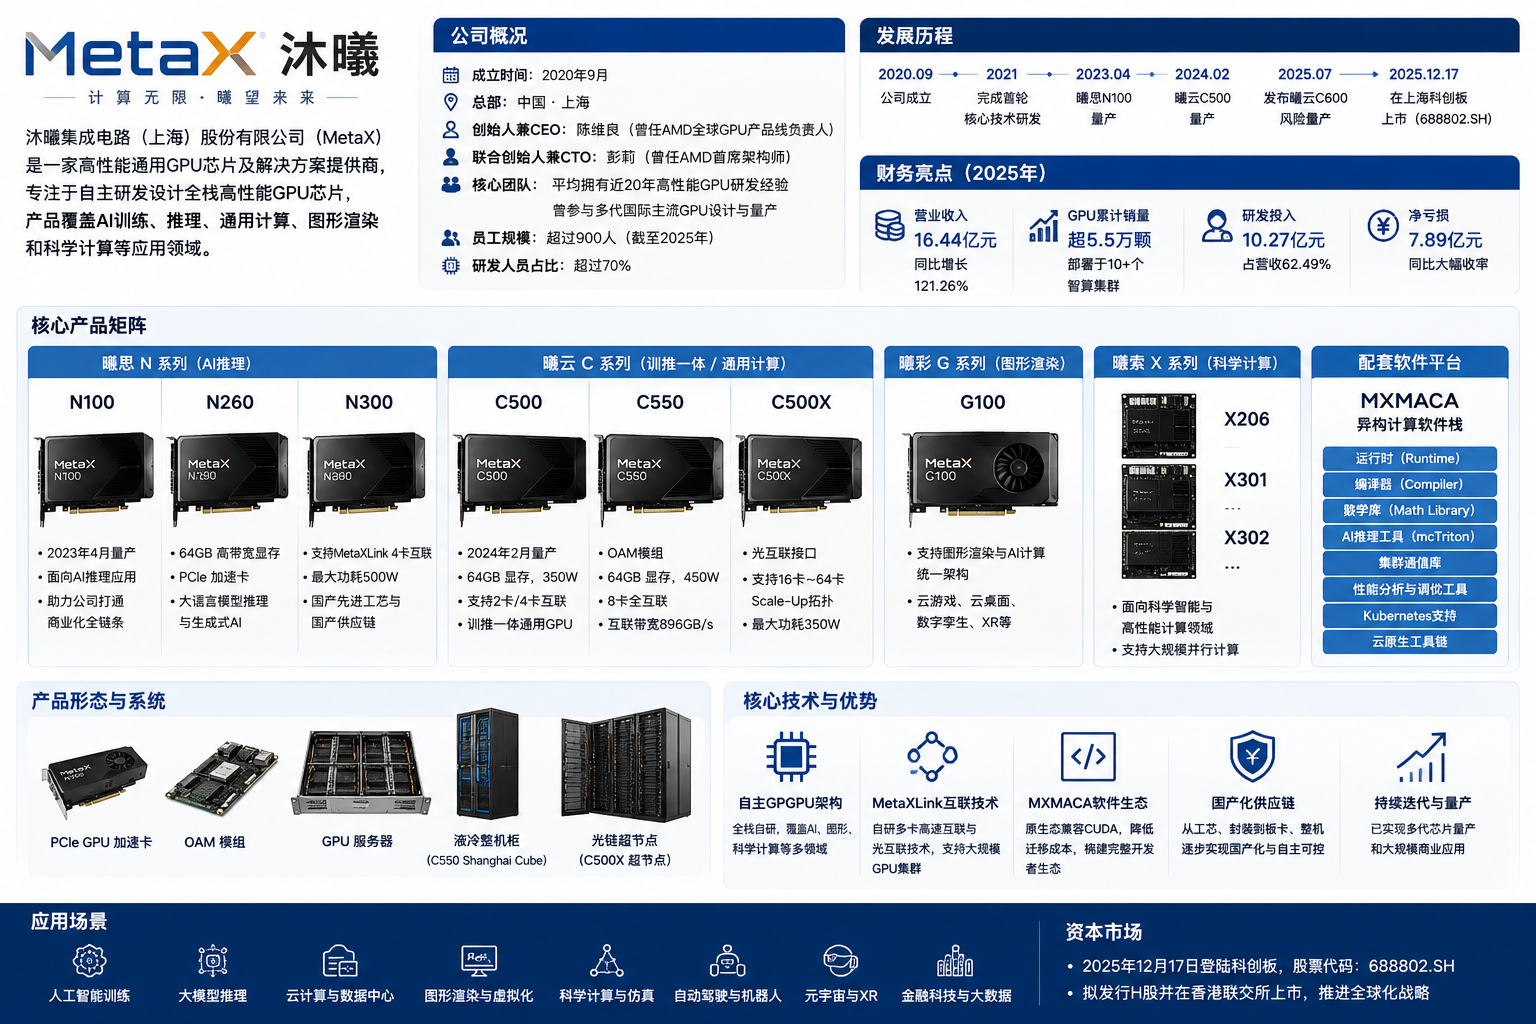
沐曦集成电路(上海)股份有限公司(MetaX) 是中国近年来发展速度较快的高性能 GPU 企业之一,主要从事 通用 GPU、AI 训练与推理芯片、图形 GPU、科学计算 GPU,以及配套软件平台和服务器系统 的研发。
与一些只做 AI 推理 ASIC 的公司不同,沐曦选择的是更接近 Nvidia 和 AMD 的路线:
开发一套通用 GPU 架构,再围绕 GPU 建立完整的软件和系统生态。
公司的目标不仅是运行神经网络,还希望覆盖:
AI 大模型训练、AI 推理、科学计算、数据处理、图形渲染、云计算以及高性能计算。
截至 2026 年,沐曦已经形成四条主要 GPU 产品线:
曦思 N 系列
曦云 C 系列
曦彩 G 系列
曦索 X 系列
同时配套自主研发的:MXMACA 软件栈。
沐曦已经于 2025 年 12 月 17 日登陆上海证券交易所科创板,
股票代码:688802.SH。
沐曦成立于 2020 年
沐曦成立于:2020 年 9 月。
总部位于上海,并在北京、南京、成都、杭州、深圳、武汉、长沙等地设有研发中心或子公司。
对于一家高性能 GPU 企业来说,2020 年成立其实非常晚。
但是沐曦一个比较特殊的地方,是创始团队并不是从零开始学习 GPU。
其核心成员中有大量拥有多年国际 GPU 研发经验的工程师。
公司表示,核心团队成员平均拥有接近 20 年高性能 GPU 产品研发经验,曾参与多代主流高性能 GPU 的设计和量产。
创始人陈维良曾长期在 AMD 工作
沐曦创始人、董事长兼 CEO 是:陈维良。
陈维良在 GPU 行业拥有近 20 年研发和管理经验,此前长期任职于 AMD。
根据沐曦官方介绍,他曾担任 AMD 多代 GPU 设计及产品线的全球负责人,并带领团队参与和完成多款高性能 GPU 的流片与量产。
这段经历对于理解沐曦非常重要。
因为沐曦的路线并不是制造一种功能非常有限的 AI ASIC。
它一开始就希望开发 真正意义上的通用 GPU。
换句话说,它希望一套 GPU 架构既能够 运行 AI,也能够 进行通用计算。甚至进一步进入 图形渲染和科学计算。
联合创始人兼 CTO 彭莉同样来自 AMD
另一位核心人物是 彭莉。
彭莉是沐曦联合创始人、CTO 和首席硬件架构师。
她同样拥有超过 20 年高性能 GPU 芯片设计经验,此前长期在 AMD 工作。
她曾担任:GFX IP 架构师、系统架构师、首席 SoC 架构师以及 SoC 技术专家等职位。
根据公司介绍,她还参与过 AMD 多芯片互联独立 GPU 解决方案和 GFX IP 架构设计。
因此沐曦从成立开始,就带有非常明显的 大型国际 GPU 公司技术团队背景。
沐曦为什么被称为“国产 GPU”公司?
例如有些企业主要开发 NPU、AI ASIC、推理芯片或者 Transformer Accelerator。
沐曦选择的路线更加复杂:GPGPU。也就是:General-Purpose Computing on Graphics Processing Units,通用 GPU 计算。
GPU 最大的特点是拥有大量并行计算单元。
这些计算单元既能够处理 矩阵运算,也能够执行 向量计算、科学计算和通用并行程序。
这就是为什么 Nvidia GPU 不仅能玩游戏,还可以训练 ChatGPT。
沐曦希望建立的也是类似的通用计算基础设施。
曦思 N 系列:从 AI 推理开始
沐曦最早商业化的重要产品线之一是 曦思 N 系列。
第一代代表产品 曦思 N100
主要针对 AI 推理。
N100 于 2023 年 4 月正式量产。
这款产品对沐曦的重要性,并不只是性能。
它实际上帮助沐曦第一次完整打通了 芯片设计 → 流片 → 封装 → 板卡 → 软件 → 服务器 → 客户部署 这一整条商业链。
对于 GPU 创业公司来说,这是非常重要的一关。
因为“芯片能点亮”和“芯片能够批量进入数据中心”完全是两件不同的事情。
曦思 N260:开始进入大模型推理
随着生成式 AI 爆发,沐曦后来推出 曦思 N260。
N260 已经明显从传统 AI 推理转向 LLM 大语言模型和生成式 AI。
N260 配备 64GB 高带宽显存
采用标准 PCIe 加速卡形式,最大功耗 225W。
官方重点应用包括:大语言模型、内容生成式 AI、数据处理和高并发推理。
这类产品真正竞争的已经不只是传统视觉推理芯片。
它开始进入 大模型 Inference 市场。
曦思 N300:进一步走向国产供应链
目前沐曦的曦思系列已经发展到 N300。
N300 继续采用沐曦自主知识产权的 GPGPU 架构,并特别强调 国产先进工艺和国产供应链。
它支持 MetaXLink 多卡互联,可实现最多 4 卡高速互联。
官方给出的最大板卡功耗达到 500W。
这说明 N 系列已经从最早的低功耗推理产品逐步向更高性能的大模型计算平台发展。
真正让沐曦进入高性能 GPU 市场的是曦云 C500
沐曦目前最重要的产品线之一是 曦云 C 系列。
其中具有里程碑意义的产品是:曦云 C500。
C500 于 2024 年 2 月正式量产。
它是一款 训推一体通用 GPU。
也就是说,同一颗 GPU 可以同时用于 AI Training 和 AI Inference。这是一个非常重要的区别。很多国产 AI 芯片最初只能做推理。
真正进入大型模型训练,对 显存容量、显存带宽、芯片互联、软件框架、通信库以及集群稳定性 都有更高要求。
曦云 C500 的主要规格
曦云 C500 是标准 PCIe 高性能 GPU 加速卡。
官方公布的核心配置包括:
64GB 高带宽显存
支持:全链路 ECC
支持:2 卡或 4 卡 GPU 互联
最大功耗:350W。
应用场景包括:大型模型训练、AI 推理、生成式 AI、数据处理和通用计算。
这也使 C500 成为沐曦真正进入 AI 数据中心 市场的关键产品。
C500 已成为沐曦收入增长的重要动力
沐曦招股书显示:
2023 年,公司训推一体 GPU 产品收入还只有约 1547 万元。
到了 2024 年,这一数字已经增长到 约 7.22 亿元。
C500 成为公司快速增长的重要动力,并进入多个人工智能公共算力平台、运营商智算平台和商业智算中心。
这说明沐曦已经完成一个非常关键的转变:从 GPU 研发公司 逐渐进入 GPU 批量交付公司。
曦云 C550:从单卡走向 8 GPU 系统
因此 GPU 竞争的核心之一正在变成 GPU 与 GPU 之间怎样连接。
沐曦推出 曦云 C550 就是针对这一问题。
C550 采用 OAM 模组,而不是普通 PCIe 板卡。
单颗 GPU 配备 64GB 高带宽显存。
通过 MetaXLink 可以实现 8 卡全互联。
官方公布的八卡互联带宽达到 896GB/s。
单模组最大功耗 450W。
这一方向非常重要。
因为现在真正决定大模型训练性能的,已经不仅仅是单颗 GPU 有多快。
更重要的是:几百颗、几千颗 GPU 能不能一起高效工作。
C500X:沐曦开始进入光互联
沐曦还推出了一款非常值得注意的产品:曦云 C500X。
C500X 最大的特点是 光互联。
它配备 MetaXLink 光互连接口,可以构建 16 卡到 64 卡 Scale-Up GPU 互联拓扑。
单卡同样拥有 64GB 高带宽显存
最大功耗 350W。
这体现了 GPU 行业一个非常重要的趋势:未来 AI 芯片竞争已经不只是 Chip vs Chip,而是 System vs System。
为什么光互联越来越重要?
假设一台 AI 服务器只有 8 张 GPU,电互联一般还可以解决。
但如果希望 16 张 GPU、32 张 GPU、64 张 GPU 像一台巨大计算机一样工作,传统铜线连接会越来越困难。
距离增加以后,会遇到 带宽、信号完整性、功耗以及布线复杂度 等问题。
光通信因此正在逐渐进入 GPU Scale-Up Network。
沐曦推出 C500X,很大程度上也是在提前布局这个方向。
曦云 C600:下一代全国产工艺 GPU
2025 年,沐曦又发布了:曦云 C600。这是公司非常重要的一代产品。
C600 基于自主知识产权 GPGPU 架构,并强调采用 国产先进工艺和国产供应链。
根据沐曦 2025 年年报,公司在 2025 年 7 月 WAIC 上发布 C600,2025 年末已经进入风险量产阶段。
公司当时预计在 2026 年上半年 进入量产销售。
截至 2026 年 8 月,C600 已经出现在沐曦官方完整产品和服务器产品线中。
C600 的意义不仅是性能提升。它更加重要的一点是 供应链自主化。
在当前国际半导体供应链环境下,这对中国 GPU 企业尤其重要。
沐曦不仅做 AI GPU,还要做真正的图形 GPU
沐曦还有一个产品系列:曦彩 G 系列。
代表产品:曦彩 G100。
它针对 图形渲染、视频处理、云桌面、云游戏、数字孪生、XR 和元宇宙 等应用。
沐曦把它定位为:支持图形渲染与 AI 计算统一架构的国产全功能 GPU。这点非常值得注意。
因为“AI Accelerator”和“真正的 GPU”之间其实存在巨大技术差距。
训练一个 AI 模型并不要求芯片支持完整 Graphics Pipeline。
而真正的 GPU 还需要支持:顶点处理、Rasterization、Texture、Shader、显示输出以及各种图形 API。
所以一家公司同时进入 AI + Graphics ,意味着其目标明显更加接近 Nvidia 和 AMD。
曦索 X 系列:科学智能与科学计算
截至 2026 年,沐曦又增加了一条 曦索 X 系列。
目前包括:
X206
X301
X302 等产品。
这条产品线主要针对 科学智能和高性能计算。
因此沐曦目前已经形成四个比较清楚的方向:
N 系列:AI 推理
C 系列:训练 + 推理 + 通用计算
G 系列:图形渲染
X 系列:科学计算与科学智能。
这已经非常接近一家完整 GPU 公司的产品布局。
MXMACA:沐曦真正的关键可能不是 GPU,而是软件
高性能 GPU 行业最难的地方之一其实不是芯片。而是 软件生态。
Nvidia 最大的护城河并不仅仅是 GPU,而是 CUDA。CUDA 已经存在二十多年。
大量 PyTorch、TensorFlow、AI 模型、科学计算软件、HPC 程序 ,全部围绕 CUDA 构建。
如果国产 GPU 要求开发者把所有 CUDA 程序全部重写,那么迁移成本会非常高。
因此沐曦开发了一套自己的软件平台:MXMACA。
MXMACA 的目标是降低 CUDA 迁移成本
沐曦将 MXMACA 定位为:异构计算软件平台。
公司强调其软件栈兼容主流 GPU 计算生态,并在年报中将其描述为:“原生态兼容 CUDA”。
这里需要特别注意:这并不意味着 MXMACA 就是 CUDA,也不能简单理解为所有 CUDA 软件都一定可以不做任何修改直接运行。
更加准确的理解应该是:沐曦希望尽可能降低 CUDA 应用迁移到沐曦 GPU 的成本。
这对于国产 GPU 是否能够真正进入数据中心至关重要。
MXMACA 已经形成完整开发工具链
沐曦目前已经建立了相当完整的开发者软件体系。
其中包括:Runtime、编译器、数学库、AI 推理工具、GPU 运维工具、Kubernetes 支持、云原生工具、性能分析工具 以及 mcTriton 等开发工具。
截至 2026 年 8 月,沐曦开发者网站仍在持续发布 MXMACA 新版本以及 Kubernetes、AI 推理和 Triton 等相关文档。这一点对长期竞争力非常重要。
因为最终客户并不只是购买 一颗芯片。
客户实际上购买的是:GPU + Driver + Compiler + Library + Framework + Cluster Software。
沐曦已经开始建设 GPU 超节点
随着 C550 和 C500X 出现,沐曦的产品也从 GPU 芯片 逐渐扩大到 GPU 加速卡、GPU 服务器、GPU 工作站以及 GPU 超节点。
目前公司已经推出或展示:
曦云 C550 Shanghai Cube 液冷整机柜
曦云 C500X 光链超节点
以及 C550 3D Mesh 超节点。
这说明沐曦正在走 Nvidia 近年来非常明显的一条路线:从 卖 GPU 升级到 卖整个 AI 计算系统。
为什么“超节点”会成为 AI 芯片的新战场?
传统服务器时代,一台机器有 1 颗 CPU 或 2 颗 CPU。
但大模型时代可能需要 8 张 GPU、64 张 GPU、数百张 GPU 共同运行一个模型。
于是一个新的计算机形态出现:Supernode。
在超节点中,大量 GPU 通过高速互联连接,使软件尽量把几十颗 GPU 看成一个巨型计算资源池。
Nvidia 在做 NVLink + NVSwitch + GB200 NVL72。
中国 GPU 公司同样必须解决这一问题。
因此 MetaXLink 很可能成为观察沐曦未来竞争力的重要技术之一。
沐曦 2025 年收入已经达到 16.44 亿元
从商业化速度来看,沐曦近年来增长非常快。
公司 2025 年实现营业收入:16.44 亿元人民币。
同比增长:121.26%。
其中训推一体 GPU 销量达到约:3.36 万颗。
同比增长约:147%。
同比增长超过:800%。
截至 2025 年底,公司 GPU 累计销量已经超过:5.5 万颗。
产品部署于超过:10 个智算集群。
对于一家 2020 年才成立的 GPU 公司来说,这个商业化速度相当快。
但沐曦目前仍然亏损
收入高速增长并不意味着沐曦已经盈利。
2025 年,公司归属于上市公司股东的净亏损约 7.89 亿元人民币。不过相比 2024 年,亏损已经明显收窄。
最大原因之一就是 GPU 是一个极度烧钱的行业。仅 2025 年,沐曦研发投入就达到 约 10.27 亿元。研发投入相当于营业收入的 62.49%。
而且 GPU 不是设计一次就结束。
公司必须持续开发:下一代 GPU、驱动、编译器、AI Library、高速互联以及整套软件生态。
因此短期持续高研发支出几乎不可避免。
沐曦研发人员占比超过七成
截至 2025 年底,沐曦拥有 675 名研发人员。约占公司员工总数 73%。其中超过 70% 的研发人员拥有硕士及以上学历。
公司还表示,在成立后的五年内完成了 3 颗主力芯片的一次性流片量产。
这也是为什么沐曦是一家非常典型的 研发驱动型半导体企业。
沐曦已经登陆科创板
沐曦发展过程中一个重要里程碑发生在 2025 年 12 月 17 日,公司正式在上海证券交易所 科创板上市。
证券简称:沐曦股份
股票代码:688802。
IPO 发行价为:104.66 元人民币/股
发行数量:4010 万股。
实际募集资金总额约:41.97 亿元人民币。
对于需要持续投入巨额研发资金的 GPU 公司而言,登陆资本市场显然非常重要。
沐曦还准备赴香港上市
沐曦的资本市场计划并没有停在上海。
2026 年 6 月 12 日,公司董事会审议通过了发行 H 股并申请 香港联合交易所主板上市 的相关议案。
公司表示,这一计划有助于进一步推进全球化战略和提升公司竞争力。
截至目前,这仍然属于 拟发行并上市计划 ,而不是已经完成的香港 IPO。
如果未来 H 股上市成功,沐曦将形成 上海 A 股 + 香港 H 股 的资本市场布局。
沐曦与摩尔线程有什么不同?
中国国产 GPU 市场目前最容易被放在一起比较的两家公司就是:沐曦 和 摩尔线程。
两家公司都希望做完整 GPU,但发展重点并不完全一样。
摩尔线程从一开始就非常强调 图形、AI、视频和科学计算,统一 GPU 架构。
随着曦彩 G100 出现,沐曦才进一步进入 完整图形 GPU。
因此从商业收入来看,沐曦目前最核心的动力仍然来自 数据中心 AI GPU。
沐曦与壁仞科技有什么不同?
壁仞科技同样主要瞄准 高性能 GPGPU 和 AI 数据中心。因此在商业定位上,壁仞和沐曦其实更加接近。
两家公司都试图解决:AI Training、Inference、高性能计算和大型 GPU 集群。
区别更多体现在 芯片架构、供应链路线、软件生态和产品商业化节奏。
随着国产 GPU 进入大规模部署阶段,未来真正决定胜负的已经越来越不是 “谁发布的 TOPS 更高”,而是 谁能够稳定出货、谁的软件更成熟、谁能建立大型集群。
沐曦与 Nvidia 最大的差距仍然是 CUDA
无论国产 GPU 芯片性能提高多快,一个巨大现实仍然存在:Nvidia CUDA。
CUDA 已经形成一个规模极大的开发生态:从 PyTorch 到 TensorFlow,从 LLM Training 到 HPC,大量软件已经深度依赖 Nvidia。
沐曦能够做出性能优秀的 GPU 只是第一步。
真正困难的是让 开发者、模型公司、云平台和数据中心 愿意迁移。
因此 MXMACA 的长期成熟程度,很可能比某一代 GPU 的单项峰值算力更加重要。
国产供应链也是重大挑战
它需要:先进制程、HBM、高级封装、PCB、高速互联、服务器、电源以及散热系统。任何一个环节受到限制,都可能影响产品交付。
因此 C600 和 N300 特别强调 国产先进工艺和国产供应链。
这既是产品卖点,也是中国 GPU 企业必须解决的现实问题。
沐曦最大的优势是什么?
沐曦目前比较明显的优势首先是 完整 GPU 团队。创始团队拥有多年 AMD 高性能 GPU 产品经验。
第二个优势是 已经实现规模商业化。2025 年营业收入达到 16.44 亿元,累计 GPU 销量超过 5.5 万颗。
第三个优势是 不是单一 AI ASIC。公司同时布局 训练、推理、通用计算、图形渲染和科学计算。
第四个优势是 MXMACA 软件栈。它试图降低现有 GPU 和 CUDA 用户的迁移成本。
第五个优势是 MetaXLink。从 4 GPU、8 GPU,一直到 64 GPU 光互联,沐曦正在向大型 AI 系统扩展。
第六个优势则是 资本实力。登陆科创板以后,公司拥有更加稳定的融资渠道。
沐曦面临的最大风险
沐曦最大的风险仍然是竞争。
国际上有:Nvidia,AMD 以及越来越多云计算公司自研 AI 芯片。
中国市场还有 华为昇腾、寒武纪、摩尔线程、壁仞科技、天数智芯等竞争者。
第二个风险是 软件生态。
GPU 不只是硬件竞争。一个优秀的软件开发环境可能需要十年以上持续积累。
第三个风险是 供应链。先进工艺、HBM 和先进封装仍然是整个高性能 GPU 行业的关键瓶颈。
第四个风险则是 持续亏损和高研发投入。即使销售收入高速增长,公司仍需要不断投入下一代芯片。
这也是 GPU 行业极高技术门槛和资本门槛的体现。
为什么沐曦值得关注?
而沐曦非常明确地选择:全栈高性能 GPU。
它希望覆盖的不是单独一个 AI 推理场景,而是一整套:
AI Training + AI Inference + General Computing + Graphics + Scientific Computing 平台。
这条路线非常难。但一旦成功,市场空间也非常大。
总结
它最特别的地方并不是发布了一颗国产 AI 芯片,而是试图建立 中国自己的完整 GPU 平台。
从最初的 曦思 N100 到 N260、N300,再到 曦云 C500、C550、C500X、C600 以及 曦彩 G100 和 曦索 X 系列。
沐曦已经逐渐形成:AI 推理 + AI 训练 + 通用计算 + 图形渲染 + 科学计算 的完整产品布局。
与此同时,公司正在把竞争范围从 单颗 GPU,扩大到 GPU Server、GPU Supernode 和大型 AI Cluster。
而从长期来看,真正决定沐曦能不能成为一家世界级 GPU 企业的,可能并不是某一颗芯片的峰值算力。
更加重要的是三个问题:
MXMACA 能不能真正建立成熟的软件生态?
国产供应链能不能稳定支持一代又一代高性能 GPU?
如果这三个问题能够逐渐解决,沐曦就不再只是一家“国产 AI 芯片公司”。
它真正挑战的将是一个更加困难的目标:建立一套独立、完整、能够长期演进的 GPU 计算生态。